
Windows下IntelliJ IDEA中调试Spark Standalone
参考:http://dataknocker.github.io/2014/11/12/idea%E4%B8%8Adebug-spark-standalone/
转载请注明来自:http://www.cnblogs.com/yuananyun/p/4265706.html
研究Spark源码也有一段时间了,一直都是直接看代码,没有调试。虽然带着思路去看源代码已经能够帮助我们去了解Spark了;但是很多细节从字面上是看不出来的,如果我能够通过运行时调试验证我的想法,或者能够查看某个类中变量和结构在运行时是什么岂不是更好?好,我们今天就来实现这个想法。
动手之前,我已经在网上找了关于spark调试的方法,要么就是local模式的,要么就是写的很模糊。spark local模式和其他分布式模式有很大不同,虽然可以在local模式下进行debug,但有很多东西只有在分布式模式下才有用,本文主要是介绍在Spark Standalone模式下如何调试Driver、Master、Worker和Executor(yarn模式比较复杂,还需要结合yarn的debug模式才能搞定,但研究standalone已经可以搞清楚spark的大部分原理了)。
一、主要思想
1、spark-class: 像Master、Worker、Driver都是通过spark-class脚本进行启动各自的jvm(Driver其实是间接由spark-class启动,提交程序时以spark-class启动SparkSubmit,然后SparkSubmit以反射的形式调用Driver的main方法从而实现driver的运行)。
spark-class中设置了各jvm的参数,所以可以在这些参数中加入debug的相关参数。
2、Executor即CoarseGrainedExecutorBackend的参数在spark-class脚本中修改没用,因为其不是通过spark-class启动的,其是被ExecutorRunner启动,在buildCommandSeq->buildJavaOpts对相应参数进行设置,比如固定MaxPermSize=128m等。可以在SparkConf中设置spark.executor.extraJavaOptions参数。
二、前提要求
本文假定你已经掌握或完成了以下内容:
1、已经完成了一个Spark Standalone的集群(大小不重要,能用就行,不需要hdfs的支持),并且能够顺利启动和运行
2、IntelliJ IDEA、Scala插件、Java JDK、Scala SDK都已经安装和配置完成
3、拥有java开发基础
三、新建测试项目
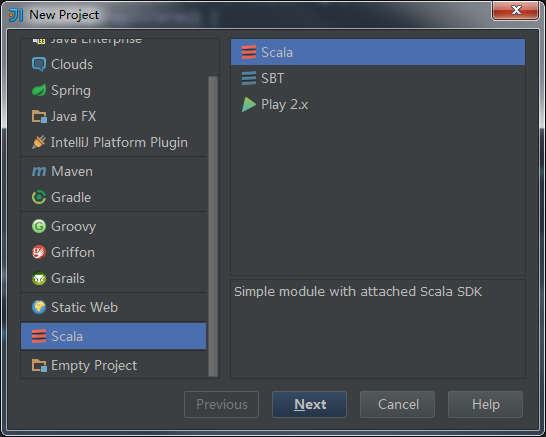
启动IntelliJ IDEA,选择New Project,然后选择Scala,点击下一步
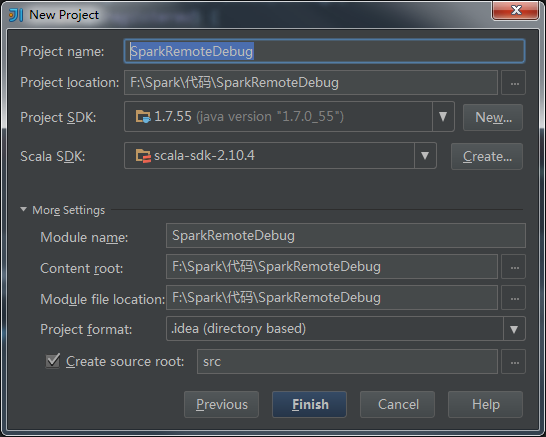
输入项目名称和参数继续下一步:
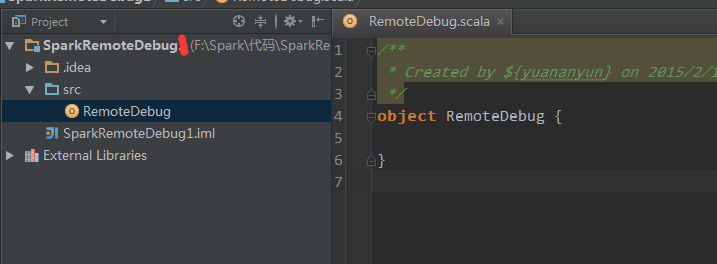
在src目录下新建一个scala类对象:RemoteDebug,我们将用这个类来做测试。
输入以下代码(相信你看出来了,就是官网的计算π的例子):
object RemoteDebug {

  def main(args: Array[String]) {

    val conf = new SparkConf().setAppName("Spark Pi").setMaster("spark://Master:7077")

.setJars(List("F:\\Spark\\SparkRemoteDebug\\out\\artifacts\\SparkRemoteDebug_jar\\SparkRemoteDebug.jar"))
    val spark = new SparkContext(conf)

    val slices = if (args.length > 0) args(0).toInt else 2

    val n = 100000 * slices

    val count = spark.parallelize(1 to n, slices).map { i =>

      val x = random * 2 - 1

      val y = random * 2 - 1

      if (x * x + y * y < 1) 1 else 0

    }.reduce(_ + _)

    println("Pi is roughly " + 4.0 * count / n)

    spark.stop()

  }

}
注意以下两点:
1、”setMaster("spark://Master:7077") ”不能忘,因为我们是要在Standalone集群上运行的,“Master“就是master所在的主机名,如果你没有在本机配置“Master”指向集群中的master机器IP的话,请直接使用IP,如:spark://192.168.1.103:7070。
2、”setJars(List("F:\\Spark\\SparkRemoteDebug\\out\\artifacts\\SparkRemoteDebug_jar\\SparkRemoteDebug.jar"))“,告诉Spark 集群我们要提交的作业的代码在哪里,也就是我们包含我们程序的Jar包的路径,记住路径中千万别包含中文,不然会出错(血的教训)。
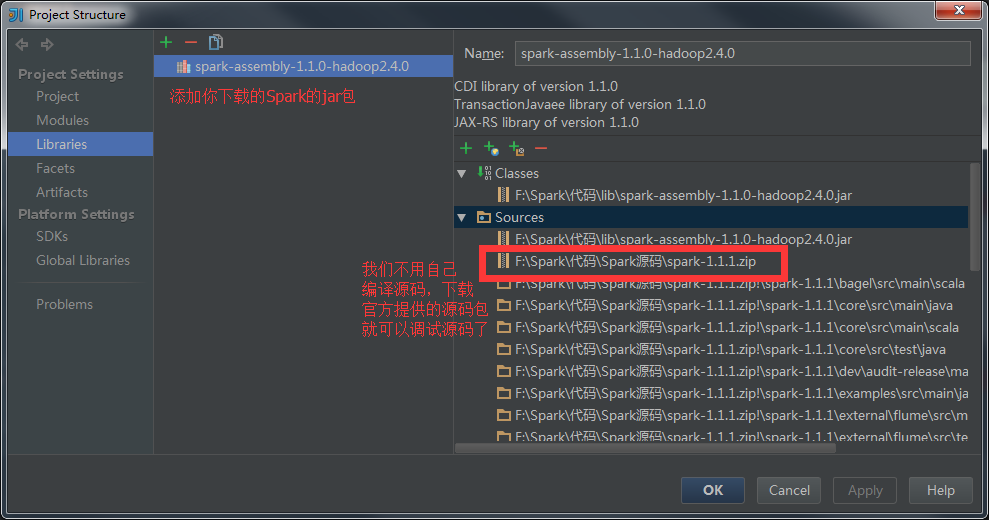
首先给项目添加Spark的依赖jar以及源码zip,选择项目,按下F4,就会弹出下面的配置窗体:
接下来配置我们的程序打包:
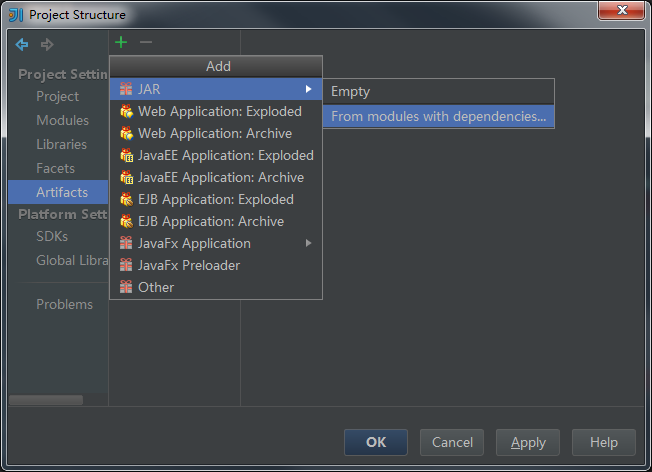
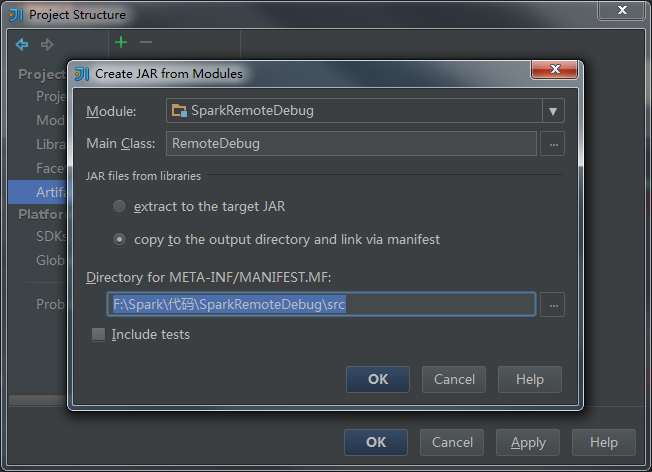
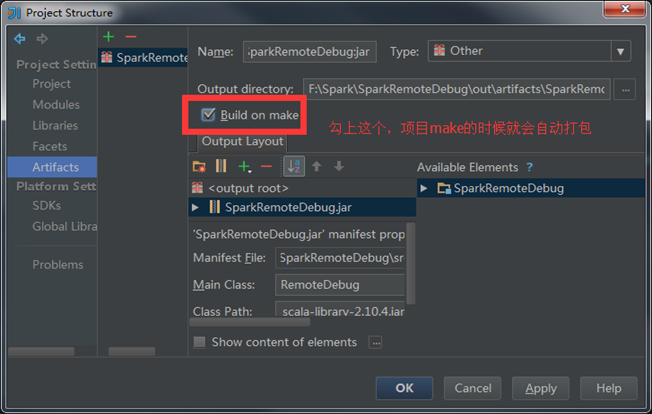
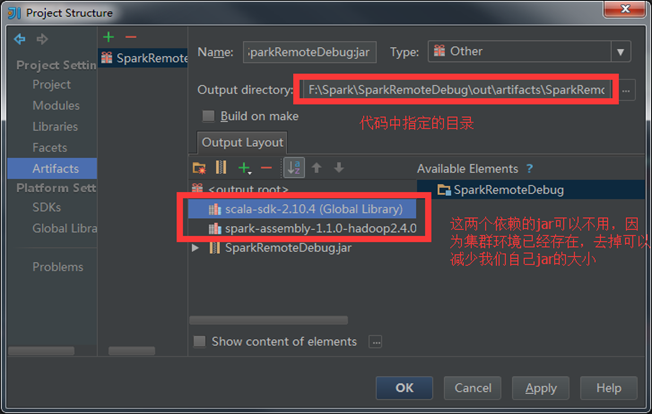
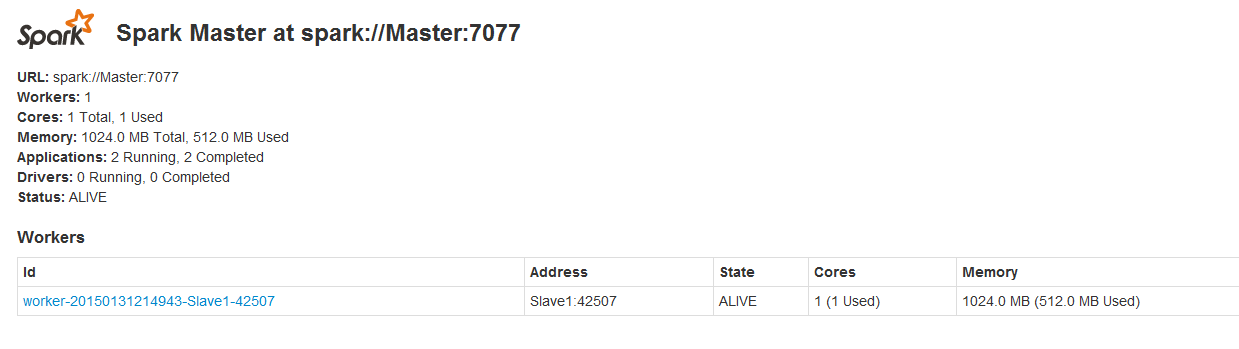
好,让我们来看看我们的测试结果。启动Spark集群成功后,你应该可以看到SparkUI界面(以下截图是我的环境):
为我们的程序添加一个启动项:
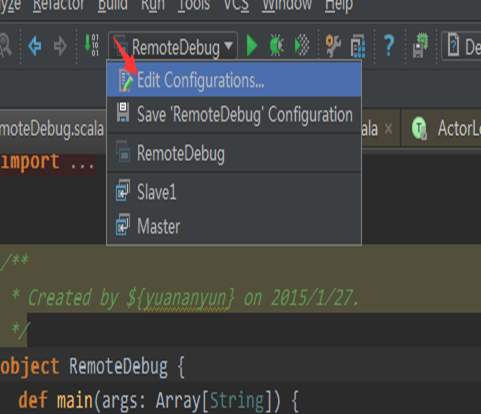
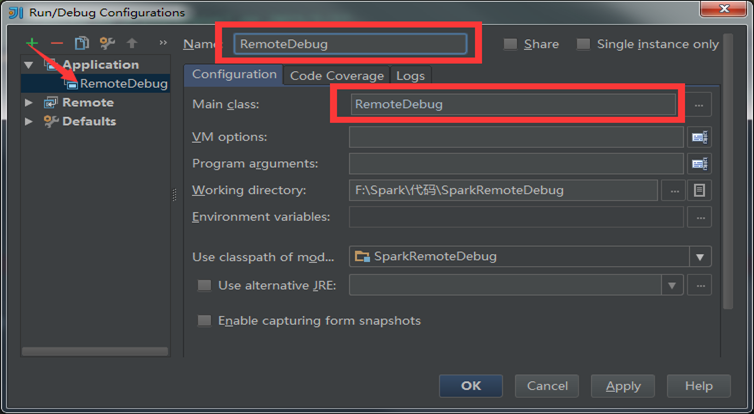
好,点击旁边的绿色小三角启动按钮,启动我们的程序,查看运行结果:
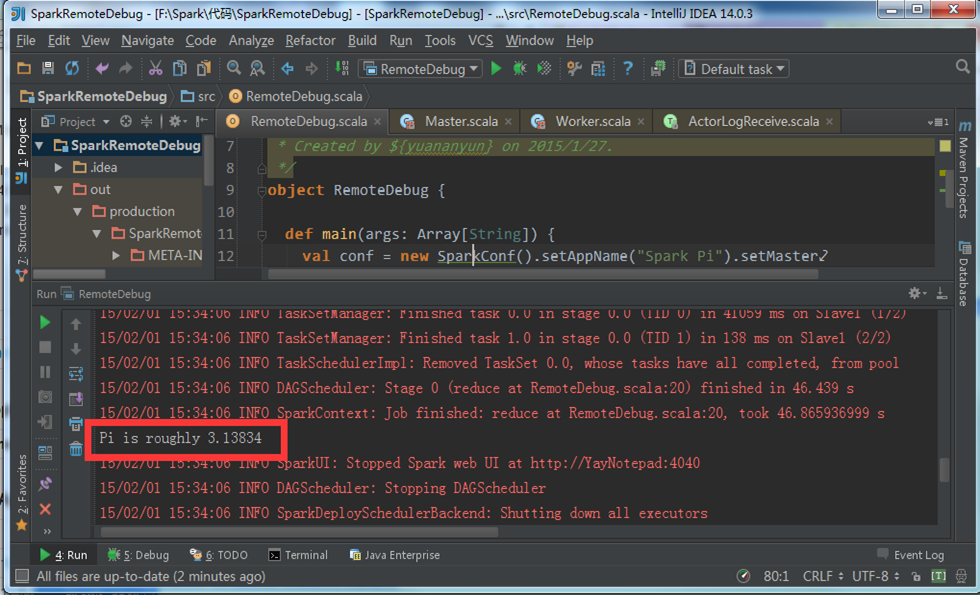
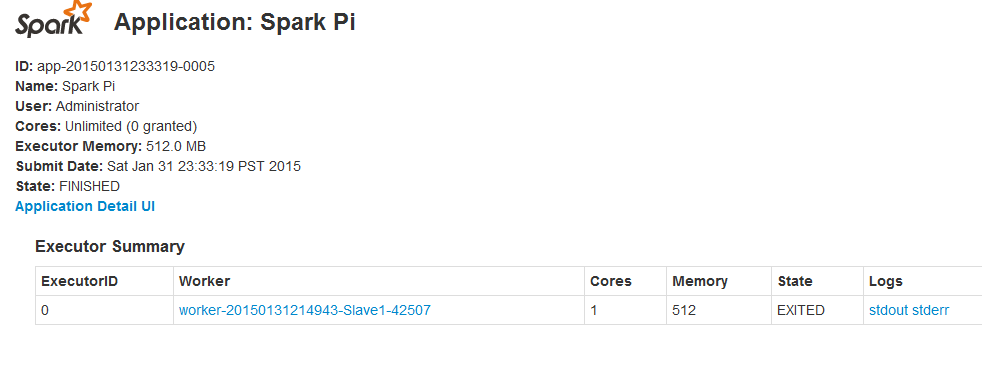
至此,我们的程序已经能够正常在集群上运行,并返回结果了,下一步我们就来看看怎么调试Driver、Master和Worker以及Executor。
三、调试Spark Standalone
1、修改Master配置。
首先,我们停止我们的spark Cluster,因为我们需要修改一一些参数,打开Master所在机器的spark-class文件进行编辑,记得先备份哦
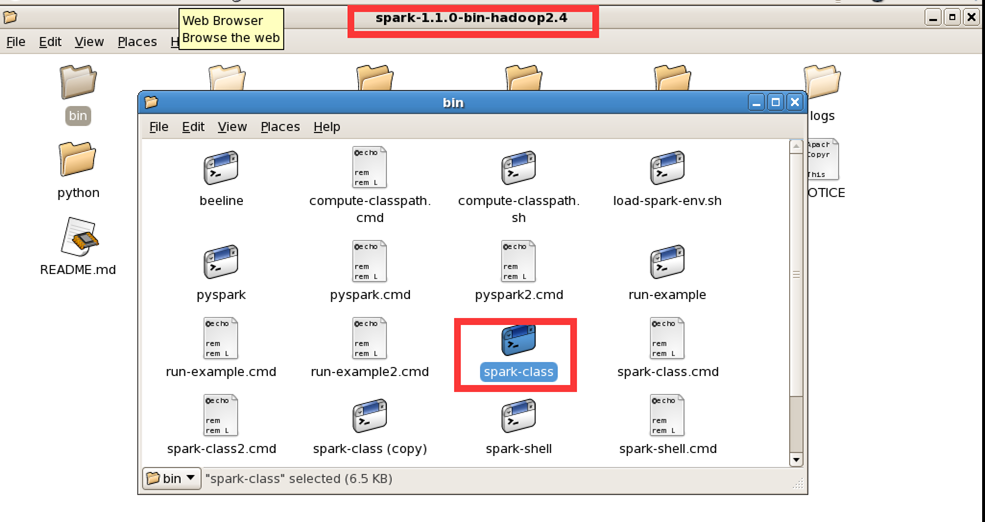
找到并修改为以下内容:
找到以下内容:

# Master, Worker, and HistoryServer use SPARK_DAEMON_JAVA_OPTS (and specific opts) + SPARK_DAEMON_MEMORY.

  'org.apache.spark.deploy.master.Master')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_MASTER_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.worker.Worker')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_WORKER_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.history.HistoryServer')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_HISTORY_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

修改为:

  # Master, Worker, and HistoryServer use SPARK_DAEMON_JAVA_OPTS (and specific opts) + SPARK_DAEMON_MEMORY.

  'org.apache.spark.deploy.master.Master')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_MASTER_OPTS -Xdebug -Xrunjdwp:transport=dt_socket,address=8002,server=y,suspend=n"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.worker.Worker')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_WORKER_OPTS -Xdebug -Xrunjdwp:transport=dt_socket,address=8003,server=y,suspend=n"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.history.HistoryServer')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_HISTORY_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;
2、修改Worker配置
同理(文件位置参考Master机器),找到以下内容并修改:
找到以下内容:

# Master, Worker, and HistoryServer use SPARK_DAEMON_JAVA_OPTS (and specific opts) + SPARK_DAEMON_MEMORY.

  'org.apache.spark.deploy.master.Master')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_MASTER_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.worker.Worker')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_WORKER_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.history.HistoryServer')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_HISTORY_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

修改为:

PARK_DAEMON_MEMORY.

  'org.apache.spark.deploy.master.Master')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_MASTER_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.worker.Worker')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_WORKER_OPTS -Xdebug -Xrunjdwp:transport=dt_socket,address=8009,server=y,suspend=n"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;

  'org.apache.spark.deploy.history.HistoryServer')

    OUR_JAVA_OPTS="$SPARK_DAEMON_JAVA_OPTS $SPARK_HISTORY_OPTS"

    OUR_JAVA_MEM=${SPARK_DAEMON_MEMORY:-$DEFAULT_MEM}

    ;;
3、重新启动Spark Cluster
查看Master和Worker的日志
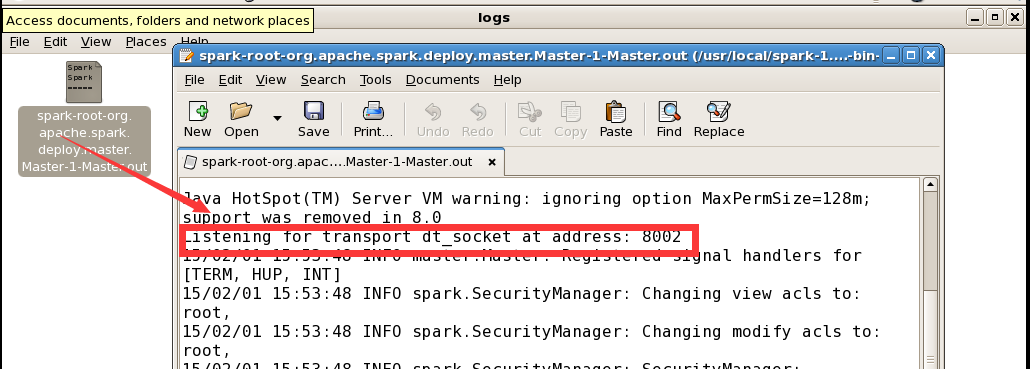

好,可以看到,我们的Master和Worker都已经启动成功,并且按照我们的配置监听各自的端口,下面我们就通过程序来调试它们。
4、开启调试Master和Worker
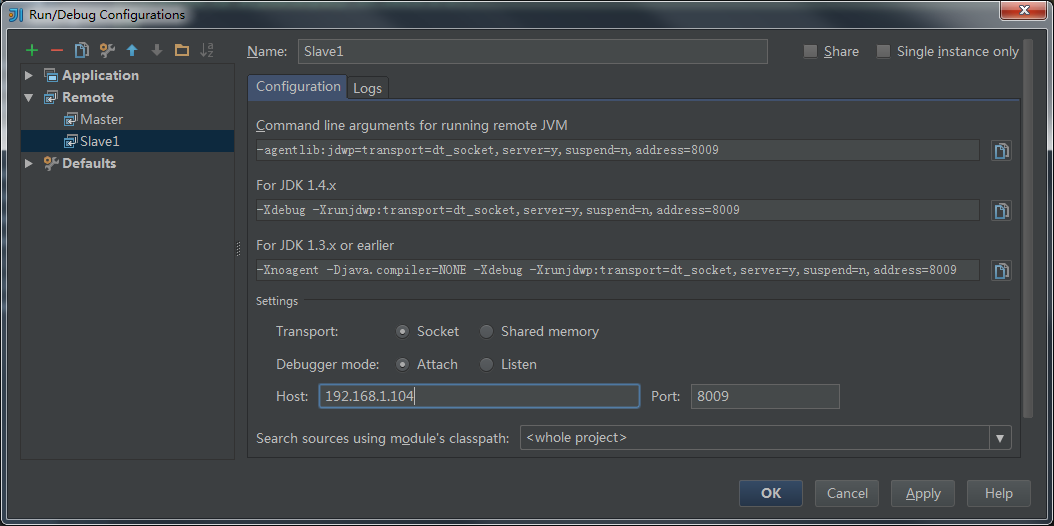
回到我们的idea中,添加两个Remote启动项
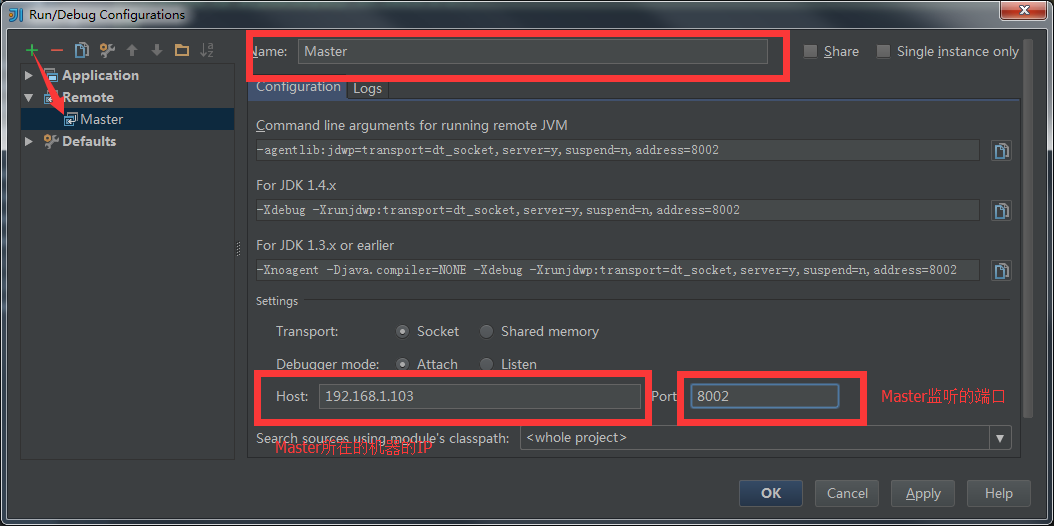
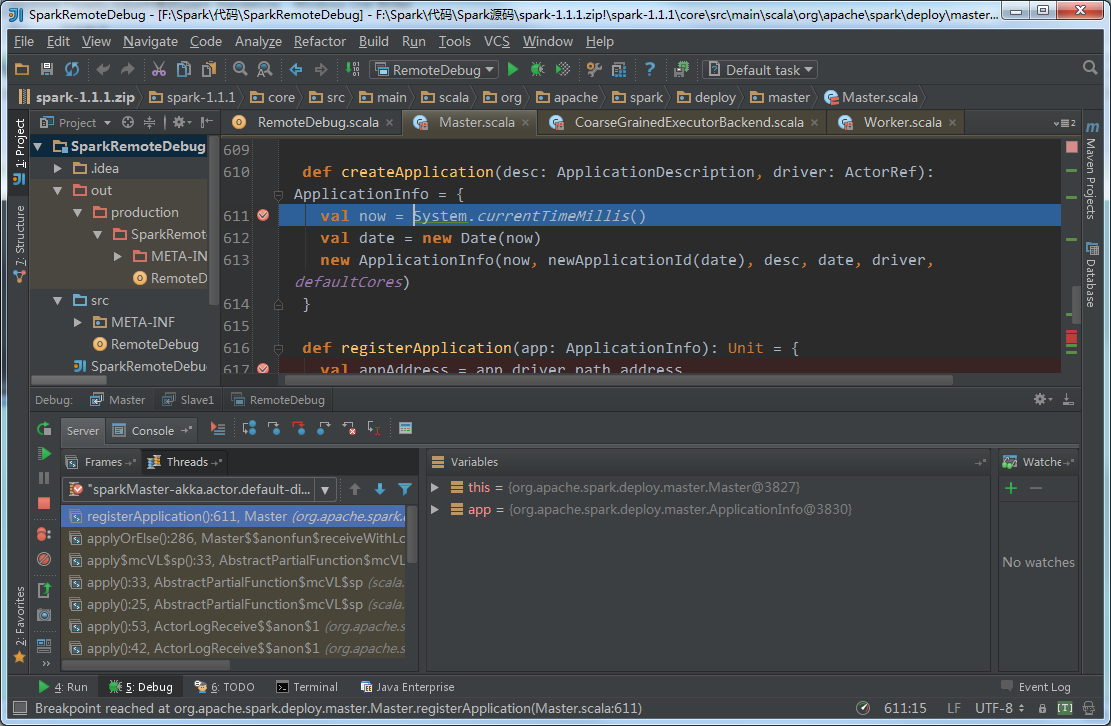
重要的时刻来了,我们先启动调试Master,并加上属于Master代码的断点:
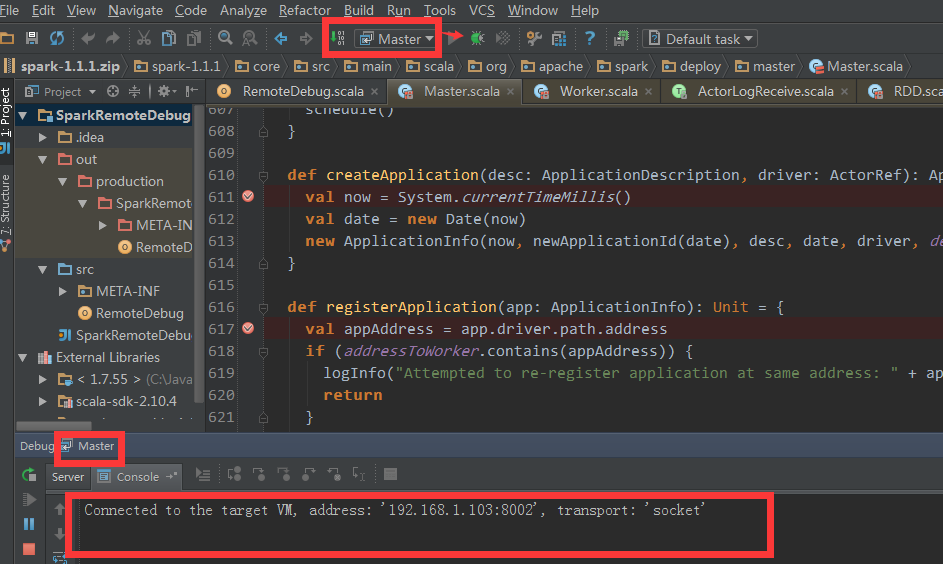
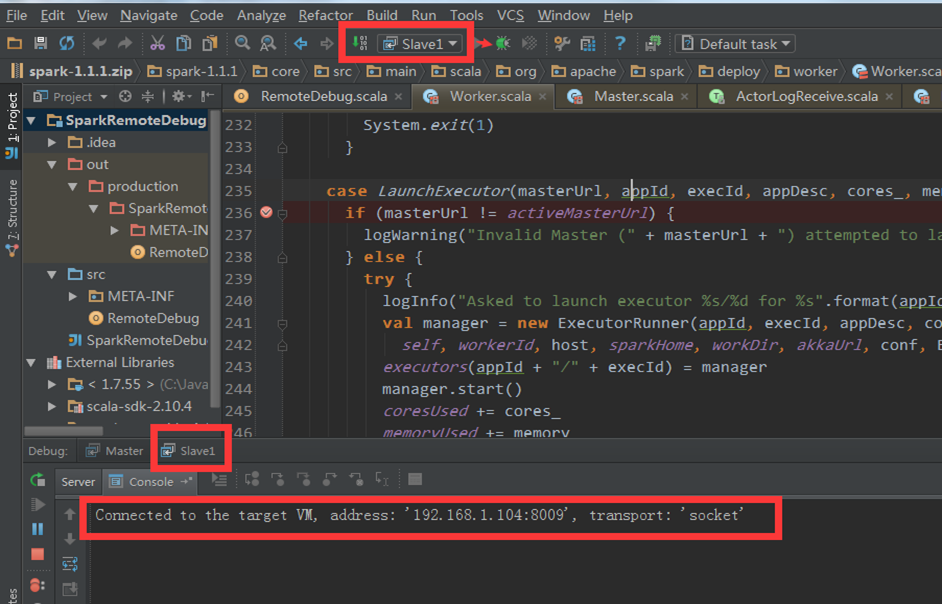
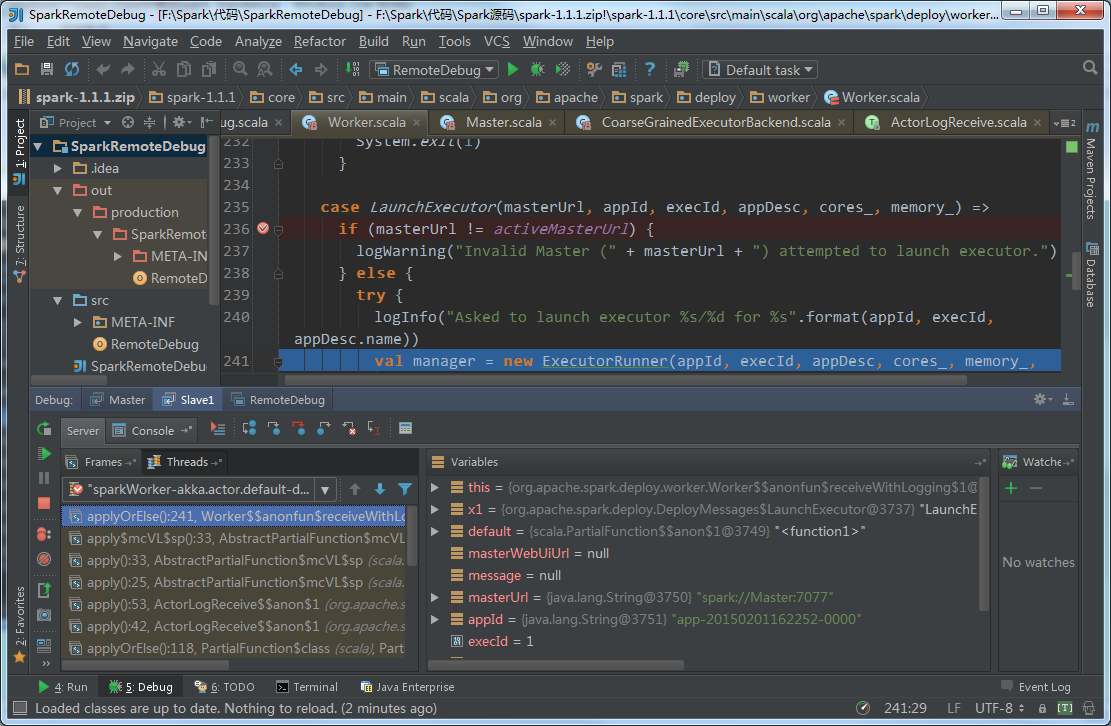
可以看到,idea已经连接到了我们Cluster中的Master机器的8002端口,而这正是我们在集群中配置的端口。同理启动Slave1(Worker)
为了能够调试Executor,我们得修改一下我们前面写的代码,修改后的代码如下:
def main(args: Array[String]) {

    val conf = new SparkConf().setAppName("Spark Pi").setMaster("spark://Master:7077")

      .setJars(List("F:\\Spark\\SparkRemoteDebug\\out\\artifacts\\SparkRemoteDebug_jar\\SparkRemoteDebug.jar"))

      .set("spark.executor.extraJavaOptions", "-Xdebug -Xrunjdwp:transport=dt_socket,address=8005,server=y,suspend=n")

    println("sleep begin.")

    Thread.sleep(10000) //等待10s,让有足够时间启动driver的remote debug

    println("sleep end.")

    val spark = new SparkContext(conf)

    val slices = if (args.length > 0) args(0).toInt else 2

    val n = 100000 * slices

    val count = spark.parallelize(1 to n, slices).map { i =>

      val x = random * 2 - 1

      val y = random * 2 - 1

      if (x * x + y * y < 1) 1 else 0

    }.reduce(_ + _)

    println("Pi is roughly " + 4.0 * count / n)

    spark.stop()

  }
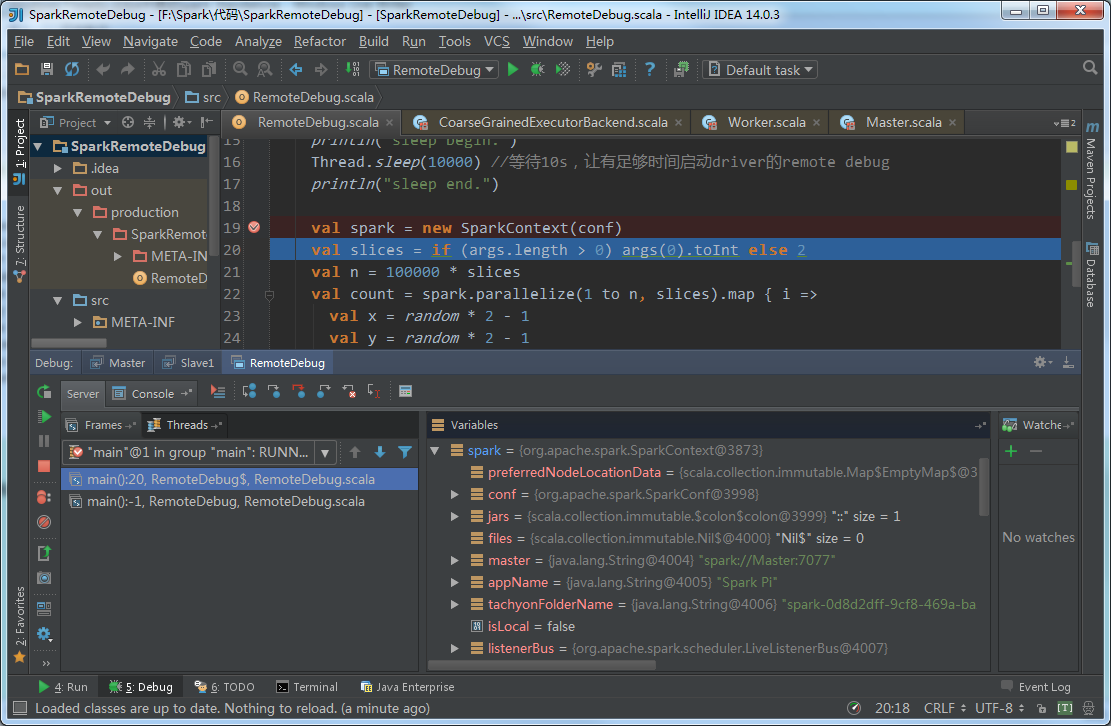
最后,我们来测试一下我们的成果:
Driver:
Master:
Worker:
Executor(CoarseGrainedExecutorBackend)是运行在Worker上的另一个JVM进程,貌似我这次实验并没有进入断点,等哪天找到方法,再补上。
Windows下IntelliJ IDEA中调试Spark Standalone的更多相关文章
- Windows下IntelliJ IDEA中运行Spark Standalone
ZHUAN http://www.cnblogs.com/one--way/archive/2016/08/29/5818989.html http://www.cnblogs.com/one--wa ...
- windows 下使用 mingw编译器 调试时 无法跟进源码
windows 下使用 mingw编译器 调试时 无法跟进源码 最近在公司使用QT 开发,官方在线下载的 安装的QT mingw 都是没有debug版本的 由于没有debug版本动态库 所以你调试的时 ...
- Windows下Git Bash中VIM打开文件中文乱码
Windows下Git Bash中VIM打开文件中文乱码,解决方法是: 步骤一 admin@DESKTOP-O99620V MINGW64 /d/项目GGE/Hard_for_GGE (master) ...
- 在编译器中调试spark程序处理
在IDEA中调试spark程序会报错 18/05/16 07:33:51 WARN NativeCodeLoader: Unable to load native-hadoop library for ...
- (二)win7下用Intelij IDEA 远程调试spark standalone 集群
关于这个spark的环境搭建了好久,踩了一堆坑,今天 环境: WIN7笔记本 spark 集群(4个虚拟机搭建的) Intelij IDEA15 scala-2.10.4 java-1.7.0 版本 ...
- windows下Idea结合maven开发spark和本地调试
本人的开发环境: 1.虚拟机centos 6.5 2.jdk 1.8 3.spark2.2.0 4.scala 2.11.8 5.maven 3.5.2 在开发和搭环境时必须注意版本兼容的问题 ...
- windows下IntelliJ IDEA搭建kafka源码环境
于kafka核心原理的资料,网上有很多,但是如果不自己研究其源码,永远是知其然而不知所以然.下面就来演示如何在windows环境下来编译kafka源码,并通过IntelliJ IDEA开发工具搭建ka ...
- windows下的用户态调试的底层与上层实现
操作系统:windows XP 调试器通过CreateProcess传入带有DEBUG_PROCESS和DEBUG_ONLY_THIS_PROCESS的dwCreationFlags创建被调试进程.这 ...
- 在 Linux/windows下 命令行中使用和执行 PHP 代码[交互式php]
[注释]在ubuntu下,升级php到7.1版本,虽然提示的是Interactive mode enabled, 但实际上可以直接书写命令,和interactive shell效果一样. 一:wind ...
随机推荐
- python自学之第一章——列表(一)
1.列表是什么? 列表[list]:列表是由一系列特定顺序排列的元素组成. 列表由[]表示 eg: a = ['jackal','jax';'jack','jeef','jacky'] print(a ...
- 基于visual studio 2017 以及cubemx 搭建stm32的开发环境(2)
主要解决 vs2017中,printf无法打印数据的问题. 在keil环境下正常使用printf功能,但是以下的重定向代码在vs2017下使用不了: #ifdef __GNUC__ /* With G ...
- 中国大学MOOC-JAVA学习(浙大翁恺)—— 温度转换
import java.util.Scanner; public class Main { public static void main(String[] args) { // TODO Auto- ...
- .NET core 项目部署在windows 服务器方法以及iis 访问报 500.19错误的解决办法
将本地发布的服务本地运行没问题,发布上云windows 服务器就报 500.19 0x8007000d 是因为云服务器没有安装.net core相关的插件,比如.NET CORE sdk等,请按照该文 ...
- spark submit参数及调优(转载)
spark submit参数介绍 你可以通过spark-submit --help或者spark-shell --help来查看这些参数. 使用格式: ./bin/spark-submit \ -- ...
- GBDT为什么不能并行,XGBoost却可以
传统的GBDT是以CART作为基分类器,xgboost还支持线性分类器,这个时候XGBOOST相当于带L1和L2正则化的逻辑斯蒂回归(分类问题)或者线性回归(回归问题).传统的GBDT在优化的hih只 ...
- bootstrap的Alerts中 可以放置p标签 设置 align="center" 用来设置文本居中
效果
- Flask 路由相关操作
URL Route URL 后接 / 作为目录级访问 URL 后不接 / 作为文件级访问 from flask import Flask app = Flask(__name__) @app.rout ...
- 「Leetcode」13. Roman to Integer(Java)
分析 把具体的情况一个一个实现即可,没有什么幺蛾子. 代码 class Solution { public int romanToInt(String s) { int ans = 0; for (i ...
- 二、Django快速安装
一.安装Python 作为一个Python Web框架,Django依赖Python.从Django适用于哪些版本的Python可以获取更多信息.较新版本的Python内置一个轻量级的数据库SQLit ...