
MapReduce实例(数据去重)
数据去重:
原理(理解):Mapreduce程序首先应该确认<k3,v3>,根据<k3,v3>确定<k2,v2>,原始数据中出现次数超过一次的数据在输出文件中只出现一次。Reduce的输出是不重复的数据,也就是每一行数据作为key,即k3。而v3为空或不需要设值。根据<k3,v3>得到k2为每一行的数据,v2为空。根据MapReduce框架设值可知,k1为每行的起始位置,v1为每行的内容。因此,v1需要赋值给k2,使得原来的v1作为新的k2,从而两个或更多文件通过在Reduce端聚合,得到去重后的数据。
数据:
file1.txt
2016-6-1 b
2016-6-2 a
2016-6-3 b
2016-6-4 d
2016-6-5 a
2016-6-6 c
2016-6-7 d
2016-6-3 c
file2.txt
2016-6-1 a
2016-6-2 b
2016-6-3 c
2016-6-4 d
2016-6-5 a
2016-6-6 b
2016-6-7 c
2016-6-3 c
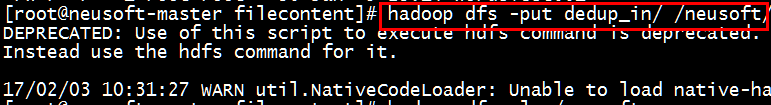
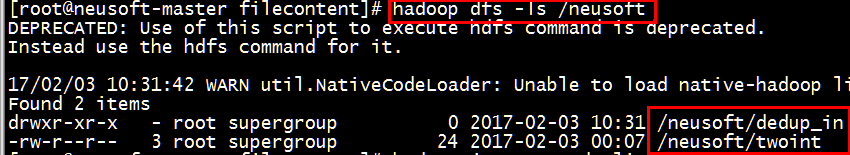
*创建文件夹dedup_in并创建上述两文件,将该文件夹上传到HDFS中
[root@neusoft-master filecontent]# hadoop dfs -put dedup_in/ /neusoft/
[root@neusoft-master filecontent]# hadoop dfs -ls /neusoft
(1)自定义Mapper任务
     private static class MyMapper extends Mapper<Object, Text, Text, Text>{

         private static Text line=new Text();

         @Override

         protected void map(Object k1, Text v1,

                 Mapper<Object, Text, Text, Text>.Context context)

                 throws IOException, InterruptedException {

             line=v1;//v1为每行数据,赋值给line

             context.write(line, new Text(""));

         }

     }
(2)自定义Reduce任务
 private static class MyReducer extends Reducer<Text, Text, Text, Text>

     {

         @Override

         protected void reduce(Text k2, Iterable<Text> v2s,

                 Reducer<Text, Text, Text, Text>.Context context)

                 throws IOException, InterruptedException {

             context.write(k2, new Text(""));

         }

     }
(3)主函数(组织map和reduce)
 public static void main(String[] args) throws Exception {

         //必须要传递的是自定的mapper和reducer的类,输入输出的路径必须指定,输出的类型<k3,v3>必须指定

                 //2将自定义的MyMapper和MyReducer组装在一起

                 Configuration conf=new Configuration();

                 String jobName=DataDeduplication.class.getSimpleName();

                 //1首先寫job,知道需要conf和jobname在去創建即可

                 Job job = Job.getInstance(conf, jobName);

                 //*13最后,如果要打包运行改程序,则需要调用如下行

                 job.setJarByClass(DataDeduplication.class);

                 //3读取HDFS內容:FileInputFormat在mapreduce.lib包下

                 FileInputFormat.setInputPaths(job, new Path(args[0]));

                 //4指定解析<k1,v1>的类(谁来解析键值对)

                 //*指定解析的类可以省略不写,因为设置解析类默认的就是TextInputFormat.class

                 job.setInputFormatClass(TextInputFormat.class);

                 //5指定自定义mapper类

                 job.setMapperClass(MyMapper.class);

                 //6指定map输出的key2的类型和value2的类型  <k2,v2>

                 //*下面两步可以省略,当<k3,v3>和<k2,v2>类型一致的时候,<k2,v2>类型可以不指定

                 job.setMapOutputKeyClass(Text.class);

                 job.setMapOutputValueClass(Text.class);

                 //7分区(默认1个),排序,分组,规约 采用 默认

                 job.setCombinerClass(MyReducer.class);

                 //接下来采用reduce步骤

                 //8指定自定义的reduce类

                 job.setReducerClass(MyReducer.class);

                 //9指定输出的<k3,v3>类型

                 job.setOutputKeyClass(Text.class);

                 job.setOutputValueClass(Text.class);

                 //10指定输出<K3,V3>的类

                 //*下面这一步可以省

                 job.setOutputFormatClass(TextOutputFormat.class);

                 //11指定输出路径

                 FileOutputFormat.setOutputPath(job, new Path(args[1]));

                 //12写的mapreduce程序要交给resource manager运行

                 job.waitForCompletion(true);

     }
数据去重源代码:
 package Mapreduce;

 import java.io.IOException;

 import org.apache.hadoop.conf.Configuration;

 import org.apache.hadoop.fs.Path;

 import org.apache.hadoop.io.Text;

 import org.apache.hadoop.mapreduce.Job;

 import org.apache.hadoop.mapreduce.Mapper;

 import org.apache.hadoop.mapreduce.Reducer;

 import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

 import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

 import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

 import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

 public class DataDeduplication {

     public static void main(String[] args) throws Exception {

         //必须要传递的是自定的mapper和reducer的类,输入输出的路径必须指定,输出的类型<k3,v3>必须指定

                 //2将自定义的MyMapper和MyReducer组装在一起

                 Configuration conf=new Configuration();

                 String jobName=DataDeduplication.class.getSimpleName();

                 //1首先寫job,知道需要conf和jobname在去創建即可

                 Job job = Job.getInstance(conf, jobName);

                 //*13最后,如果要打包运行改程序,则需要调用如下行

                 job.setJarByClass(DataDeduplication.class);

                 //3读取HDFS內容:FileInputFormat在mapreduce.lib包下

                 FileInputFormat.setInputPaths(job, new Path(args[0]));

                 //4指定解析<k1,v1>的类(谁来解析键值对)

                 //*指定解析的类可以省略不写,因为设置解析类默认的就是TextInputFormat.class

                 job.setInputFormatClass(TextInputFormat.class);

                 //5指定自定义mapper类

                 job.setMapperClass(MyMapper.class);

                 //6指定map输出的key2的类型和value2的类型  <k2,v2>

                 //*下面两步可以省略,当<k3,v3>和<k2,v2>类型一致的时候,<k2,v2>类型可以不指定

                 job.setMapOutputKeyClass(Text.class);

                 job.setMapOutputValueClass(Text.class);

                 //7分区(默认1个),排序,分组,规约 采用 默认

                 job.setCombinerClass(MyReducer.class);

                 //接下来采用reduce步骤

                 //8指定自定义的reduce类

                 job.setReducerClass(MyReducer.class);

                 //9指定输出的<k3,v3>类型

                 job.setOutputKeyClass(Text.class);

                 job.setOutputValueClass(Text.class);

                 //10指定输出<K3,V3>的类

                 //*下面这一步可以省

                 job.setOutputFormatClass(TextOutputFormat.class);

                 //11指定输出路径

                 FileOutputFormat.setOutputPath(job, new Path(args[1]));

                 //12写的mapreduce程序要交给resource manager运行

                 job.waitForCompletion(true);

     }

     private static class MyMapper extends Mapper<Object, Text, Text, Text>{

         private static Text line=new Text();

         @Override

         protected void map(Object k1, Text v1,

                 Mapper<Object, Text, Text, Text>.Context context)

                 throws IOException, InterruptedException {

             line=v1;//v1为每行数据,赋值给line

             context.write(line, new Text(""));

         }

     }

     private static class MyReducer extends Reducer<Text, Text, Text, Text>

     {

         @Override

         protected void reduce(Text k2, Iterable<Text> v2s,

                 Reducer<Text, Text, Text, Text>.Context context)

                 throws IOException, InterruptedException {

             context.write(k2, new Text(""));

         }

     }

 }
数据去重
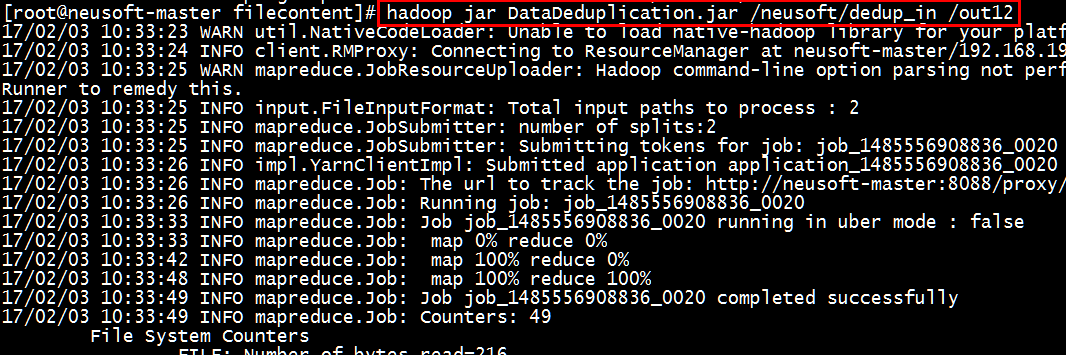
运行结果:
[root@neusoft-master filecontent]# hadoop jar DataDeduplication.jar /neusoft/dedup_in /out12
[root@neusoft-master filecontent]# hadoop dfs -text /out12/part-r-00000
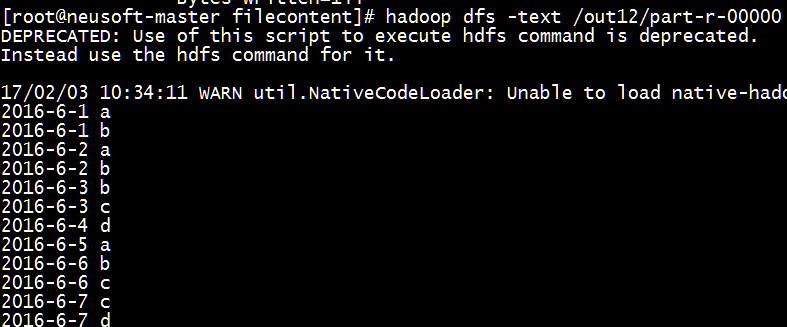
结果验证正确~
注意:HDFS的显示形式
[root@neusoft-master filecontent]# hadoop dfs -ls hdfs://neusoft-master:9000/out12
[root@neusoft-master filecontent]# hadoop dfs -ls /out12

等价表示形式
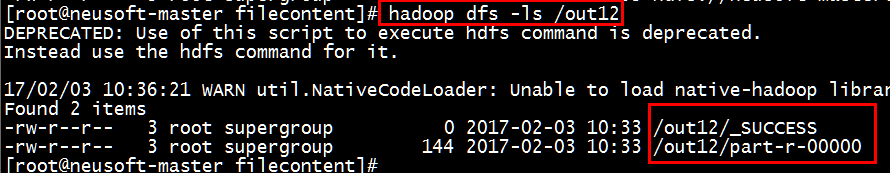
/out12的完整表达形式hdfs://neusoft-master:9000/out12
MapReduce实例(数据去重)的更多相关文章
- 利用MapReduce实现数据去重
数据去重主要是为了利用并行化的思想对数据进行有意义的筛选. 统计大数据集上的数据种类个数.从网站日志中计算访问地等这些看似庞杂的任务都会涉及数据去重. 示例文件内容: 此处应有示例文件 设计思路 数据 ...
- hadoop mapreduce实现数据去重
实现原理分析: map函数数将输入的文本按照行读取, 并将Key--每一行的内容 输出 value--空. reduce 会自动统计所有的key,我们让reduce输出key-> ...
- MapReduce实现数据去重
一.原理分析 Mapreduce的处理过程,由于Mapreduce会在Map~reduce中,将重复的Key合并在一起,所以Mapreduce很容易就去除重复的行.Map无须做任何处理,设置Map中写 ...
- [Hadoop]-从数据去重认识MapReduce
这学期刚好开了一门大数据的课,就是完完全全简简单单的介绍的那种,然后就接触到这里面最被人熟知的Hadoop了.看了官网的教程[吐槽一下,果然英语还是很重要!],嗯啊,一知半解地搭建了本地和伪分布式的, ...
- hadoop —— MapReduce例子 (数据去重)
参考:http://eric-gcm.iteye.com/blog/1807468 例子1: 概要:数据去重 描述:将file1.txt.file2.txt中的数据合并到一个文件中的同时去掉重复的内容 ...
- Mapreduce实例--去重
数据去重"主要是为了掌握和利用并行化思想来对数据进行有意义的筛选.统计大数据集上的数据种类个数.从网站日志中计算访问地等这些看似庞杂的任务都会涉及数据去重. 数据去重的最终目标是让原始数据中 ...
- MapReduce实例
1.WordCount(统计单词) 经典的运用MapReuce编程模型的实例 1.1 Description 给定一系列的单词/数据,输出每个单词/数据的数量 1.2 Sample a is b is ...
- Hadoop 数据去重
数据去重这个实例主要是为了读者掌握并利用并行化思想对数据进行有意义的筛选.统计大数据集上的数据种类个数.从网站日志中计算访问等这些看似庞杂的任务都会涉及数据去重.下面就进入这个实例的MapReduce ...
- map/reduce实现数据去重
import java.io.IOException; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.co ...
随机推荐
- oop思维意识,类 模块命名空间,类扩展之继承 、组合、mixin三种模式
python的书都是讲怎么创建类怎么实例化对象,一般会用使用了,但还不具备这种编程意识.这是从python学习手册第四版节选出来的,书中说oop不仅是一种技术,更是一种经验.学习大神的看法,为什么需要 ...
- Java使用for循环输出杨辉三角
杨辉三角形由数字排列,可以把它看做一个数字表,其基本特性是两侧数值均为1,其他位置的数值是其正上方的数字与左上角数值之和.编写程序,使用for循环输出包括10行在内的杨辉三角形. 思路是创建一个整型二 ...
- Dubbo -- 系统学习 笔记 -- 示例 -- 负载均衡
Dubbo -- 系统学习 笔记 -- 目录 示例 想完整的运行起来,请参见:快速启动,这里只列出各种场景的配置方式 负载均衡 在集群负载均衡时,Dubbo提供了多种均衡策略,缺省为random随机调 ...
- 笔记--Wcf全面解析(上)---(1)
using System; using System.Collections.Generic; using System.Linq; using System.ServiceModel; using ...
- 绑定方式开始服务&调用服务的方法
1.编写activity_main.xml <LinearLayout xmlns:android="http://schemas.android.com/apk/res/androi ...
- 更新npm至最新版本
npm install npm@latest –g 或者@ 符号后面直接添加你想更新到的版本号
- mysql分组查询获取组内某字段最大的记录
id sid cid 1 1 12 1 23 2 1 以sid分组,最后取cid最大的那一条,以上要取第2.3条 1 方法一: select * from (select * from table o ...
- 在wepy里面使用redux
wepy 框架本身是支持 Redux 的,我们在构建项目的时候,将 是否安装 Redux 选择 y 就好了,会自动安装依赖,运行项目后看官方给的 demo 确实是可以做到的,但是官方文档里却对这一块只 ...
- oracle URL参数获取
改函数主要是从URL中获取参数例如 sssss.html?cur=aaa&ref=cccc 调用方式:f_querystr(url,'cur','&'); CREATE OR REPL ...
- (转载)JVM实现synchronized的底层机制
目前在Java中存在两种锁机制:synchronized和Lock,Lock接口及其实现类是JDK5增加的内容,其作者是大名鼎鼎的并发专家Doug Lea.本文并不比较synchronized与Loc ...