
频繁项集挖掘之Aprior和FPGrowth算法
频繁项集挖掘的应用多出现于购物篮分析,现介绍两种频繁项集的挖掘算法Aprior和FPGrowth,用以发现购物篮中出现频率较高的购物组合。
基础知识
项:“属性-值”对。比如啤酒2罐。
项集:项的集合。比如{啤酒2罐,…,尿布5片}
K项集:项集中的每个项都有K个项。
支持度:项集在训练元组中同时出现的次数(或者比例)。
置信度:A−>BA−>B的置信度,表示P(B|A)P(B|A),是个条件概率。(置信度大于用户规定的最小置信度的规则是可信的)
兴趣度:A−>BA−>B的置信度与BB的整体占比的差值。兴趣度越大,表示AA对BB的出现起到的促进作用越大。为负值时表示起到的抑制作用。为0时表示没有影响。
子集:被包含于某项集的项集。
超集:能包含某项集的项集。
频繁项集:在训练元组中,同时出现次数超过支持度的项集。
极大频繁项集:对当前频繁项集来说,没有包含它的频繁超集,则称当前项集为极大频繁超集。
Aprior算法
Aprior算法的基本思想是由KK项频繁项集产生K+1K+1项频繁项集,直到满足条件的频繁项集发现为止。
连接定理和频繁子集定理
连接定理:解决如何由KK项集产生K+1K+1项集问题。若有两个KK项集,其前K−1K−1个项是相同的,则这两个项集可以连接产生一个K+1项集。
频繁子集定理:用来压缩搜索空间。若一个项集的子集不是频繁项集,则该项集也不是频繁项集。(换句话说,非频繁项集的超集也是非频繁项集;频繁项集的所有非空子集也都是频繁项集)
Aprior算法步骤
1. 扫描数据库,产生候选1项集和频繁项集。
2. 从2项集开始循环,由频繁K-1项集生成频繁K项集。
2.1 产生候选项集。根据连接定理,产生候选项集(有个排序的要求,加快比较)。
2.2 去掉非频繁项集。根据频繁子集定理产生频繁项集。
2.3 去掉不符合条件的项集。扫描数据库,计算支持度、置信度、兴趣度,去掉不符合条件的项集。(这地方可变)
2.4 判断迭代终止条件。
Apriro优缺点
Aprior优点:
1)对大型数据库的处理能力,不需要将数库读入内存就可以完成频繁项集的挖掘。
Aprior缺点:
1)需要多次扫描数据库,效率低下。
FPGrowth算法
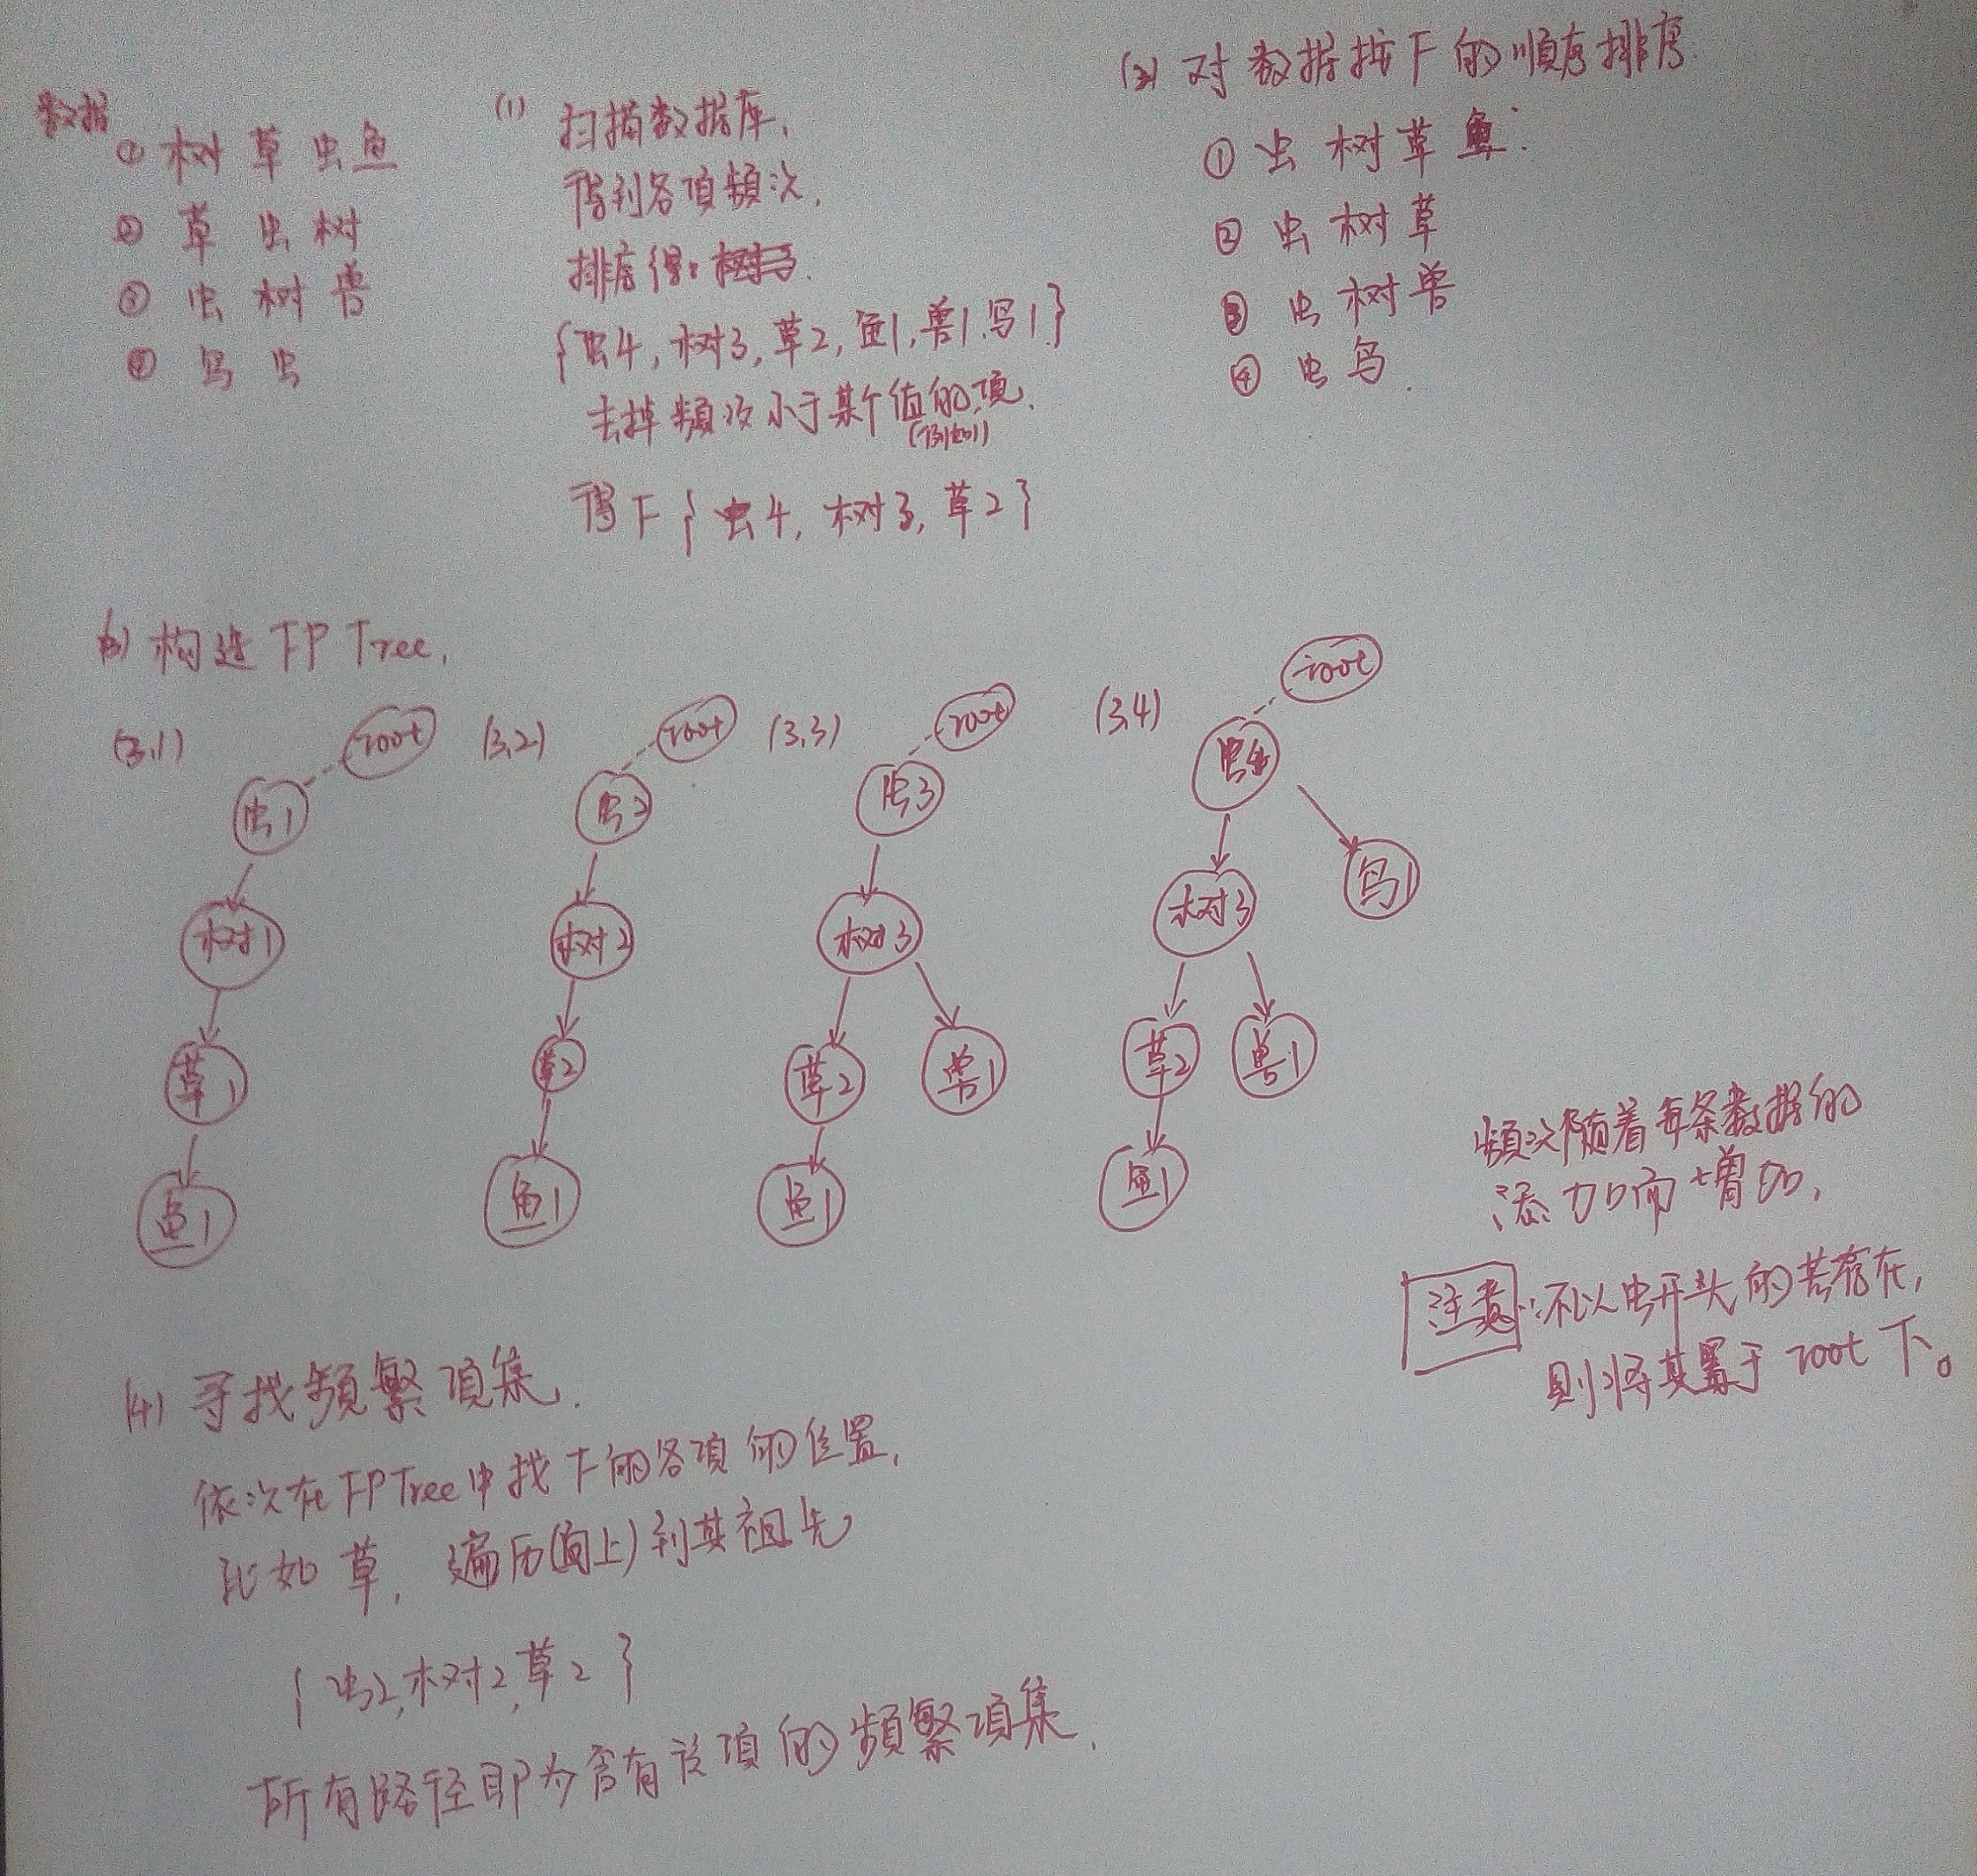
FPGrowth的基本思想是将原始数据压缩到一个FPTree上,在该树上进行频繁项集的挖掘。(FPTree是共用前缀的)
FPGrowth算法步骤
讲地非常好的FPGrowth算法博客(包括原理讲解和代码实现):
(1)http://blog.csdn.net/huagong_adu/article/details/17739247 (2)http://www.cnblogs.com/zhangchaoyang/articles/2198946.html
FPGrowth优缺点
优点:
1)只需要扫描两边数据库,效率高。
2)可以并行化实现。
缺点:
1)受内存大小限制。
频繁项集挖掘之Aprior和FPGrowth算法的更多相关文章
- 频繁项集挖掘之apriori和fp-growth
Apriori和fp-growth是频繁项集(frequent itemset mining)挖掘中的两个经典算法,虽然都是十几年前的,但是理解这两个算法对数据挖掘和学习算法都有很大好处.在理解这两个 ...
- 海量数据挖掘MMDS week2: 频繁项集挖掘 Apriori算法的改进:非hash方法
http://blog.csdn.net/pipisorry/article/details/48914067 海量数据挖掘Mining Massive Datasets(MMDs) -Jure Le ...
- 海量数据挖掘MMDS week2: 频繁项集挖掘 Apriori算法的改进:基于hash的方法
http://blog.csdn.net/pipisorry/article/details/48901217 海量数据挖掘Mining Massive Datasets(MMDs) -Jure Le ...
- 海量数据挖掘MMDS week2: Association Rules关联规则与频繁项集挖掘
http://blog.csdn.net/pipisorry/article/details/48894977 海量数据挖掘Mining Massive Datasets(MMDs) -Jure Le ...
- 手推FP-growth (频繁模式增长)算法------挖掘频繁项集
一.频繁项集挖掘为什么会出现FP-growth呢? 原因:这得从Apriori算法的原理说起,Apriori会产生大量候选项集(就是连接后产生的),在剪枝时,需要扫描整个数据库(就是给出的数据),通过 ...
- 关联分析中寻找频繁项集的FP-growth方法
关联分析是数据挖掘中常用的分析方法.一个常见的需求比如说寻找出经常一起出现的项目集合. 引入一个定义,项集的支持度(support),是指所有包含这个项集的集合在所有数据集中出现的比例. 规定一个最小 ...
- 挖掘频繁项集之FP-Growth算法
http://blog.csdn.net/pipisorry/article/details/48918007 FP-Growth频繁项集挖掘算法(Frequent-Pattern Growth, 频 ...
- 机器学习实战(Machine Learning in Action)学习笔记————08.使用FPgrowth算法来高效发现频繁项集
机器学习实战(Machine Learning in Action)学习笔记————08.使用FPgrowth算法来高效发现频繁项集 关键字:FPgrowth.频繁项集.条件FP树.非监督学习作者:米 ...
- 【Storm】Storm实战之频繁二项集挖掘
一.前言 针对大叔据实时处理的入门,除了使用WordCount示例之外,还需要相对更深入点的示例来理解Storm,因此,本篇博文利用Storm实现了频繁项集挖掘的案例,以方便更好的入门Storm. 二 ...
随机推荐
- 16款值得一用的iPhone线框图模板 (PSD & Sketch)
在任何网站或移动应用设计的过程中,线框图作为设计元素和功能的图示,它有助于帮助定义和更好地传达信息层次结构,让参与设计和开发的人员更好的理解设计师的思路和设计的功能点. 即使线框图设计是一个比较耗时的 ...
- ELMAH 使用
之前大部分系统日志记录是使用log4net.ObjectGuy Framework.NLog 等工具记录到文本或数据库. 更强大的工具可以使用 ELMAH. ELMAH(The Error Loggi ...
- eclipse怎样检出SVN项目
首先确定你的eclipse安装了svn插件.查看eclipse是否安装插件的方法:打开eclipse->文件->新建->其他 ,在弹出的选择向导窗口中如果能搜索到svn,说明ecli ...
- 在命令提示符(cmd)下怎样复制粘贴
我们把鼠标放在面板的上方,右击,界面显示如下: 我们选择“属性”,单击,界面显示如下: 我们点选“快速编辑模式”,再点击“确定”,这样设置就完成了,界面显示如下: 我们在面板中随意选择 ...
- eclipse代码自动提示,eclipse设置代码自动提示
eclipse代码自动提示,eclipse设置代码自动提示 eclipse是很多JAVA开发者基本上都用的工具,用它可以很方便的开发JAVA代码,当编写JAVA代码时,大部分人都是按组合键[Alt+/ ...
- nginx集群tomcat,session共享问题
tomcat-redis-session-manager版本: apache-tomcat-8.0.32.nginx-1.13.12.redis_3.2.1 github地址: https://git ...
- 修改Python IDLE代码配色及语法高亮主题
初学Python,想必大家拿来练习最多的IDE就是Python自带的IDLE了,但是默认的代码配色及语法高亮主题确实很不适应,所以我们需要做个小小的美化,比如像下面这样我做的美化配置: HOW TO ...
- DEVEXPRESS 破解方法
Devexpress 是.net的一个非常好用的插件.能够轻松的帮你实现一个非常炫的UI,无论是C#的Winform还是ASP.NET的网站. 鄙人这两天在用DEVEXPRESS的过程中发现在网上并未 ...
- Hive 1.2.1&Spark&Sqoop安装指南
目录 目录 1 1. 前言 1 2. 约定 2 3. 服务端口 2 4. 安装MySQL 2 4.1. 安装MySQL 2 4.2. 创建Hive元数据库 4 5. 安装步骤 5 5.1. 下载Hiv ...
- 基于MOD13A1的锡林郭勒草原近13年植被覆盖变化 分析
内蒙古师范大学地理科学学院 内蒙古师范大学遥感与地理信息系统重点实验室 摘要:本研究以内蒙古锡林郭勒草原为研究区,基于MOD13A1遥感数据,经过遥感预处理,得到研究区2001-2013年共13年夏季 ...