
记一次简单爬虫(豆瓣/dytt)
磕磕绊绊学python一个月,这次到正则表达式终于能写点有趣的东西,在此作个记录:
—————————————————————————————————————————————————
1.爬取豆瓣电影榜前250名单
运行环境:
pycharm-professional-2018.2.4
3.7.0 (v3.7.0:1bf9cc5093, Jun 27 2018, 04:59:51) [MSC v.1914 64 bit (AMD64)]
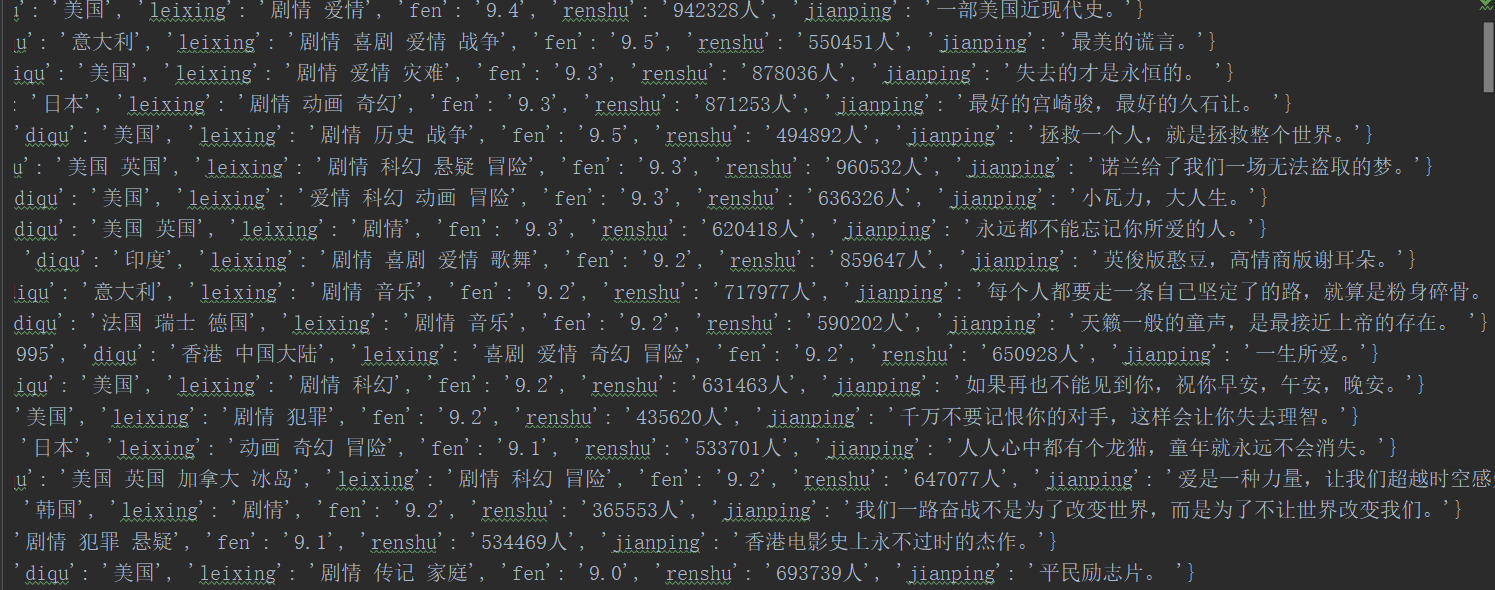
成品效果:

相关代码:
from urllib.request import urlopen
import re
# import ssl # 若有数字签名问题可用
# ssl._create_default_https_context = ssl._create_unverified_context # 写正则规则
obj = re.compile(r'<div class="item">.*?<span class="title">(?P<name>.*?)</span>.*?导演:(?P<daoyan>.*?) .*?'
r'主演:(?P<zhuyan>.*?)<br>\n (?P<shijian>.*?) / (?P<diqu>.*?) '
r'/ (?P<leixing>.*?)\n.*?<span class="rating_num" property="v:average">(?P<fen>.*?)</span>.*?<span>'
r'(?P<renshu>.*?)评价</span>.*?<span class="inq">(?P<jianping>.*?)</span>',re.S) # re.S 干掉换行 # 转码 获取内容
def getContent(url):
content = urlopen(url).read().decode("utf-8")
return content # 匹配页面内容 返回一个迭代器
def parseContent(content):
iiter = obj.finditer(content)
for el in iiter:
yield {
"name":el.group("name"),
"daoyan":el.group("daoyan"),
"zhuyan":el.group("zhuyan"),
"shijian":el.group("shijian"),
"diqu":el.group("diqu"),
"leixing":el.group("leixing"),
"fen":el.group("fen"),
"renshu":el.group("renshu"),
"jianping":el.group("jianping")
} for i in range(10):
url = "https://movie.douban.com/top250?start=%s&filter=" % (i*25) # 循环页面10
print(url)
g = parseContent(getContent(url)) # 匹配获取的内容返回给g
f = open("douban_movie.txt",mode="a",encoding="utf-8")
for el in g:
f.write(str(el)+"\n") # 写入到txt 注意加上换行 # f.write("==============================================") # 测试分页
f.close()
2.爬取某站最新电影和下载地址
运行环境:
pycharm-professional-2018.2.4
3.7.0 (v3.7.0:1bf9cc5093, Jun 27 2018, 04:59:51) [MSC v.1914 64 bit (AMD64)]
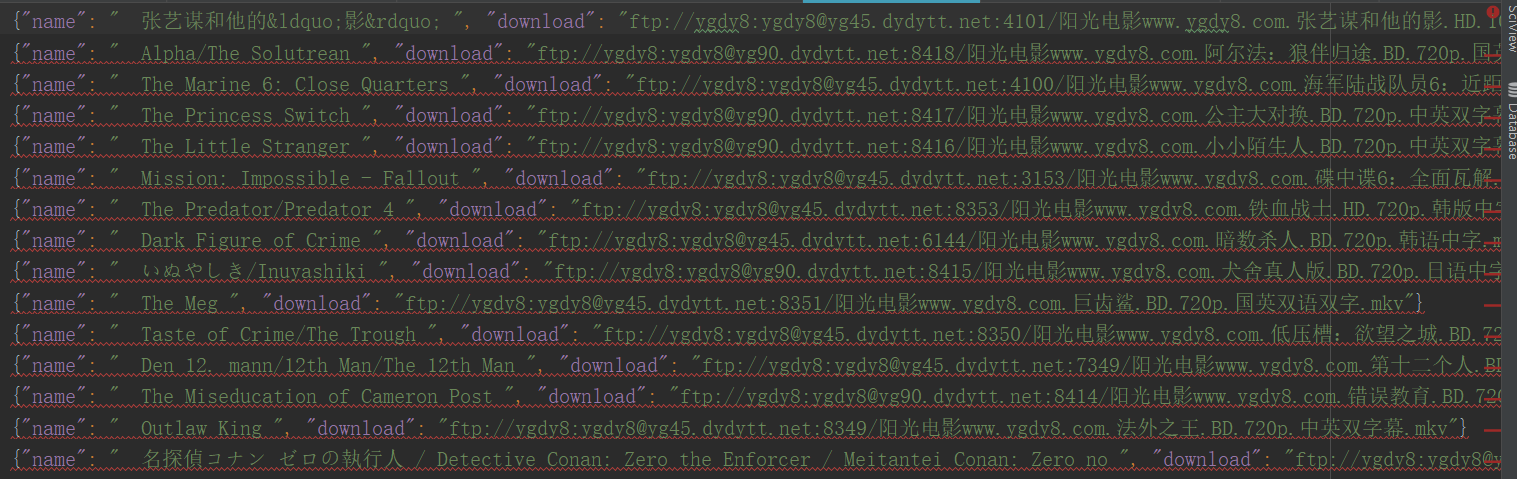
成品效果:
相关代码:
 from urllib.request import urlopen

 import json

 import re

 # 获取主页面内容

 url = "https://www.dytt8.net/"

 content = urlopen(url).read().decode("gbk")

 # print(content)

 # 正则

 obj = re.compile(r'.*?最新电影下载</a>]<a href=\'(?P<url1>.*?)\'>', re.S)

 obj1 = re.compile(r'.*?<div id="Zoom">.*?<br />◎片  名(?P<name>.*?)<br />.*?bgcolor="#fdfddf"><a href="(?P<download>.*?)">', re.S)

 def get_content(content):

     res = obj.finditer(content)

     f = open('movie_dytt.json', mode='w', encoding='utf-8')

     for el in res:

         res = el.group("url1")

         res = url + res  # 拼接子页面网址

         content1 = urlopen(res).read().decode("gbk")  # 获取子页面内容

         lst = obj1.findall(content1)  # 匹配obj1返回一个列表

         # print(lst)  # 元组

         name = lst[0][0]

         download = lst[0][1]

         s = json.dumps({"name":name,"download":download},ensure_ascii=False)

         f.write(s+"\n")

     f.flush()

     f.close()

 get_content(content)  # 调用函数 执行
记一次简单爬虫(豆瓣/dytt)的更多相关文章
- 放养的小爬虫--豆瓣电影入门级爬虫(mongodb使用教程~)
放养的小爬虫--豆瓣电影入门级爬虫(mongodb使用教程~) 笔者声明:只用于学习交流,不用于其他途径.源代码已上传github.githu地址:https://github.com/Erma-Wa ...
- Python做简单爬虫(urllib.request怎么抓取https以及伪装浏览器访问的方法)
一:抓取简单的页面: 用Python来做爬虫抓取网站这个功能很强大,今天试着抓取了一下百度的首页,很成功,来看一下步骤吧 首先需要准备工具: 1.python:自己比较喜欢用新的东西,所以用的是Pyt ...
- python 简单爬虫(beatifulsoup)
---恢复内容开始--- python爬虫学习从0开始 第一次学习了python语法,迫不及待的来开始python的项目.首先接触了爬虫,是一个简单爬虫.个人感觉python非常简洁,相比起java或 ...
- Python 简单爬虫案例
Python 简单爬虫案例 import requests url = "https://www.sogou.com/web" # 封装参数 wd = input('enter a ...
- Python简单爬虫入门三
我们继续研究BeautifulSoup分类打印输出 Python简单爬虫入门一 Python简单爬虫入门二 前两部主要讲述我们如何用BeautifulSoup怎去抓取网页信息以及获取相应的图片标题等信 ...
- [Java]使用HttpClient实现一个简单爬虫,抓取煎蛋妹子图
第一篇文章,就从一个简单爬虫开始吧. 这只虫子的功能很简单,抓取到”煎蛋网xxoo”网页(http://jandan.net/ooxx/page-1537),解析出其中的妹子图,保存至本地. 先放结果 ...
- 简单爬虫,突破IP访问限制和复杂验证码,小总结
简单爬虫,突破复杂验证码和IP访问限制 文章地址:http://www.cnblogs.com/likeli/p/4730709.html 好吧,看题目就知道我是要写一个爬虫,这个爬虫的目标网站有 ...
- Python简单爬虫入门二
接着上一次爬虫我们继续研究BeautifulSoup Python简单爬虫入门一 上一次我们爬虫我们已经成功的爬下了网页的源代码,那么这一次我们将继续来写怎么抓去具体想要的元素 首先回顾以下我们Bea ...
- GJM : Python简单爬虫入门(二) [转载]
感谢您的阅读.喜欢的.有用的就请大哥大嫂们高抬贵手"推荐一下"吧!你的精神支持是博主强大的写作动力以及转载收藏动力.欢迎转载! 版权声明:本文原创发表于 [请点击连接前往] ,未经 ...
随机推荐
- webstorm 调出project
Alt+1就能弹出窗口面板. 视图-工具窗口-Project 删除项目 Click File > Close project From Recent projects, select pr ...
- sublime text3---Emmet:HTML/CSS代码快速编写神器
Emmet的前身是大名鼎鼎的Zen coding,如果你从事Web前端开发的话,对该插件一定不会陌生.它使用仿CSS选择器的语法来生成代码,大大提高了HTML/CSS代码编写的速度,比如下面的演示: ...
- 重读源码,见证HashMap以及它的朋友们的骚操作
一.Getting Start Again and again,until you master it.早在接触java.util包的时候,我们都会去阅读ArrayList,甚至也会去阅读HashMa ...
- Vue环境搭建及node安装过程整理
一.nodejs的安装 Node.js安装包及源码下载地址为:https://nodejs.org/en/download/. 我们可以根据不同平台系统选择你需要的Node.js安装包.Node.js ...
- php引用使用不恰当而产生问题的地方
php变量的引用,如果使用的恰当,会带来效率的提升,相反,效率下降 $array = range(, ); $ref =& $array; var_dump(count($array)); / ...
- 3、Xamarin Forms 调整安卓TabbedPage 下置
降低学习成本是每个.NET传教士义务与责任. 建立生态,保护生态,见者有份. 教程晦涩难懂是我的错误. 对于默认的TabbedPage 上面进行页面切换 上面是安卓默认的情况 对我们大部分人来说都 ...
- (转)Mysql技术内幕InnoDB存储引擎-表&索引算法和锁
表 原文:http://yingminxing.com/mysql%E6%8A%80%E6%9C%AF%E5%86%85%E5%B9%95innodb%E5%AD%98%E5%82%A8%E5%BC% ...
- C++的开源跨平台日志库glog学习研究(二)--宏的使用
上一篇从整个工程上简单分析了glog,请看C++的开源跨平台日志库glog学习研究(一),这一篇对glog的实现代码入手,比如在其源码中以宏的使用最为广泛,接下来就先对各种宏的使用做一简单分析. 1. ...
- MAC帧格式、IPV4数据报格式、TCP报文格式、UDP数据报格式
1.MAC帧格式 类型:2字节,指出数据域中携带的数据应交给哪些协议实体处理 校验码:校验数据段(采用32位CRC冗余校验方式进行校验) 2.IPV4数据报 版本:IP协议版本,这里为4 首部长度:占 ...
- Spring Security构建Rest服务-1200-SpringSecurity OAuth开发APP认证框架
基于服务器Session的认证方式: 前边说的用户名密码登录.短信登录.第三方登录,都是普通的登录,是基于服务器Session保存用户信息的登录方式.登录信息都是存在服务器的session(服务器的一 ...