
[Java]使用HttpClient实现一个简单爬虫,抓取煎蛋妹子图
第一篇文章,就从一个简单爬虫开始吧。
这只虫子的功能很简单,抓取到”煎蛋网xxoo”网页(http://jandan.net/ooxx/page-1537),解析出其中的妹子图,保存至本地。
先放结果:

从程序来讲,分为三个步骤:
1、发起一个http请求,获取返回的response内容;
2、解析内容,分离出有效图片的url;
3、根据这些图片的url,生成图片保存至本地。
开始详细说明:
准备工作:HttpClient的Jar包,访问http://hc.apache.org/ 自行下载。
主程序内容:
public class SimpleSpider {

    //起始页码

    private static final int page = 1538;

    public static void main(String[] args) {

        //HttpClient 超时配置

        RequestConfig globalConfig = RequestConfig.custom().setCookieSpec(CookieSpecs.STANDARD).setConnectionRequestTimeout(6000).setConnectTimeout(6000).build();

        CloseableHttpClient httpClient = HttpClients.custom().setDefaultRequestConfig(globalConfig).build();

        System.out.println("5秒后开始抓取煎蛋妹子图……");

        for (int i = page; i > 0; i--) {

            //创建一个GET请求

            HttpGet httpGet = new HttpGet("http://jandan.net/ooxx/page-" + i);

            httpGet.addHeader("User-Agent","Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/42.0.2311.152 Safari/537.36");

            httpGet.addHeader("Cookie","_gat=1; nsfw-click-load=off; gif-click-load=on; _ga=GA1.2.1861846600.1423061484");

            try {

                //不敢爬太快

                Thread.sleep(5000);

                //发送请求,并执行

                CloseableHttpResponse response = httpClient.execute(httpGet);

                InputStream in = response.getEntity().getContent();

                String html = Utils.convertStreamToString(in);

                //网页内容解析

                new Thread(new JianDanHtmlParser(html, i)).start();

            } catch (Exception e) {

                e.printStackTrace();

            }

        }

    }

}
HttpClient是一个非常强大的工具,属于apache下项目。如果只是创建一个默认的httpClient实例,代码很简单,官网手册上有详细说明。
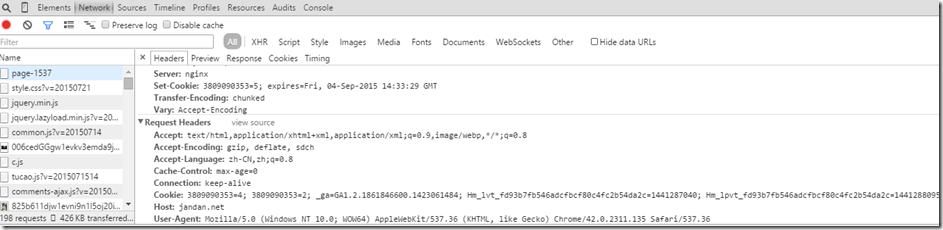
可以看到在创建一个GET请求时,加入了请求头。第一个User-Agent代表所使用浏览器。有些网站需要明确了解用户所使用的浏览器,而有些不需要。个人猜测,部分网站根据用户使用浏览器不同显示不一样。这里的煎蛋网,就必须得加入请求头。第二个Cookie则代表了一些用户设置,可以没有。使用chrome的开发者工具就能清楚看到。如果是https加密后的,则需要特殊的抓包工具。
网页内容解析
public class JianDanHtmlParser implements Runnable {

    private String html;

    private int page;

    public JianDanHtmlParser(String html,int page) {

        this.html = html;

        this.page = page;

    }

    @Override

    public void run() {

        System.out.println("==========第"+page+"页============");

        List<String> list = new ArrayList<String>();

        html = html.substring(html.indexOf("commentlist"));

        String[] images = html.split("li>");

        for (String image : images) {

            String[] ss = image.split("br");

            for (String s : ss) {

                if (s.indexOf("<img src=") > 0) {

                    try{

                        int i = s.indexOf("<img src=\"") + "<img src=\"".length();

                        list.add(s.substring(i, s.indexOf("\"", i + 1)));

                    }catch (Exception e) {

                        System.out.println(s);

                    }

                }

            }

        }

        for(String imageUrl : list){

            if(imageUrl.indexOf("sina")>0){

                new Thread(new JianDanImageCreator(imageUrl,page)).start();

            }

        }

    }

}
这段代码看起来凌乱,但实际上却特别简单。简单说便是,将response返回的html字符串解析,截取,找到真正需要的内容(图片url),存入到临时容器中。
生成图片类
public class JianDanImageCreator implements Runnable {

    private static int count = 0;

    private String imageUrl;

    private int page;

     //存储路径,自定义

    private static final String basePath = "E:/jiandan";

    public JianDanImageCreator(String imageUrl,int page) {

        this.imageUrl = imageUrl;

        this.page = page;

    }

    @Override

    public void run() {

        File dir = new File(basePath);

        if(!dir.exists()){

            dir.mkdirs();

            System.out.println("图片存放于"+basePath+"目录下");

        }

        String imageName = imageUrl.substring(imageUrl.lastIndexOf("/")+1);

        try {

            File file = new File( basePath+"/"+page+"--"+imageName);

            OutputStream os = new FileOutputStream(file);

            //创建一个url对象

            URL url = new URL(imageUrl);

            InputStream is = url.openStream();

            byte[] buff = new byte[1024];

            while(true) {

                int readed = is.read(buff);

                if(readed == -1) {

                    break;

                }

                byte[] temp = new byte[readed];

                System.arraycopy(buff, 0, temp, 0, readed);

                //写入文件

                os.write(temp);

            }

            System.out.println("第"+(count++)+"张妹子:"+file.getAbsolutePath());

            is.close();

            os.close();

        } catch (Exception e) {

            e.printStackTrace();

        }

    }

}
根据每个图片的src地址创建一个URL对象,再使用字节流,生成本地文件。
这个程序相对来说比较简单,纯属娱乐。如果能让那些不了解HttpClient的同学对这个库产生兴趣,则功德无量。
github地址:https://github.com/nbsa/SimpleSpider
PS:这个博客只提供抓取图片的方法,图片版权属于原网站及其网友。请大家尊重原网劳动成果,避免分发、传播图片内容。
[Java]使用HttpClient实现一个简单爬虫,抓取煎蛋妹子图的更多相关文章
- Golang分布式爬虫:抓取煎蛋文章|Redis/Mysql|56,961 篇文章
--- layout: post title: "Golang分布式爬虫:抓取煎蛋文章" date: 2017-04-15 author: hunterhug categories ...
- 爬虫技术 -- 进阶学习(七)简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码...算是一份测试版的代码.大牛大神别喷... 通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配. List<string&g ...
- 爬虫技术(四)-- 简单爬虫抓取示例(附c#代码)
这是我的第一个爬虫代码...算是一份测试版的代码.大牛大神别喷... 通过给定一个初始的地址startPiont然后对网页进行捕捉,然后通过正则表达式对网址进行匹配. List<string&g ...
- Python3简单爬虫抓取网页图片
现在网上有很多python2写的爬虫抓取网页图片的实例,但不适用新手(新手都使用python3环境,不兼容python2), 所以我用Python3的语法写了一个简单抓取网页图片的实例,希望能够帮助到 ...
- python3爬虫爬取煎蛋网妹纸图片(上篇)
其实之前实现过这个功能,是使用selenium模拟浏览器页面点击来完成的,但是效率实际上相对来说较低.本次以解密参数来完成爬取的过程. 首先打开煎蛋网http://jandan.net/ooxx,查看 ...
- python爬虫–爬取煎蛋网妹子图片
前几天刚学了python网络编程,书里没什么实践项目,只好到网上找点东西做. 一直对爬虫很好奇,所以不妨从爬虫先入手吧. Python版本:3.6 这是我看的教程:Python - Jack -Cui ...
- Python 爬虫 爬取 煎蛋网 图片
今天, 试着爬取了煎蛋网的图片. 用到的包: urllib.request os 分别使用几个函数,来控制下载的图片的页数,获取图片的网页,获取网页页数以及保存图片到本地.过程简单清晰明了 直接上源代 ...
- 用python来抓取“煎蛋网”上面的美女图片,尺度很大哦!哈哈
所用Python环境为:python 3.3.2 用到的库为:urllib.request re 废话不多说,先上代码: import urllib.request import re #获 ...
- python3爬虫爬取煎蛋网妹纸图片(下篇)2018.6.25有效
分析完了真实图片链接地址,下面要做的就是写代码去实现了.想直接看源代码的可以点击这里 大致思路是:获取一个页面的的html---->使用正则表达式提取出图片hash值并进行base64解码--- ...
随机推荐
- CLR via C# 摘要二:IL速记
最简单的IL程序 .assembly test {} .method void Func() { .entrypoint ldstr "hello world" call void ...
- 支付宝PC即时到账和手机网站支付同步
前几个月做了一个旅游网站,有PC站和手机站,涉及支付宝支付功能. 要求:PC站下的单,用户用手机登录也能支付;同理,手机站下的单,PC端登录也能支付. 附支付宝开放平台网址:即时到账 ,手机网站支付. ...
- 在浏览器标签显示网站logo图标
在网站根目录下添加favicon.ico文件,并在网页添加如下代码: <link rel="bookmark" href="~/favicon.ico" ...
- servlet开发中遇到的问题集合
问题1: servlet插入数据库时中文会乱码. 解决方法:在数据库连接地址最后增加两个转码参数(?useUnicode=true&characterEncoding=utf8) url=jd ...
- Struts2框架简介和示例
struts2框架 Struts2是java web的框架,在Java Web开发中,表示层框架,其核心是通过扩展Servlet来帮助处理http请求. Struct2的基本流程 Struct2的框架 ...
- 经典的一款jQuery soChange幻灯片
soChange一款多很经典的幻灯片的jQuery插件. 实例预览 引入文件 <link rel="stylesheet" type="text/css" ...
- 关于IOS中safari下的select下拉菜单,文字过长不换行的问题
今天遇到下图这种问题,文字过长,显示不全.折腾了老半天,在网上搜了半天也找不到解决方案. 于是问了下同事,同事提到了<optgroup>,这个标签厉害. <optgroup> ...
- BFC布局
这几天都没有写博客,自己的懒惰又要跑出来了,发觉不能再这样下去了,不然就什么都不想干了,然后将之前已经写得差不多的博客重新检视了一遍.这篇博客已经写得挺久的了,但是一直没有发布,现在补充了一些,也让自 ...
- SVG 文本
该部分为四个主要部分: 1. <text>和<tspan>标签详解 2. 文本水平垂直居中问题 3. <textpath>让文本在指定路径上排列 4 ...
- Java之this关键字的用法
Java 中的 this 关键字指当前的对象,可以直接用其调用当前对象的成员变量,也可以直接用其调用当前对象的成员方法,这是我们常见的场景,那么有没有其它的情况呢! this 还可以在无参的构造方法中 ...