
《机器学习实战》学习笔记第七章 —— AdaBoost元算法
主要内容:
一.提升方法与AdaBoost算法的简介
二.AdaBoost算法
三.代码解释
一.提升方法与AdaBoost算法的简介
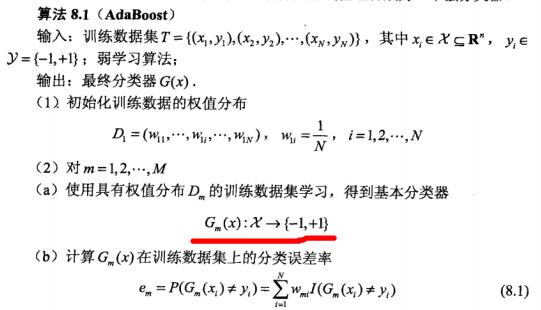
1.提升方法:从弱学习算法出发,反复学习,得到一系列弱分类器(又称为基本分类器),然后组合这些弱分类器,构成一个强分类器。大多数的提升方法都是改变训练数据的概率分布(权值分布),针对不同的训练数据分布(相同的数据,不同的概率分布)调用弱学习算法学习一系列弱分了器。
所以,对于提升方法来说,需要回答两个问题:
1)在每一轮如何改变训练数据的的权值或概率分布?
2)如何将弱分类器组合成一个强分类器?
2.AdaBoost算法是最具代表性的提升方法。对于上述两个问题,AdaBoost的做法是:
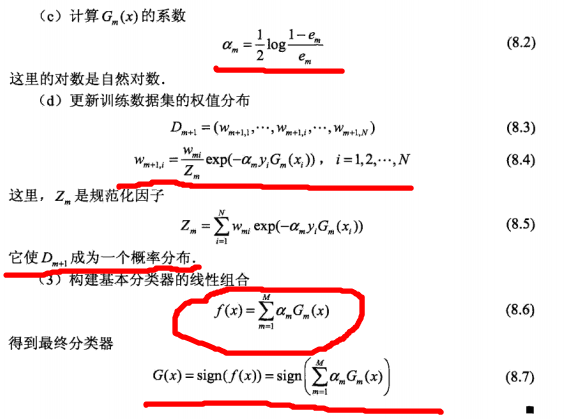
1)提高那些被前一轮弱分类器错误分类样本的权值,而降低那些被正确分类样本的权值,这样一来,那些没有得到正确分类的数据,由于其权值的加大而受到后一轮弱分类器的更大关注。于是,分类问题被一系列的弱分类器“分而治之”。
2)加大分类误差率小的弱分类器的权值,使其在表决中起较大的作用,减小分类误差率大的弱分类器的权值,使得其在表决中起较小的作用。
二.AdaBoost算法
三.代码解释
 # coding:utf-8

 '''

 Created on Nov 28, 2010

 Adaboost is short for Adaptive Boosting

 @author: Peter

 '''

 from numpy import *

 def loadSimpData():         #手动生成数据

     datMat = matrix([[1., 2.1],

                      [2., 1.1],

                      [1.3, 1.],

                      [1., 1.],

                      [2., 1.]])

     classLabels = [1.0, 1.0, -1.0, -1.0, 1.0]

     return datMat, classLabels

 def loadDataSet(fileName):  # 从文件中加载数据

     numFeat = len(open(fileName).readline().split('\t'))  # get number of fields

     dataMat = []

     labelMat = []

     fr = open(fileName)

     for line in fr.readlines():

         lineArr = []

         curLine = line.strip().split('\t')

         for i in range(numFeat - 1):

             lineArr.append(float(curLine[i]))

         dataMat.append(lineArr)

         labelMat.append(float(curLine[-1]))

     return dataMat, labelMat

 def stumpClassify(dataMatrix, dimen, threshVal, threshIneq):  # just classify the data

     retArray = ones((shape(dataMatrix)[0], 1))

     if threshIneq == 'lt':

         retArray[dataMatrix[:, dimen] <= threshVal] = -1.0

     else:

         retArray[dataMatrix[:, dimen] > threshVal] = -1.0

     return retArray

 '''构建单层决策树,即只分裂一次'''

 def buildStump(dataArr, classLabels, D):

     dataMatrix = mat(dataArr)   #把特征X和标签Y都转成numpy的数组

     labelMat = mat(classLabels).T

     m, n = shape(dataMatrix)

     numSteps = 10.0     #步长为10,由于特征的值是连续型的,且在一个区间之内。所以要设置合适的步数,而范围和步数又决定了步长,即精度。

     bestStump = {}

     bestClasEst = mat(zeros((m, 1)))    #最好的预测值

     minError = inf  # 初始化最小误差

     for i in range(n):  # 枚举每一个特征进行分裂

         rangeMin = dataMatrix[:, i].min()   #该特征的最小值

         rangeMax = dataMatrix[:, i].max()   #该特征的最大值

         stepSize = (rangeMax - rangeMin) / numSteps     #步长,即精度

         for j in range(-1, int(numSteps) + 1):  # 枚举步数,从而确定阈值

             for inequal in ['lt', 'gt']:  # 用大于号还是小于号进行分割,这一步的影响大吗?感觉应该没什么区别

                 threshVal = (rangeMin + float(j) * stepSize)        #阈值

                 predictedVals = stumpClassify(dataMatrix, i, threshVal,inequal)  # 通过阈值进行分类

                 errArr = mat(ones((m, 1)))      #分别错误列表

                 errArr[predictedVals == labelMat] = 0

                 '''

                     计算错误率。这是决策树,为什么不是用信息增益来衡量呢?等等,信息增益好像不是用来计算错误率的。

                     因为是“单层决策树”,即只分裂一次就可直接得到分类结果了。所以直接用分类错误的比率来衡量决策树的好坏就可以了。

                 '''

                 weightedError = D.T * errArr

                 if weightedError < minError:            #更新最优的分类条件

                     minError = weightedError

                     bestClasEst = predictedVals.copy()

                     bestStump['dim'] = i

                     bestStump['thresh'] = threshVal

                     bestStump['ineq'] = inequal

     return bestStump, minError, bestClasEst

 '''adaboost算法'''

 def adaBoostTrainDS(dataArr, classLabels, numIt=40):

     weakClassArr = []   #弱分类器列表

     m = shape(dataArr)[0]

     D = mat(ones((m, 1)) / m)  # 每个数据的权值都初始化为1/m

     aggClassEst = mat(zeros((m, 1)))     #用于累加所有分类器的(带系数)结果,从而确定最终的分类。由于有m个数据,所以为长度为m的列表。

     for i in range(numIt):      #迭代次数

         bestStump, error, classEst = buildStump(dataArr, classLabels, D)  # 构建单层决策树,即为一个弱分类器

         alpha = float(0.5 * log((1.0 - error) / max(error, 1e-16)))  # 计算弱分类器的系数alpha,1e-16用于防止溢出

         bestStump['alpha'] = alpha      #保存弱分类器的系数alpha

         weakClassArr.append(bestStump)  # 将弱分类器放到分类器列表的尾部

         ''''''

         expon = multiply(-1 * alpha * mat(classLabels).T, classEst)  # 从此开始到第三步:重新计算每个数据的权值

         D = multiply(D, exp(expon))  # Calc New D for next iteration

         D = D / D.sum()

         ''''''

         aggClassEst += alpha * classEst     #累加最终分类结果

         ''''''

         aggErrors = multiply(sign(aggClassEst) != mat(classLabels).T, ones((m, 1)))     #计算分类错误率

         errorRate = aggErrors.sum() / m

         print "total error: ", errorRate

         if errorRate == 0.0: break  #如果错误率为0,则可退出

     return weakClassArr, aggClassEst

 '''根据学习得到的弱分类器队列来对数据进行分类,第一个参数为数据,第二个参数为弱分类器队列'''

 def adaClassify(datToClass, classifierArr):

     dataMatrix = mat(datToClass)  # do stuff similar to last aggClassEst in adaBoostTrainDS

     m = shape(dataMatrix)[0]

     aggClassEst = mat(zeros((m, 1)))        #用于累计分类结果

     for i in range(len(classifierArr)):     #将数据输入、通过这m个弱分类器

         classEst = stumpClassify(dataMatrix, classifierArr[i]['dim'], classifierArr[i]['thresh'],classifierArr[i]['ineq'])

         aggClassEst += classifierArr[i]['alpha'] * classEst         #累加分类结果

         print aggClassEst

     return sign(aggClassEst)            #将累加结果输入到sign()函数中,得到最终的分类结果
《机器学习实战》学习笔记第七章 —— AdaBoost元算法的更多相关文章
- JVM学习笔记-第七章-虚拟机类加载机制
JVM学习笔记-第七章-虚拟机类加载机制 7.1 概述 Java虚拟机描述类的数据从Class文件加载到内存,并对数据进行校验.转换解析和初始化,最终形成可以被虚拟机直接使用的Java类型,这个过程被 ...
- [Python学习笔记][第七章Python文件操作]
2016/1/30学习内容 第七章 Python文件操作 文本文件 文本文件存储的是常规字符串,通常每行以换行符'\n'结尾. 二进制文件 二进制文件把对象内容以字节串(bytes)进行存储,无法用笔 ...
- 【机器学习实战学习笔记(2-2)】决策树python3.6实现及简单应用
文章目录 1.ID3及C4.5算法基础 1.1 计算香农熵 1.2 按照给定特征划分数据集 1.3 选择最优特征 1.4 多数表决实现 2.基于ID3.C4.5生成算法创建决策树 3.使用决策树进行分 ...
- 【机器学习实战学习笔记(1-1)】k-近邻算法原理及python实现
笔者本人是个初入机器学习的小白,主要是想把学习过程中的大概知识和自己的一些经验写下来跟大家分享,也可以加强自己的记忆,有不足的地方还望小伙伴们批评指正,点赞评论走起来~ 文章目录 1.k-近邻算法概述 ...
- o'Reill的SVG精髓(第二版)学习笔记——第七章
第七章:路径 所有描述轮廓的数据都放在<path>元素的d属性中(d是data的缩写).路径数据包括单个字符的命令,比如M表示moveto,L表示lineto.接着是该命令的坐标信息. 7 ...
- 机器学习算法( 七、AdaBoost元算法)
一.概述 当做重要决定时,大家可能都会考虑吸取多个专家而不只是一个人的意见.机器学习处理问题时又何尝不是如此?这就是元算法(meta-algorithm)背后的思路.元算法是对其他算法进行组合的一种方 ...
- 受限玻尔兹曼机(RBM)学习笔记(七)RBM 训练算法
去年 6 月份写的博文<Yusuke Sugomori 的 C 语言 Deep Learning 程序解读>是囫囵吞枣地读完一个关于 DBN 算法的开源代码后的笔记,当时对其中涉及的算 ...
- 【数据分析 R语言实战】学习笔记 第七章 假设检验及R实现
假设检验及R实现 7.1假设检验概述 对总体参数的具体数值所作的陈述,称为假设;再利用样本信息判断假设足否成立,这整个过程称为假设检验. 7.1.1理论依据 假设检验之所以可行,其理沦背景是小概率理论 ...
- Python_sklearn机器学习库学习笔记(七)the perceptron(感知器)
一.感知器 感知器是Frank Rosenblatt在1957年就职于Cornell航空实验室时发明的,其灵感来自于对人脑的仿真,大脑是处理信息的神经元(neurons)细胞和链接神经元细胞进行信息传 ...
随机推荐
- KVO(1)
#import "ViewController.h" @interface ViewController () @property(nonatomic, strong)UIButt ...
- ext tree展开时的一些技巧
加入子节点的时候.我们须要展开父节点.并选中刚加入好的节点. 这时候会有一个问题. 我用的ext-js-4.2起码有一种问题. 节点内部会混乱.要么多加一个. 要么层级会发生故障. 随后我发现一个窍门 ...
- 重读金典------高质量C编程指南(林锐)-------第一章 文件结构
第一章 文件结构 C/C++程序通常由两个文件组成,一个文件保存程序的声明,称为头文件,.h 文件.一个保存程序的实现,称为定义文件.c文件. 1.1 版权与版本的声明 版权和版本的声明 ...
- github 迁移google code 项目
本文的原文连接是: http://blog.csdn.net/freewebsys/article/details/46692181 转载请一定注明出处. 1,关于google code google ...
- Python 规范化LinkedIn用户联系人的职位名
CODE: #!/usr/bin/python # -*- coding: utf-8 -*- ''' Created on 2014-8-19 @author: guaguastd @name: j ...
- Django之sitemap
##########settings.py SITE_ID=1 # Application definition # taggit tag INSTALLED_APPS = [ 'myblog', ' ...
- grunt前端打包——css篇
[导读] 前端打包的工具有很多,我用的习惯的就是这个grunt,无论是你要在github上做开源,还是让自己的项目变得更易于维护,grunt都是首选. 前端打包的工具有很多,我用的习惯的就是这个gru ...
- JavaScript读书笔记(6)-Array RegExp
1.Array类型 ECMAScript数组的每一项可以保存任何类型的数据,数组的大小也可以动态调整: (1) 创建数组 第一种方式:Array构造函数 var colors=new Array(); ...
- 【转】android 签名验证防止重打包
网上资料很多,这里只做一个笔记反编译 dex 修改重新打包签名后 apk 的签名信息肯定会改变,所以可以在代码中判断签名信息是否被改变过,如果签名不一致就退出程序,以防止 apk 被重新打包. 1 j ...
- iOS中数组遍历的方法及比較
数组遍历是编码中非经常见的一种需求.我们来扒一拔iOS里面都有什么样的方法来实现,有什么特点. 由于iOS是兼容C语言的.所以C语言里面的最最常见的for循环遍历是没有问题的. 本文中用的数组是获取的 ...