
大数据(3):基于sogou.500w.utf8数据Hbase和Spark实践
1. HBase安装部署操作
a) 解压HBase安装包
tar –zxvf hbase-0.98.0-hadoop2-bin.tar.gz
b) 修改环境变量 hbase-env.sh
export JAVA_HOME=/usr/java/jdk1.7.0_71/
c) 修改配置文件 hbase-site.xml
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <configuration>
<property> <name>hbase.cluster.distributed</name>
<value>true</value> </property>
<property> <name>hbase.rootdir</name> <value>hdfs://master:9000/hbase</value>
</property> <property>
<name>hbase.zookeeper.quorum</name>
<value>master</value> </property>
</configuration>
d) regionservers
将文件中的localhost改为slave
e) 设置环境变量
vi .bash_profile
export HBASE_HOME=hbase的安装路径
export HADOOP_CLASSPATH=$HBASE_HOME/lib/*
f) 复制HBase安装文件到slave节点
g) 验证启动 start-hbase.sh
http://master:60010 访问HBase集群
jps 查看进程
1. 查询HBase版本信息
hbase > version

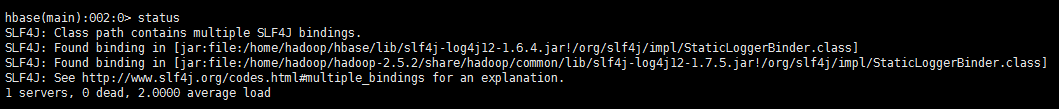
2. 查询服务器状态信息
hbase> status
3. 列出所有表
list --类似于show tables;

4. 创建一张表table1(包含两个列族)
create ‘table1’, ‘columnsfamily1’, ‘columnsfamily2’
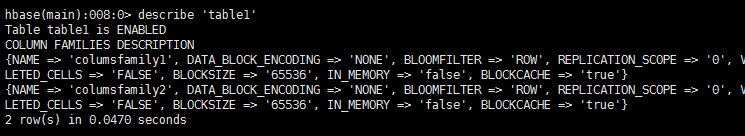
5. 查看表的描述信息
describe ‘table1’
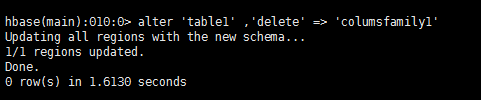
6. 修改表的模式,删除列族columnsfamily1
alter ‘table1’ , ‘delete’ => ‘columnsfamily1’
注意:修改表模式之前请将表disable
disable ‘table1’
7. 删除一张表
disable ‘table1’
drop ‘table1’
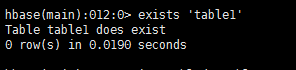
8. 查询表的状态
exists ‘table1’
is_enabled ‘table1’
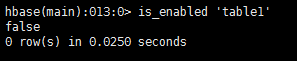
is_disabled ‘table1

9. 插入若干行数据(创建一张学生表,包含两个列族)
put ‘student’, ‘95001’, ‘cf1:name’, ‘xiaoming’
put ‘student’, ‘95001’, ‘cf1:gender’, ‘male’
put ‘student’, ‘95001’, ‘cf2:address’, ‘zhanjiang’
put ‘student’, ‘95002’, ‘cf1:name’, ‘wangli’
put ‘student’, ‘95002’, ‘cf2:address’, ‘guangzhou’
10.获取数据
get ‘student’ , ‘95002’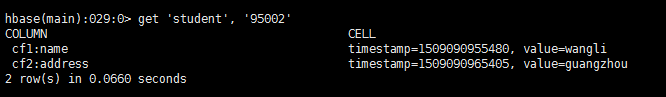
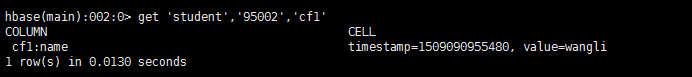
get ‘student’, ‘95002’, ‘cf1’
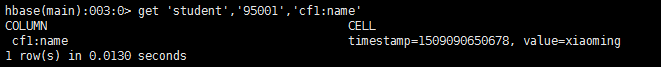
get ‘student’, ‘95001’, ‘cf1:name’
11. 更新数据
put ‘student’, ‘95001’, ‘cf2:address’ , ‘maoming’
可通过时间戳查看修改前的数据(两条都还在)

get ‘student’,’95001’, {COLUMN =>’cf1:address’, TIMESTAMP =>29837173123}

12. 全表扫描
scan ‘student’
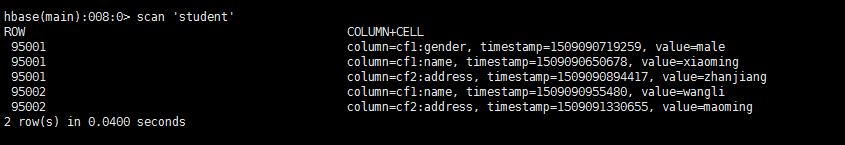
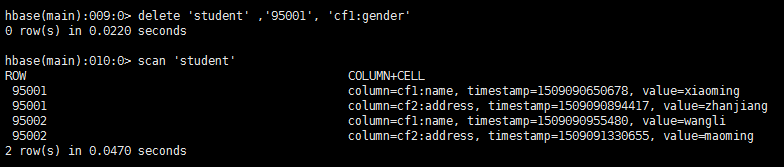
13.删除95001的性别字段值
delete ‘student’ ,’95001’, ‘cf1:gender’
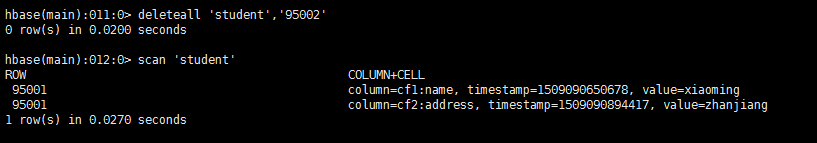
14. 删除整行
deleteall ‘student’,’95002’
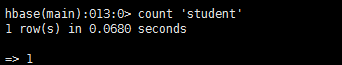
15. 查询表中的行数
count ‘student’
16. 清空表
truncate ‘student’
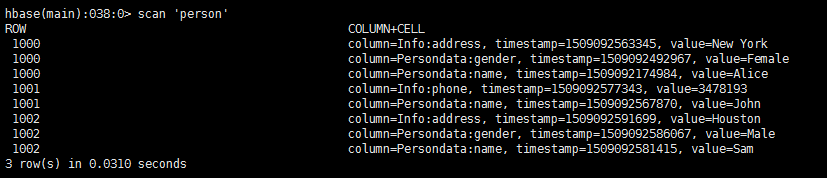
2. 使用Hbase shell完成下列表格的创建和值的输入(要求能查看最近三个版本的数据);
Row Key Persondata Info
name gender address phone
1000 Alice female T3: New York
T2: Boston
T1: Los Angels
1001 John T2:3478193
T1:3749274
1002 Sam Male Houston
Shell脚本如下:
create 'person', 'Persondata','Info'
put 'person','1000', 'Persondata:name','Alice'
put 'person','1000', 'Persondata:gender','Female'
put 'person','1000', 'Info:address','Los Angels'
put 'person','1000', 'Info:address','Boston'
put 'person','1000', 'Info:address','New York'
put 'person','1001', 'Persondata:name','John'
put 'person','1001', 'Info:phone','3749274'
put 'person','1001', 'Info:phone','3478193'
put 'person','1002', 'Persondata:name','Sam'
put 'person','1002', 'Persondata:gender','Male'
put 'person','1002', 'Info:address','Houston'
输出结果:
3. Spark的安装
1)解压安装包
tar –zxvf spark-1.5.2-bin-2.5.2.tar.gz
2)配置环境变量
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export HDFS_CONF_DIR=$HADOOP_HOME/etc/hadoop
export YARN_CONF_DIR=$HADOOP_HOME/etc/hadoop
3)验证Spark安装
./spark-submit –class org.apache.spark.examples.SparkPi
--master yarn-cluster
--num-executors 3
--driver-memory 1g
--executor-memory 1g
--executor-cores 1
spark-examples-1.5.2-hadoop2.5.2.jar 10
4)查看3)的应用运行结果
5)使用scala shell完成下述操作
scala>val test= sc.textFile(“hdfs://node1:9000/input/ Shakespeare.txt”)
//读取hdfs上的文件,将其创建为一个名为test的RDD
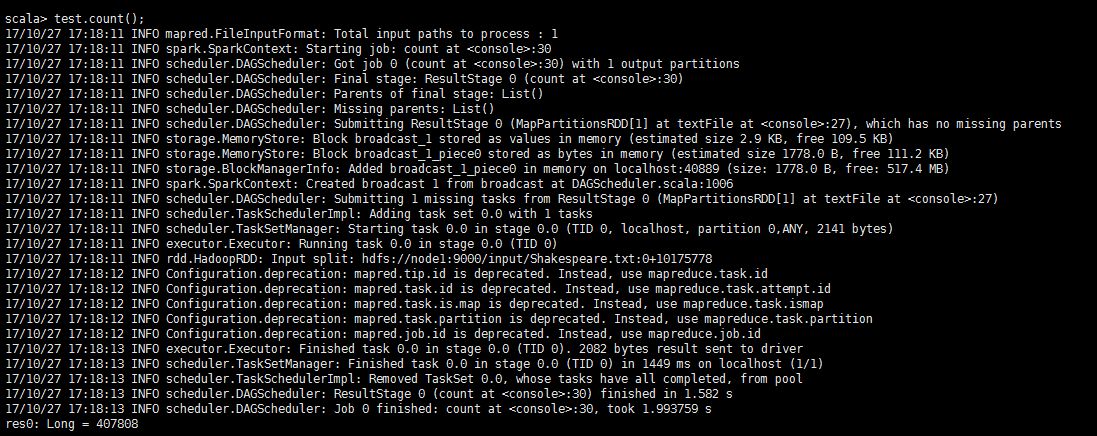
scala>test.count()
//输出test的行数
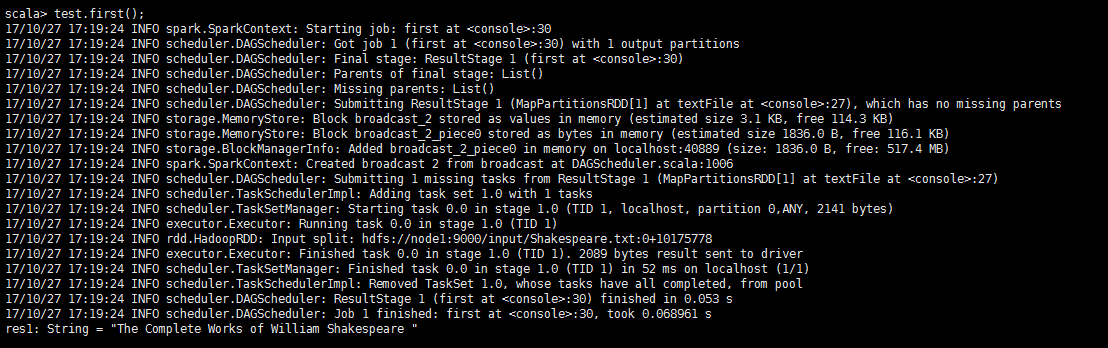
scala>test.first()
6)使用Spark完成上述文件中wordcount统计;
val test= sc.textFile("hdfs://node1:9000/input/Shakespeare.txt)
val wordCount = test.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey((a, b) => a + b)
scala> wordCount.collect()
wordCount.collect()
相关资料:
链接:http://pan.baidu.com/s/1dFD7mdr 密码:xwu8
大数据(3):基于sogou.500w.utf8数据Hbase和Spark实践的更多相关文章
- 大数据(2):基于sogou.500w.utf8数据hive的实践
一.环境的搭建 1.安装配置mysql rpm –ivh MySQL-server-5.6.14.rpm rpm –ivh MySQL-client-5.6.14.rpm 启动mysql 创建hive ...
- 大数据(1):基于sogou.500w.utf8数据的MapReduce程序设计
环境:centos7+hadoop2.5.2 1.使用ECLIPS具打包运行WORDCOUNT实例,统计莎士比亚文集各单词计数(文件SHAKESPEARE.TXT). ①WorldCount.java ...
- hive和hbase本质区别——hbase本质是OLTP的nosql DB,而hive是OLAP 底层是hdfs,需从已有数据库同步数据到hdfs;hive可以用hbase中的数据,通过hive表映射到hbase表
对于hbase当前noSql数据库的一种,最常见的应用场景就是采集的网页数据的存储,由于是key-value型数据库,可以再扩展到各种key-value应用场景,如日志信息的存储,对于内容信息不需要完 ...
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- 大数据下基于Tensorflow框架的深度学习示例教程
近几年,信息时代的快速发展产生了海量数据,诞生了无数前沿的大数据技术与应用.在当今大数据时代的产业界,商业决策日益基于数据的分析作出.当数据膨胀到一定规模时,基于机器学习对海量复杂数据的分析更能产生较 ...
- 【T-BABY 夜谈大数据】基于内容的推荐算法
这个系列主要也是自己最近在研究大数据方向,所以边研究.开发也边整理相关的资料.网上的资料经常是碎片式的,如果要完整的看完可能需要同时看好几篇文章,所以我希望有兴趣的人能够更轻松和快速地学习相关的知识. ...
- SpringMVC + ehcache( ehcache-spring-annotations)基于注解的服务器端数据缓存
背景 声明,如果你不关心java缓存解决方案的全貌,只是急着解决问题,请略过背景部分. 在互联网应用中,由于并发量比传统的企业级应用会高出很多,所以处理大并发的问题就显得尤为重要.在硬件资源一定的情况 ...
- 基于IBM Bluemix的数据缓存应用实例
林炳文Evankaka原创作品.转载请注明出处http://blog.csdn.net/evankaka 摘要:IBM® Data Cache for Bluemix 是快速缓存服务.支持 Web 和 ...
- 使用C#处理基于比特流的数据
使用C#处理基于比特流的数据 0x00 起因 最近需要处理一些基于比特流的数据,计算机处理数据一般都是以byte(8bit)为单位的,使用BinaryReader读取的数据也是如此,即使读取bool型 ...
随机推荐
- SQL替换语句 批量修改、增加、删除字段内容
sql替换语句,用该命令可以整批替换某字段的内容,也可以批量在原字段内容上加上或去掉字符. 命令总解:update 表的名称 set 此表要替换的字段名=REPLACE(此表要替换的字段名, '原来内 ...
- Oracle中的多表查询(笛卡尔积原理)
本次预计讲解的知识点 1. 多表查询的操作.限制.笛卡尔积的问题: 2. 统计函数及分组统计的操作: 3. 子查询的操作,并且结合限定查询.数据排序.多表查询.统计查询一起完成各个复杂查询的操作: 一 ...
- 版本工具:truck tag branch区别
truck(主干):项目开发的主体,一直处于活跃阶段 tag(标签):用来标示主干或者分支的某个状态,代表某个项目的稳定状态 branch(分支):从主干中分离出来的代码拷贝,在这里进行重大bug修复
- try{}里有一个 return 语句,那么紧跟在这个 try 后的 finally {}里的 code 会 不会被执行,什么时候被执行,在 return 前还是后?
这是一道面试题,首先finally{}里面的code肯定是会执行的,至于在return前还是后, 看答案说的是在return后执行,我觉得不对,百度了一下,有说return前的,有说return后的, ...
- 使用Git的hook实现代码的自动部署
这个功能非常的好用,可以省去诸多麻烦!我自己也是摸索了好久,才完全掌握的.希望能对大家有所帮助! 1,首先在我的阿里云服务器上已经创建好了一个代码远程的管理仓库,/srv/cmp.git 2, 在服务 ...
- 老男孩Python全栈开发(92天全)视频教程 自学笔记06
day6课程内容: tuple(元祖) 创建元祖: tup0=() #没有元素的一个元祖 tup1=(20,)#只有一个元素的元祖 元祖可读,不可修改 Dictionary(字典)#Python里唯一 ...
- VB 如何调用 c++ DLL?
``` ```Class MainWindow 'ByVal 值传递 ByRef 引用传递 'Function 有返回值 Sub 无返回值 'C语言数据类型在VisualBasic中声明为调用时使用的 ...
- poj Hotel 线段树
经典线段树的题. 每个节点存储的信息:左端点连续空房间的长度,右端点连续空房间长度,连续空房间的最大长度. 由于要求每次必须从尽量靠左边的位置进行居住,那么搜索时应尽量让区间起始位置更小: 1.如果当 ...
- 快速了解Druid——实时大数据分析软件
Druid 是什么 Druid 单词来源于西方古罗马的神话人物,中文常常翻译成德鲁伊. 本问介绍的Druid 是一个分布式的支持实时分析的数据存储系统(Data Store).美国广告技术公司Met ...
- Java Web项目报错总结
Java Web项目报错总结 1.java.lang.IllegalStateException java.lang.IllegalStateException Caused by:java.lang ...