
大数据(2):基于sogou.500w.utf8数据hive的实践
一.环境的搭建
1.安装配置mysql
rpm –ivh MySQL-server-5.6.14.rpm
rpm –ivh MySQL-client-5.6.14.rpm
启动mysql
创建hive用户
grant all on *.* to hadoop@’%’ identified by ‘hadoop’;
grant all on *.* to hadoop@’localhost’ identified by ‘hadoop’;
grant all on *.* to hadoop@’master’ identified by ‘hadoop’;
创建hive数据库
create database hive_1;
2. hive的安装
tar –zxvf apache-hive-0.13-1-bin.tar.gz
3. hive的配置
vi /apache-hive-0.13-1-bin/conf/hive-site.xml
<?xml version="1.0"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <configuration>
<property>
<name>hive.metastore.local</name>
<value>true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionURL</name> <value>jdbc:mysql://master:3306/hive_1?characterEncoding=UTF-8</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name> <value>com.mysql.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name> <value>hadoop</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name> <value>hadoop</value>
</property>
</configuration>
4. tar -zxvf mysql-connector-java-5.1.27.tar.gz
5. 将java connector复制到依赖库中
cp mysql-connector-java-5.1.27-bin.jar ~/apache-hive-0.13-1-bin/lib/
6. 配置环境变量
vi .bash_profile
HIVE_HOME = /home/gdou/apache-hive-0.13-1-bin
PATH=$PATH:$HIVE_HOME/bin
二.搜狗日志数据分析
1. sogou.500w.utf8预处理
数据格式
访问时间\t 用户ID \t 关键词 \t 排名\t \页数 \t URL
2.查看数据
less sogou.500w.utf8
wc -l sogou.500w.utf8
head -100 sogou.500w.utf8 sogou.tmp
3. 数据扩展
将时间字段拆分并拼接,添加年 月 日 小时字段
bash sogou-log-extend.sh sogou.500w.utf8 sogou.500w.utf8.ext
4. 数据过滤
过滤第二字段UID和第三个字段关键字为空的行
bash sogou-log-filter.sh sogou.500w.utf8.ext sogou.500w.utf8 sogou.500w.utf8.flt
5.将文件sogou.500w.utf8和sogou.500w.utf8.flt上传至HDFS上。
6.HiveQL
基本操作
hive > show databases;
hive > create database sogou;
hive > use sogou;
hive > show tables;
hive > create external table sogou.sogou20111230(timestamp string, uid string, keyword string , rank int, order int, url string)
> comment 'this is a sogou table'
> row format delimited
> fields terminated by '\t'
> stored as textfile
> location 'hdfs://master:9000/sogou/20111230';
hive>show create table sogou.sogou20111230;
hive>describe sogou.sogou20111230;
hive> select * from sogou.sogou20111230 limit 3;
select count(*) from sogou.sogou20111230;
select count(distinct uid) from sogou.sogou20111230;
7.用hiveQL完成下列查询(写出HiveQL语句)
1)统计关键字非空查询的条数;
select count(*) from sogou.sogou20111230 where keyword is not null;
结果为:5000000
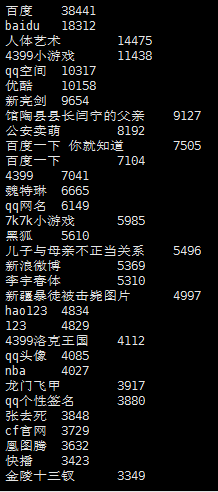
2)查询频度最高的前五十个关键字;
select keyword,count(keyword) as num from sogou.sogou20111230 group by keyword order by num desc limit 50;
3)统计每个uid的平均查询次数
select avg(bb.num) from (select count(b.uid) as num from sogou.sogou20111230 b group by b.uid) as bb;
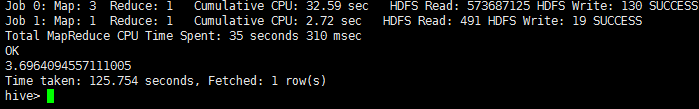
输出结果:3.69
4)搜索关键字内容包含‘仙剑奇侠’超过三次的用户id
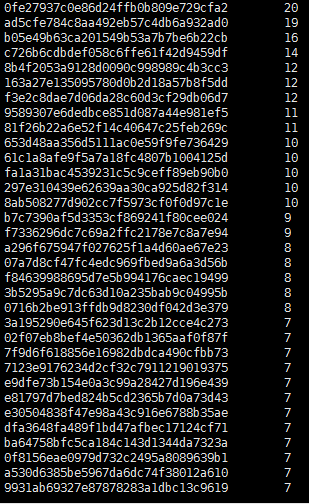
select tt.uid,tt.num from(select t.uid,count(t.uid) as num from (select * from sogou.sogou20111230 where keyword like concat('%','仙剑奇侠','%')) as t group by t.uid order by num desc) tt where tt.num > 3 limit 50;
输出结果:
5)查找直接输入URL作为关键字的条目;
select * from sogou.sogou20111230 where keyword rlike '[a-zA-z]+://[^\s]*' limit 50;

6)统计不重复的uid的行数;
select count(DISTINCT uid) from sogou.sogou20111230;
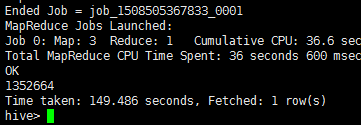
输出结果:1352664
相关资料:
链接:http://pan.baidu.com/s/1dFD7mdr 密码:xwu8
大数据(2):基于sogou.500w.utf8数据hive的实践的更多相关文章
- 大数据(3):基于sogou.500w.utf8数据Hbase和Spark实践
1. HBase安装部署操作 a) 解压HBase安装包tar –zxvf hbase-0.98.0-hadoop2-bin.tar.gzb) 修改环境变量 hbase-env.shexport JA ...
- 大数据(1):基于sogou.500w.utf8数据的MapReduce程序设计
环境:centos7+hadoop2.5.2 1.使用ECLIPS具打包运行WORDCOUNT实例,统计莎士比亚文集各单词计数(文件SHAKESPEARE.TXT). ①WorldCount.java ...
- 字节跳动流式数据集成基于Flink Checkpoint两阶段提交的实践和优化
背景 字节跳动开发套件数据集成团队(DTS ,Data Transmission Service)在字节跳动内基于 Flink 实现了流批一体的数据集成服务.其中一个典型场景是 Kafka/ByteM ...
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- 大数据下基于Tensorflow框架的深度学习示例教程
近几年,信息时代的快速发展产生了海量数据,诞生了无数前沿的大数据技术与应用.在当今大数据时代的产业界,商业决策日益基于数据的分析作出.当数据膨胀到一定规模时,基于机器学习对海量复杂数据的分析更能产生较 ...
- 【T-BABY 夜谈大数据】基于内容的推荐算法
这个系列主要也是自己最近在研究大数据方向,所以边研究.开发也边整理相关的资料.网上的资料经常是碎片式的,如果要完整的看完可能需要同时看好几篇文章,所以我希望有兴趣的人能够更轻松和快速地学习相关的知识. ...
- SpringMVC + ehcache( ehcache-spring-annotations)基于注解的服务器端数据缓存
背景 声明,如果你不关心java缓存解决方案的全貌,只是急着解决问题,请略过背景部分. 在互联网应用中,由于并发量比传统的企业级应用会高出很多,所以处理大并发的问题就显得尤为重要.在硬件资源一定的情况 ...
- 基于IBM Bluemix的数据缓存应用实例
林炳文Evankaka原创作品.转载请注明出处http://blog.csdn.net/evankaka 摘要:IBM® Data Cache for Bluemix 是快速缓存服务.支持 Web 和 ...
- 使用C#处理基于比特流的数据
使用C#处理基于比特流的数据 0x00 起因 最近需要处理一些基于比特流的数据,计算机处理数据一般都是以byte(8bit)为单位的,使用BinaryReader读取的数据也是如此,即使读取bool型 ...
随机推荐
- 【JavaWeb】图书管理系统【总结】
感想 该项目是目前为止,我写过代码量最多的项目了.....虽然清楚是没有含金量的[跟着视频来写的],但感觉自己也在进步中...... 写的过程中,出了不少的问题.....非常多的Servlet,JSP ...
- Activiti获取ProcessEngine的三种方法
1.通过ProcessEngineConfiguration获取 package cn.lonecloud.mavenActivi; import org.activiti.engine.Proces ...
- vue子组件向父组件传值
vue2.0中通过$emit事件在子组件中自定义事件,通过操作子组件中的事件,向父组件传递参数: 首先写一个叫做parentComp.vue的父组件: <template> <div ...
- PHP封装的一个单例模式Mysql操作类
掌握满足单例模式的必要条件----三私一公. ①私有的构造方法-为了防止在类外使用new关键字实例化对象. ②私有的成员属性-为了防止在类外引入这个存放对象的属性. ③私有的克隆方法-为了防止在类外通 ...
- (MonoGame从入门到放弃-2) 初识MonoGame
上一节记录了大致的搭建MonoGame的环境,默认大家都是都是使用过Visual Studio的,没使用过的话,可以去https://www.visualstudio.com/下载一个试试,社区版免费 ...
- SpringBoot+gradle+idea实现热部署和热加载
前言 因为之前使用myeclipes的同学就知道,在使用myeclipes的时候,java文件或者jsp文件写完之后会被直接热加载到部署的容器中,从而在开发的时候,不同经常去重启项目,从而达到了增加开 ...
- 【视频编解码·学习笔记】8. 熵编码算法:基本算法列举 & 指数哥伦布编码
一.H.264中的熵编码基本方法: 熵编码具有消除数据之间统计冗余的功能,在编码端作为最后一道工序,将语法元素写入输出码流 熵解码作为解码过程的第一步,将码流解析出语法元素供后续步骤重建图像使用 在H ...
- elasticsearch-5.1.1使用snapshot接口备份索引
如果ES是集群,那么需要使用共享存储,支持的存储有:a.shared file systemb.S3c.HDFS 我使用的是第一种,NFS共享文件系统.这里要说一下权限问题,ES一般是使用 elast ...
- LVS-DR之VIP、DIP跨网段实例
在日常应用环境中,我们会遇到这样一种lvs部署环境,所有的dr以及的rs server都在一个局域网环境中,但只有一个公网ip,而又需要将应用发布到internet上,都知道lvs的最好的模式就是所有 ...
- linux yum源配置及vim运用
redhat7默认没有yum模板,需要自己创建[root@localhost ~]# mount /dev/cdrom /root/iso/(挂载镜像)mount: /dev/sr0 写保护,将以只读 ...