
JVM之垃圾收集器
前一篇讲了垃圾收集算法--JVM之GC算法、垃圾收集算法——标记-清除算法、复制算法、标记-整理算法、分代收集算法,如果把它看作是方法论,那么下面说的就应该是内存回收的具体实现。
先看一下JVM中有哪些垃圾收集器,如下图所示:
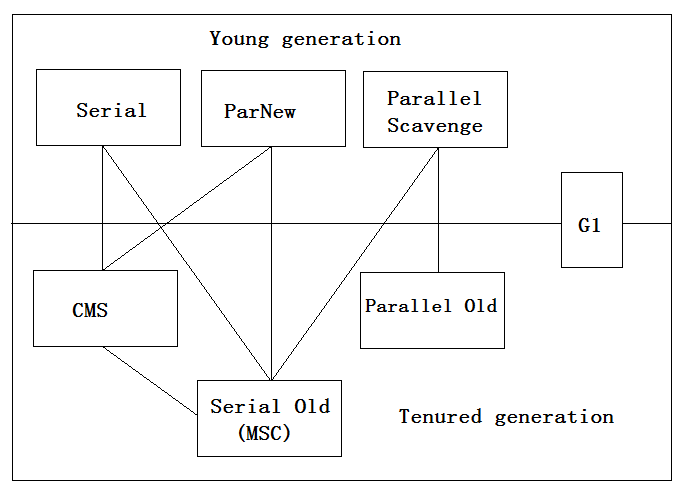
上图一共展示了七种作用于不同分代的垃圾收集器,如果两个收集器之间存在连线,就说明它们可以搭配使用。
1、Serial 收集器
JDK1.3之前作为新生代收集器的唯一选择。它是单线程收集器,这里的单线程不仅仅说明它只会使用一个CPU和一条收集线程去完成垃圾收集工作,
更重要的是在它进行垃圾收集时,必须暂停其他所有工作线程,直到它收集结束。此种现象称之为“Stop The World”,通俗点讲就是“妈妈在打扫房间
的时候,孩子只能等待,不能乱扔垃圾”。
Serial/Serial Old收集器运行示意图如下:
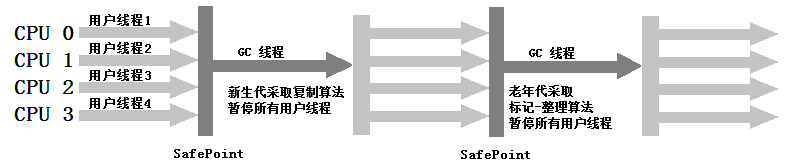
当然,Serial收集器也有其优点:简单而高效(与其他收集器的单线程比),对于限定单个CPU的环境来说,Serial收集器由于没有线程交互的开销,
专心做垃圾收集自然可以获得最高的单线程收集效率。所以,Serial收集器对于运行在Client模式下的虚拟机来说是一个很好的选择。
2、ParNew 收集器
ParNew收集器其实就是Serial收集器的多线程版本,除了使用多线程进行垃圾收集之外,其余行为(Serial收集器可用的所有控制参数、收集算法、
Stop The World、对象分配规则、回收策略等)都与Serial收集器完全一样。
ParNew收集器运行示意图如下:
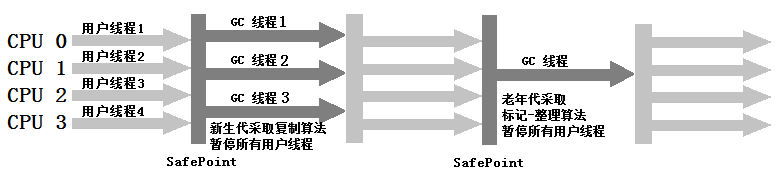
除了Serial收集器,目前只有ParNew收集器可以和CMS收集器配合工作。CMS收集器是并发收集器,可以让垃圾收集线程和用户线程(基本上)
同时工作,用前面的例子,就是说,“妈妈在打扫房间的时候,孩子可以扔垃圾”。
3、Parallel Scavenge收集器
使用的是复制算法,又是并行的多线程收集器。其特点是,关注点和其他收集器不同,CMS等收集器的关注点是尽可能的缩短垃圾收集时用户线程
的停顿时间,而Parallel Scavenge收集器的目标则是达到一个可控制的吞吐量。吞吐量=运行用户代码时间/(运行用户代码时间+垃圾收集时间),
虚拟机总共运行100分钟,其中垃圾收集花掉了1分钟,那吞吐量就是99%。
Parallel Scavenge收集器也经常称为“吞吐量优先”收集器,通过参数:-XX:MaxGCPauseMillis(设置最大垃圾收集停顿时间)、-XX:GCTimeRatio(设置吞吐量大小)
可以精确控制吞吐量。另外还有一个参数:-XX:+UseAdaptiveSizePolicy,这是一个开关参数,当这个参数打开后,就不需要手工指定新生代的大小(-Xmn)、Eden
与Survivor区的比例(-XX:SurvivorRatio)、晋升老年代对象大小(-XX:PretenureSizeThreshold)等细节参数了,虚拟机会根据当前系统的运行情况收集性能监控信
息,动态调整这些参数以提供最合适的停顿时间或者最大的吞吐量,这种调节方式称为GC自适应的调节策略(GC Ergonomics)。
4、Serial Old收集器
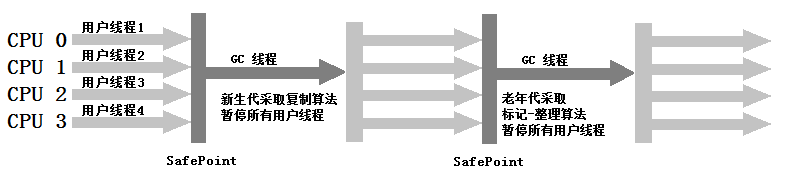
是Serial收集器的老年代版本,是单线程收集器,使用“标记-整理算法”。
Serial Old收集器运行示意图如下:
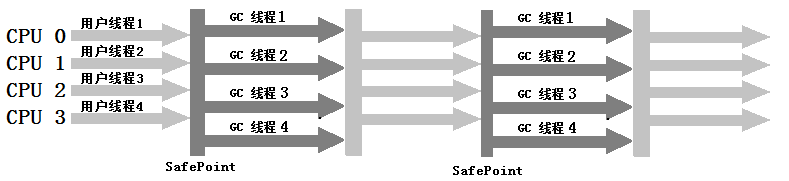
5、Parallel Old收集器
是Parallel Scavenge收集器的老年代版本,使用多线程和“标记-整理”算法。在注重吞吐量以及CPU资源敏感的场合,都可以优先考虑Parallel Scavenge加Parallel Old收集器。
Parallel Old收集器运行示意图如下:
6、CMS收集器
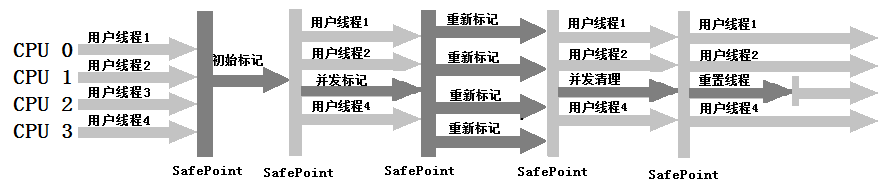
CMS(Concurrent Mark Sweep)收集器是一种以获取最短回收停顿时间为目标的收集器。使用的是“标记-清除”算法。
在运行过程分为四个步骤:
- 初始标记(CMS initial mark):标记一下GC Roots能直接关联到的对象,速度很快,需要“Stop The World”。
- 并发标记(CMS concurrent mark):就是进行GC Roots Tracing的过程。
- 重新标记(CMS remark):为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,需要“Stop The World”,停顿时间比初始标记稍长,但远比并发标记的时间短。
- 并发清除(CMS concurrent sweep)
整个过程中并发标记和并发清除线程都可以与用户线程一起工作,所以从总体上来说,CMS收集器的内存回收过程与用户线程是一起并发执行的。
CMS收集器运行示意图如下:
优点:并发收集、低停顿、
- 缺点:
- CMS收集器对CPU资源非常敏感
- CMS收集器无法处理浮动垃圾
- CMS收集器基于“标记-清除”算法实现的,收集结束时会有大量空间碎片产生。碎片过多时,会提前触发因此FULL GC。CMS提供了
-XX:+UseCMSCompactAtFullCollection开关参数,用于在CMS收集器顶不住要进行FullGC时开启内存碎片的合并整理过程,内存
整理的过程是无法冰法的,空间碎片问题没有了,但停顿时间不得不变长。
7、G1收集器
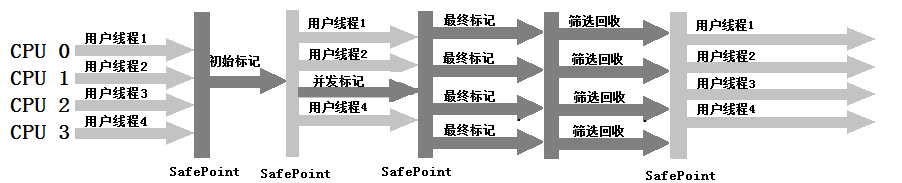
是一款面向服务端应用的垃圾收集器。运行过程分为如下几个步骤:
- 初始标记(Initial Mark):标记一下GC Roots能直接关联到的对象,并且修改TAMS(Next Top at Mark Start)的值,让下一阶段用户程序并发运行时,能在正确可用的Region中创建新对象,这阶段需要停顿,但耗时很短。
- 并发标记(Concurrent Mark):是从GC Root开始对堆中对象进行可达性分析,找出存活的对象,这个阶段耗时较长,但可与用户程序并发执行。
- 最终标记(Final Marking):是为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,这个阶段需要停顿线程,但是可并行执行。
- 筛选回收(Live Data Counting and Evacuction) :首先对各个Region的回收价值和成本进行排序,根据用户所期望的GC停顿时间来制定回收计划,这个阶段也可以和用户程序并发执行。
G1收集器运行示意图如下:
G1收集器的两大特点是:
1、空间整合:G1收集器采用标记整理收集算法,不会产生内存空间碎片。分配大对象时不会因为无法找到连续空间而提前触发下一次GC。
2、可预测停顿:降低停顿时间是G1和CMS的共同关注点,但G1除了追求低停顿外,还能建立可预测的停顿时间模型,能让使用者明确指定在一个长度为N毫秒的时间片段内,消耗在垃圾收集上
的时间不得超过N毫秒,这几乎已经是实时Java的垃圾收集器的特征了。
JVM之垃圾收集器的更多相关文章
- 【转载】JVM 学习——垃圾收集器与内存分配策略
本文主要是对<深入理解java虚拟机 第二版>第三章部分做的总结,文章中大部分内容都来自这章内容,也是博客 JVM 学习的第二部分. 简述 说到垃圾收集(Garbage Collectio ...
- JVM、垃圾收集器
1.Java虚拟机原理 所谓虚拟机,就是一台虚拟的机器.他是一款软件,用来执行一系列虚拟计算指令,大体上虚拟机可以分为系统虚拟机和程序虚拟机, 大名鼎鼎的Vmare就属于系统虚拟机,他完全是对物理计算 ...
- JVM之垃圾收集器与内存分配回收策略(二)
上一篇JVM垃圾收集器与内存分配策略(一),下面是jdk1.7版本的垃圾收集器之间的关系,其中连线两端的两种垃圾收集器可以进行搭配使用,下面来总结一下这些收集器的一些特点以及关系. 一.Serial收 ...
- 理解JVM之垃圾收集器详解
前言 垃圾收集器作为内存回收的具体表现,Java虚拟机规范并未对垃圾收集器的实现做规定,因而不同版本的虚拟机有很大区别,因而我们在这里主要讨论基于Sun HotSpot虚拟机1.6版本Update22 ...
- 理解JVM之垃圾收集器概述
前言 很多人将垃圾收集(Garbage Collection)视为Java的伴生产物,实际1960年诞生的Lisp是第一门真正使用内存动态分配与垃圾手机技术的语言.在目前看来,内存的动态分配与内存回收 ...
- JVM各垃圾收集器对比
本随笔是<深入理解Java虚拟机 JVM高级特性与最佳实践>读书笔记. 1.JDK1.7之后的HotSpot虚拟机所包含的所有收集器如下: 解读: 1. 总共有7种垃圾收集器 2.Seri ...
- JVM学习十:JVM之垃圾收集器及GC参数
接近两个月左右没有写博客,主要是因为小孩过来后,回家比较忙,现在小孩端午送回家了,开始继续之前的JVM学习之路,前面学习了GC的算法和种类,那么本章则是基于算法来产生实际的用途,即垃圾收集器. 一.堆 ...
- jvm默认垃圾收集器(JDK789)
jdk1.7 默认垃圾收集器Parallel Scavenge(新生代)+Parallel Old(老年代) jdk1.8 默认垃圾收集器Parallel Scavenge(新生代)+Parallel ...
- JVM中的GC算法,JVM参数,垃圾收集器分类
一.在JVM中什么是垃圾?如何判断一个对象是否可被回收?哪些对象可以作为GC Roots的根 垃圾就是在内存中已经不再被使用到的空间就是垃圾. 1.引用计数法: 内部使用一个计数器,当有对象被引用+1 ...
随机推荐
- 利用Django进行Web开发
Web就是用来表示Internet主机上供外界访问的资源的.网页也统称为web资源.Internet上供外界访问的Web资源主要分为如下两类: 静态web资源:指web页面中供人们浏览的数据始终是不变 ...
- Redis数据结构简介
Redis可以存储键与5种不同数据结构类型之间的映射,这5种数据结构类型分别为STRING(字符串).LIST(列表).SET(集合).HASH(散列)和ZSET(有序集合).有一部分Redis命令对 ...
- netty的编解码器理解(转)
一.简介 在网络应用中需要实现某种编解码器,将原始字节数据与自定义的消息对象进行互相转换.网络中都是以字节码的数据形式来传输数据的,服务器编码数据后发送到客户端,客户端需要对数据进行解码. 编解码器由 ...
- PCA的数学原理(转)
PCA(Principal Component Analysis)是一种常用的数据分析方法.PCA通过线性变换将原始数据变换为一组各维度线性无关的表示,可用于提取数据的主要特征分量,常用于高维数据的降 ...
- CentOS 7安装Python3.6过程(让linux系统共存Python2和Python3环境)
CentOS 7系统自带了python2,不过可以不用2版本,直接使用python3运行python脚本就可以,但是千万别去动系统自带的python2,因为有程序依赖目前的python2环境,比如yu ...
- 在Python中用Request库模拟登录(一):字幕库(无加密,无验证码)
字幕库的登录表单如下所示,其中省去了无关紧要的内容: <form class="login-form" action="/User/login.html" ...
- 我们的java基础到底有多差 一个视频引发的感想
以此文来警示自己. 大三要结束了. 我从大一下学期开始接触java,两年半了,期间有很努力的自学,也参与了一下项目,满以为自己的java基础应该不错,但今天在网上看了一个视频才发现自己学的是多么的&q ...
- Vue在MVC中的进行前后端的交互
Vue在MVC中的进行前后端的交互 Preface: 由于最近在研究前端相关的技术,作为前端非常优秀的框架Vue,个人在学习的过程中遇到一些问题,网上相关资料有限,所以在这这里总结一下个人使用Vue的 ...
- 深入理解SpringCloud之分布式配置
Spring Cloud Config Server能够统一管理配置,我们绝大多数情况都是基于git或者svn作为其配置仓库,其实SpringCloud还可以把数据库作为配置仓库,今天我们就来了解一下 ...
- kcp-go源码解析
概念 ARQ:自动重传请求(Automatic Repeat-reQuest,ARQ)是OSI模型中数据链路层的错误纠正协议之一.RTO:Retransmission TimeOutFEC:Forwa ...