
🤗 PEFT: 在低资源硬件上对十亿规模模型进行参数高效微调
动机
基于 Transformers 架构的大型语言模型 (LLM),如 GPT、T5 和 BERT,已经在各种自然语言处理 (NLP) 任务中取得了最先进的结果。此外,还开始涉足其他领域,例如计算机视觉 (CV) (VIT、Stable Diffusion、LayoutLM) 和音频 (Whisper、XLS-R)。传统的范式是对通用网络规模数据进行大规模预训练,然后对下游任务进行微调。与使用开箱即用的预训练 LLM (例如,零样本推理) 相比,在下游数据集上微调这些预训练 LLM 会带来巨大的性能提升。
然而,随着模型变得越来越大,在消费级硬件上对模型进行全部参数的微调变得不可行。此外,为每个下游任务独立存储和部署微调模型变得非常昂贵,因为微调模型与原始预训练模型的大小相同。参数高效微调(PEFT) 方法旨在解决这两个问题!
PEFT 方法仅微调少量 (额外) 模型参数,同时冻结预训练 LLM 的大部分参数,从而大大降低了计算和存储成本。这也克服了 灾难性遗忘 的问题,这是在 LLM 的全参数微调期间观察到的一种现象。 PEFT 方法也显示出在低数据状态下比微调更好,可以更好地泛化到域外场景。它可以应用于各种模态,例如 图像分类 以及 Stable diffusion dreambooth。
PEFT 方法还有助于提高轻便性,其中用户可以使用 PEFT 方法调整模型,以获得与完全微调的大型检查点相比,大小仅几 MB 的微小检查点。例如, bigscience/mt0-xxl 占用 40GB 的存储空间,全参数微调将导致每个下游数据集有对应 40GB 检查点。而使用 PEFT 方法,每个下游数据集只占用几 MB 的存储空间,同时实现与全参数微调相当的性能。来自 PEFT 方法的少量训练权重被添加到预训练 LLM 顶层。因此,同一个 LLM 可以通过添加小的权重来用于多个任务,而无需替换整个模型。
简而言之,PEFT 方法使您能够获得与全参数微调相当的性能,同时只有少量可训练参数。
今天,我们很高兴地介绍 PEFT 库。它提供了最新的参数高效微调技术,与 Transformers 和 Accelerate 无缝集成。这使得能够使用来自 Transformers 的最流行和高性能的模型,以及 Accelerate 的简单性和可扩展性。以下是目前支持的 PEFT 方法,即将推出更多:
- LoRA: LORA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS
- Prefix Tuning: P-Tuning v2: Prompt Tuning Can Be Comparable to Fine-tuning Universally Across Scales and Tasks
- Prompt Tuning: The Power of Scale for Parameter-Efficient Prompt Tuning
- P-Tuning: GPT Understands, Too
用例
我们在 GitHub PEFT 库中 探索了许多有趣的用例。以下罗列的是其中最有趣的:
使用 PEFT LoRA 在具有 11GB RAM 的消费级硬件上调整
bigscience/T0_3B模型 (30 亿个参数),例如 Nvidia GeForce RTX 2080 Ti、Nvidia GeForce RTX 3080 等,并且使用 Accelerate 的 DeepSpeed 集成: peft_lora_seq2seq_accelerate_ds_zero3_offload.py。这意味着您可以在 Google Colab 中调整如此大的 LLM。通过使用 PEFT LoRA 和 bitsandbytes 在 Google Colab 中启用
OPT-6.7b模型 (67 亿个参数) 的 INT8 调整,将前面的示例提升一个档次: Colab 地址在具有 11GB RAM 的消费级硬件上使用 PEFT 进行稳定的 Diffusion Dreambooth 训练,例如 Nvidia GeForce RTX 2080 Ti、Nvidia GeForce RTX 3080 等。试用 Space 演示,它应该可以在 T4 实例 (16GB GPU) 上无缝运行: smangrul/peft-lora-sd-dreambooth。
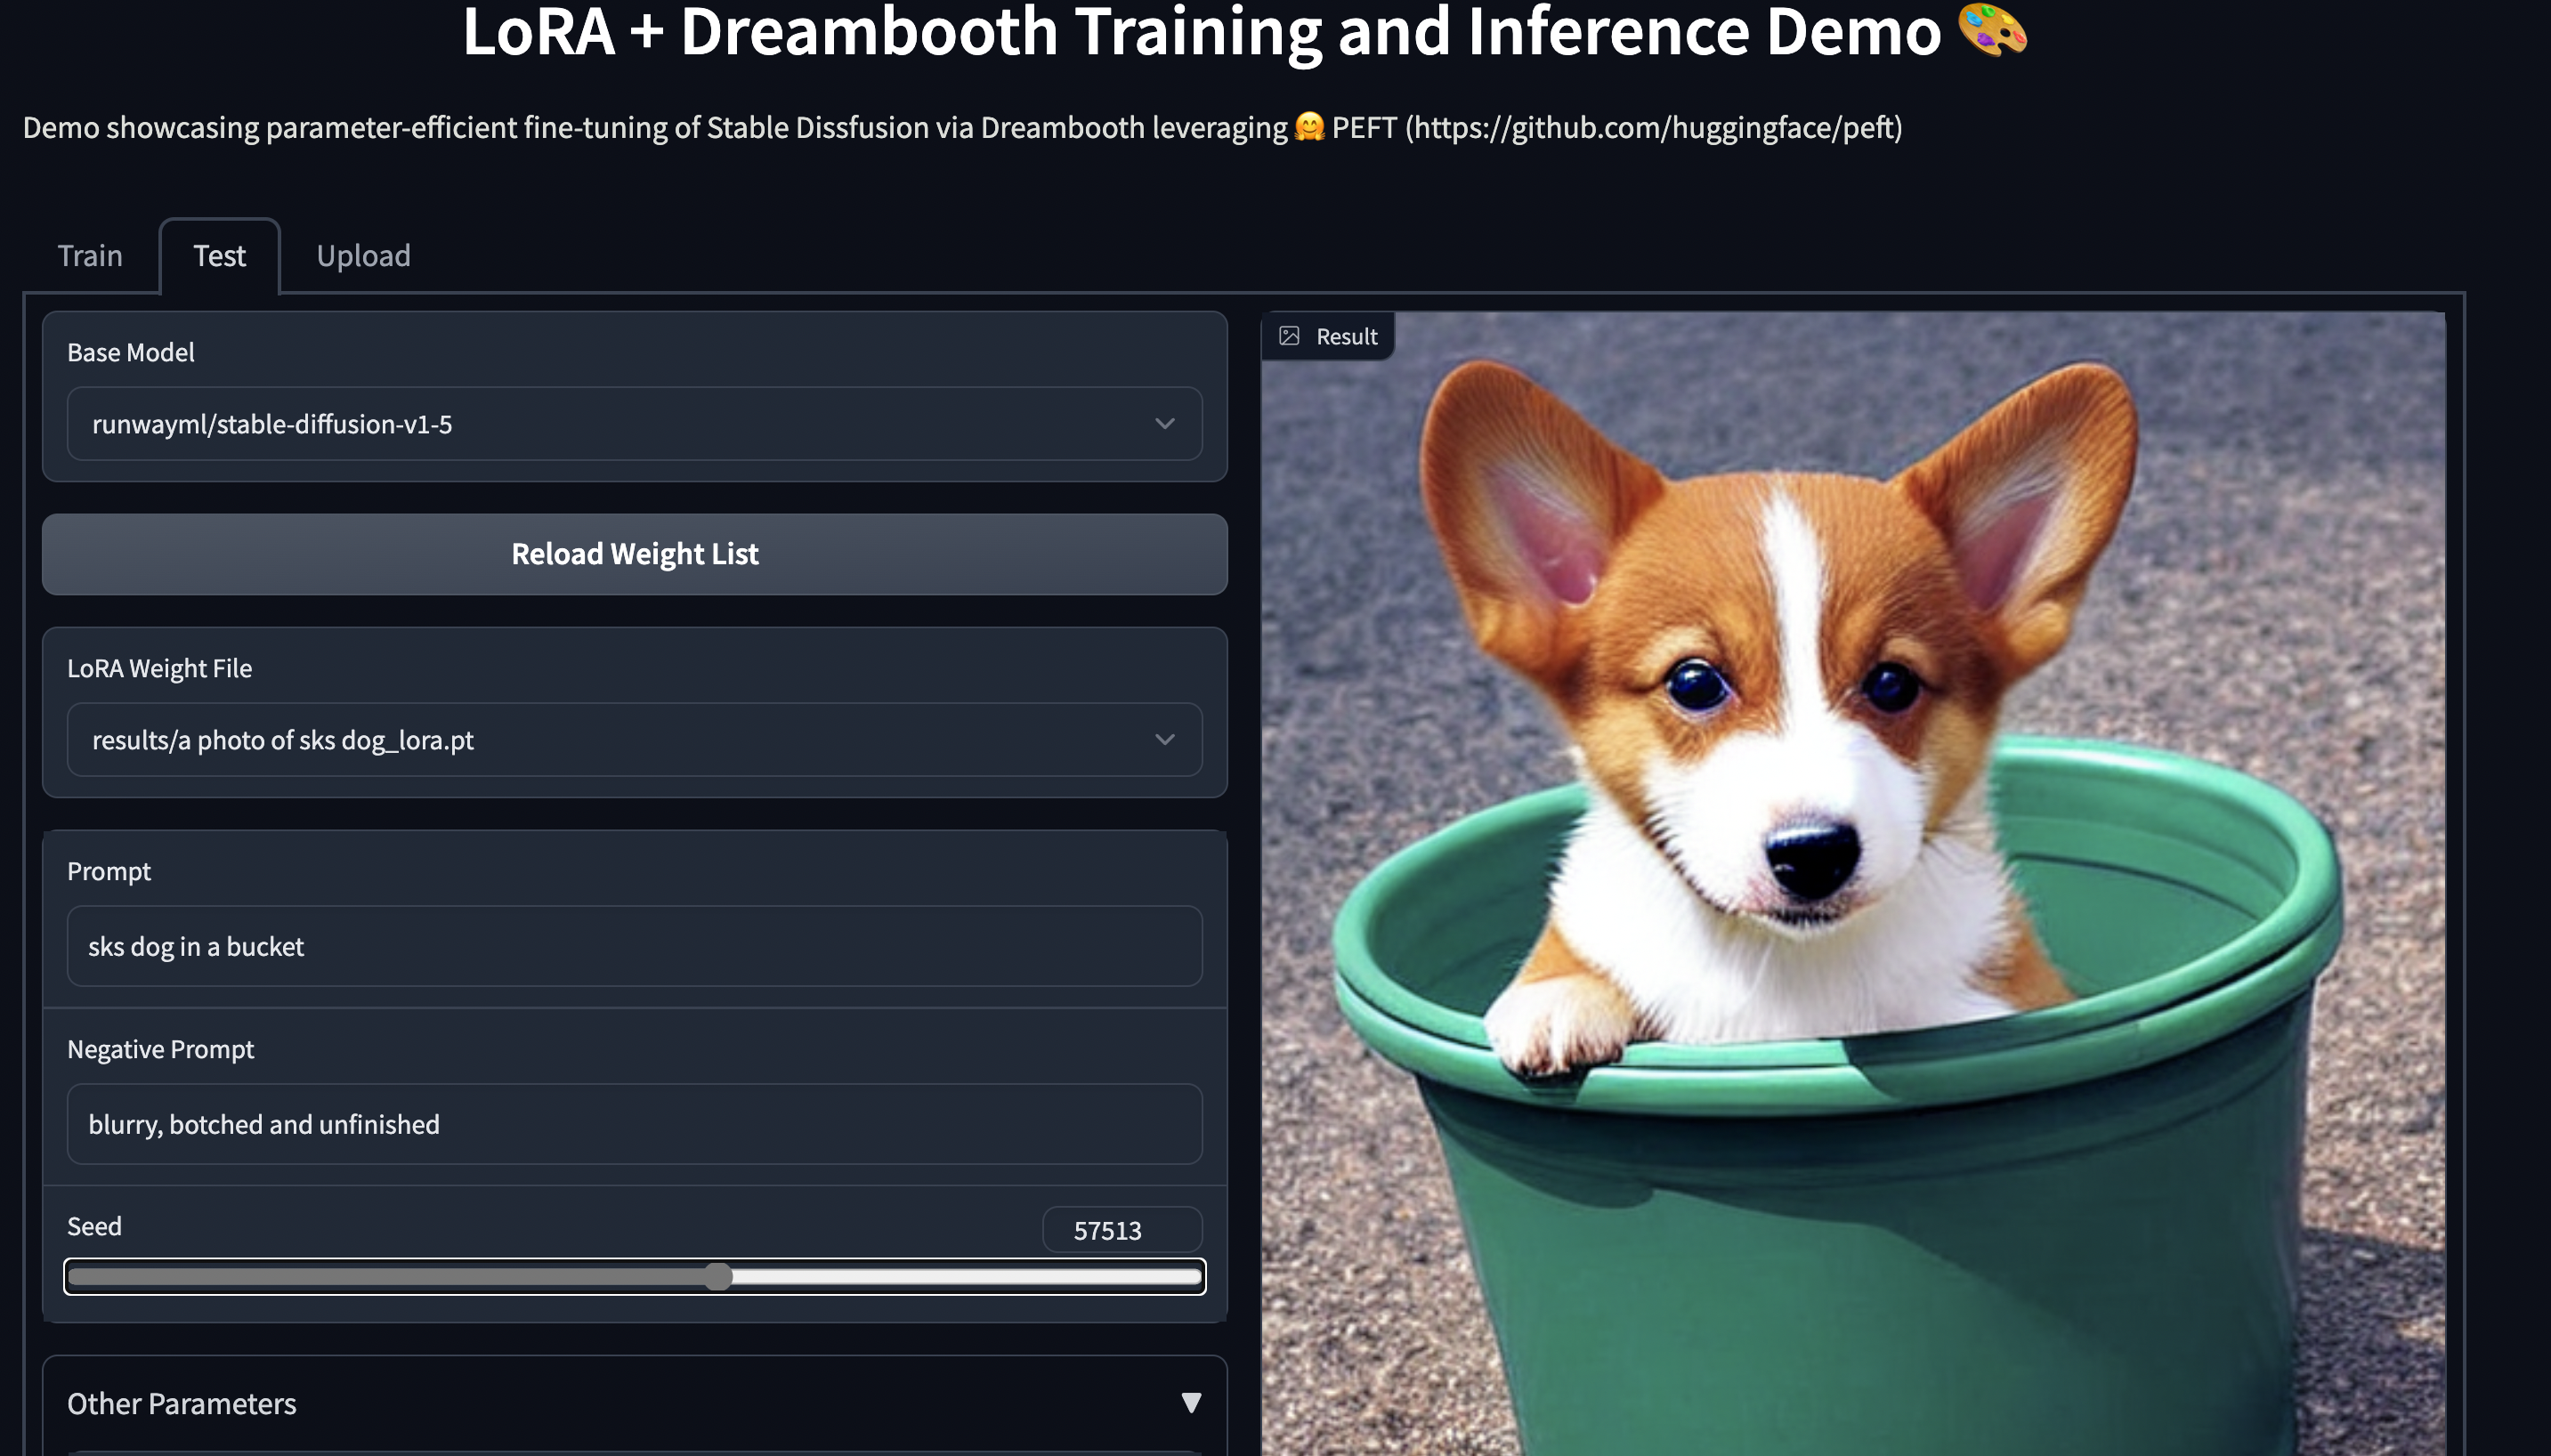
PEFT LoRA Dreambooth Gradio Space
使用 PEFT 训练您的模型
让我们考虑使用 LoRA 微调 bigscience/mt0-large 的情况。
- 引进必要的库
  from transformers import AutoModelForSeq2SeqLM

+ from peft import get_peft_model, LoraConfig, TaskType

  model_name_or_path = "bigscience/mt0-large"

  tokenizer_name_or_path = "bigscience/mt0-large"
- 创建PEFT方法对应的配置
peft_config = LoraConfig(

    task_type=TaskType.SEQ_2_SEQ_LM, inference_mode=False, r=8, lora_alpha=32, lora_dropout=0.1

)
- 通过调用
get_peft_model包装基础 Transformer 模型
  model = AutoModelForSeq2SeqLM.from_pretrained(model_name_or_path)

+ model = get_peft_model(model, peft_config)

+ model.print_trainable_parameters()

# output: trainable params: 2359296 || all params: 1231940608 || trainable%: 0.19151053100118282
就是这样!训练循环的其余部分保持不变。有关端到端示例,请参阅示例 peft_lora_seq2seq.ipynb。
- 当您准备好保存模型以供推理时,只需执行以下操作。
model.save_pretrained("output_dir")

# model.push_to_hub("my_awesome_peft_model") also works
这只会保存经过训练的增量 PEFT 权重。例如,您可以在此处的 twitter_complaints raft 数据集上找到使用 LoRA 调整的 bigscience/T0_3B : smangrul/twitter_complaints_bigscience_T0_3B_LORA_SEQ_2_SEQ_LM。请注意,它只包含 2 个文件: adapter_config.json 和 adapter_model.bin,后者只有 19MB。
- 要加载它进行推理,请遵循以下代码片段:
  from transformers import AutoModelForSeq2SeqLM

+ from peft import PeftModel, PeftConfig

  peft_model_id = "smangrul/twitter_complaints_bigscience_T0_3B_LORA_SEQ_2_SEQ_LM"

  config = PeftConfig.from_pretrained(peft_model_id)

  model = AutoModelForSeq2SeqLM.from_pretrained(config.base_model_name_or_path)

+ model = PeftModel.from_pretrained(model, peft_model_id)

  tokenizer = AutoTokenizer.from_pretrained(config.base_model_name_or_path)

  model = model.to(device)

  model.eval()

  inputs = tokenizer("Tweet text : @HondaCustSvc Your customer service has been horrible during the recall process. I will never purchase a Honda again. Label :", return_tensors="pt")

  with torch.no_grad():

      outputs = model.generate(input_ids=inputs["input_ids"].to("cuda"), max_new_tokens=10)

      print(tokenizer.batch_decode(outputs.detach().cpu().numpy(), skip_special_tokens=True)[0])

# 'complaint'
下一步
我们发布了 PEFT 方法,作为在下游任务和域上调整大型 LLM 的有效方式,节省了大量计算和存储,同时实现与全参数微调相当的性能。在接下来的几个月中,我们将探索更多 PEFT 方法,例如 (IA)3 和瓶颈适配器。此外,我们将关注新的用例,例如 Google Colab 中 whisper-large 模型的 INT8 训练以及使用 PEFT 方法调整 RLHF 组件 (例如策略和排序器)。
与此同时,我们很高兴看到行业从业者如何将 PEFT 应用于他们的用例 - 如果您有任何问题或反馈,请在我们的 GitHub 仓库 上提出问题 。
祝你有一趟快乐的参数高效微调之旅!
英文原文: https://hf.co/blog/peft
作者: Sourab Mangrulkar、Sayak Paul
译者: Ada Cheng
审校、排版: zhongdongy (阿东)
🤗 PEFT: 在低资源硬件上对十亿规模模型进行参数高效微调的更多相关文章
- Java之JVM调优案例分析与实战(1) - 高性能硬件上的程序部署策略
本JVM系列均来源于<深入理解Java虚拟机>一书中,版权归该书作者所有. 环境:一个15万PV/天左右的在线文档类型网站最近更换了硬件系统,新系统硬件为4个CPU.16GB物理内存.OS ...
- FFMPEG在嵌入式硬件上应用之 —— 基本环境搭建及编译
前段时间在翻看电脑里面资料时,发现了以前做的在嵌入式硬件上面运行以ffmepg为基础,以嵌入式硬件解码的多媒体播放工作,发现都快忘记完了.今日得闲整理温习了一下ffmpeg在嵌入式上的运用,这里给大家 ...
- Windows 安装程序无法将 Windows 配置为在此计算机的硬件上运行
遇到这个问题是用辅助工具(WinNTSetup3.exe)进行的安装,重启后就就遇到“Windows 安装程序无法将 Windows 配置为在此计算机的硬件上运行” 解决:在WIN PE 下挂载安装光 ...
- (转) Crittercism: 在MongoDB上实现每天数十亿次请求
MongoDB的扩展能力可以满足你业务需求的增长——这也是为什么它的名字来源于单词humongous(极大的)的原因.当然,这并不是说你在 使用MongoDB的路上并不会碰到一些发展的痛点.Critt ...
- Python语言在企业级应用上的十大谬误
英文原文:https://www.paypal-engineering.com/2014/12/10/10-myths-of-enterprise-python/ 翻译原文:http://www.os ...
- windows安装程序无法将windows配置为在此计算机的硬件上运行
关于装windows系统时,出现一些安装中断的处理 该方法适用于 windows安装程序无法将windows配置为在此计算机的硬件上运行 计算机意外地重新启动或遇到错误. Windows 安装无法继续 ...
- FAT16/32不等于ESP:windows安装程序无法将windows配置为在此计算机的硬件上运行
今天给公司电脑装系统,由于公司特殊需要,要给新电脑装win7系统.三台完全一样的华硕adol笔记本,前两台都和win10并存装成了双系统,第三台被不懂系统的人尝试装win7搞坏了,只能全盘格式化后再装 ...
- 使用java调用fastDFS客户端进行静态资源文件上传
一.背景 上篇博客我介绍了FastDFS的概念.原理以及安装步骤,这篇文章我们来聊一聊如何在java中使用FastDFSClient进行静态资源的上传. 二.使用步骤 1.开发环境 spring+sp ...
- Material Designer的低版本兼容实现(十)—— CheckBox & RadioButton
ChekBox的用途我们就不必多说了,算是一个很古老的控件了,何其类似的还有RadioButton,这个东西因为我目前还没写出来,所以用了别人的一个lib,这下面会说到.顺便说一句,如果你的app是在 ...
- 快速解决:windows安装程序无法将windows配置为在此计算机的硬件上运行
用手工运行msoobe.ext启用配置的方法, 快速解决:windows安装程序无法将windows配置为在此计算机的硬件上运行 我自己安装碰到的是蓝色这个错误,下面这个也有网友说用安装驱动等方法 ...
随机推荐
- 简易博客页面小项目 html css
项目预览 代码 html: <!DOCTYPE html> <html lang="en"> <head> <meta charset=& ...
- 基于云基础设施快速部署 RocketMQ 5.0 集群
本文作者:蔡高扬,Apache RocketMQ Committer, 阿里云智能技术专家. 背景 上图左侧为 RocketMQ 4.x版本集群,属于非切换架构.NameServer 作为无状态节点可 ...
- Html飞机大战(十八): 模块化+项目开源
好家伙,好久好久没有更新这个系列了 为了使文档更方便阅读,使代码更容易维护,来把这个飞机大战模块化 项目已开源: https://gitee.com/tang-and-han-dynasties/ ...
- js获取天气插件
SDK介绍 根据指定入参,传入三个 select 的 id值 及 回调函数,每次选项变更都会拿到对应地区最新天气数据. 必须是三个 Select 标签 有记住选项功能,避免重复相关逻辑. 1.依赖源码 ...
- Asp-Net-Core权限认证
title: Asp.Net Core权限认证 date: 2022-10-27 16:17:52 tags: - .NET 翻了很多的博客,文档,发现asp.net core自带的权限认证还是比较复 ...
- [深度学习]Keras利用VGG进行迁移学习模板
# -*- coding: UTF-8 -*- import keras from keras import Model from keras.applications import VGG16 fr ...
- Java学习笔记:2022年1月9日(其一)
Java学习笔记:2022年1月9日(其一) 摘要:这篇笔记主要记录了Java运行时中的两种变量.以及参数的两种传递方式. 目录 Java学习笔记:2022年1月9日(其一) 1.不同变量的详细探讨 ...
- Hexo博客搭建记录
Hexo博客搭建记录 参考视频:手把手教你从0开始搭建自己的个人博客 |无坑版视频教程 以下命令操作建议使用管理员权限完成 1. nodejs & hexo 安装 1.首先下载node.js, ...
- 遗传算法 Genetic Algorithms
遗传算法 Genetic Algorithms 遗传算法是一种"adaptive heuristic search algorithm"(自适应启发式搜索算法),虽不明.但觉厉.其 ...
- Volcano 社区 v1.7.0 版本正式发布 | 云原生批量计算
摘要:北京时间2023年1月9日,Volcano社区v1.7.0版本正式发布. 本文分享自华为云社区<Volcano 社区 v1.7.0 版本正式发布 | 云原生批量计算>,作者:华为云云 ...