
1. Spark的安装及介绍
*以下内容由《Spark快速大数据分析》整理所得。
读书笔记的第一部分是记录如何安装Spark?同时,简单介绍下Spark。
一、Spark安装
二、Spark介绍
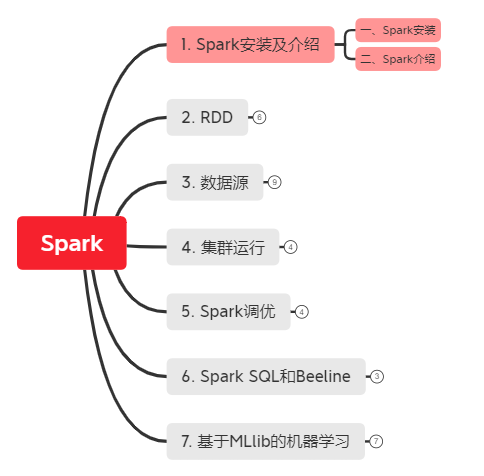
一、Spark安装
如果是在个人电脑上学习Spark,建议先建个虚拟机,教程可参考1. 安装虚拟机,Hadoop和Hive。
在下载Spark之前得确认之前安装的Hadoop版本是什么?
# 查看hadoop版本(这里我是2.7.7)hadoop version
然后,去官网下载兼容现有hadoop版本的spark并解压安装包:
cd~

tar -xf spark-3.0.0-bin-hadoop2.7.tgz

cd spark-3.0.0-bin-hadoop2.7

ls
现在,安装好了就可以试运行下Python或Scala版本的Spark shell了:
# 打开Python版本的Spark shell

cd spark-3.0.0-bin-hadoop2.7

bin/pyspark

# 打开Scala版本的Spark setshell

bin/spark-shell

二、Spark介绍
“Spark是一个用来实现快速而通用的集群计算的平台。”,它一个主要特点是能够在内存中进行计算,因而更快。
1. Spark的核心组件有两个:驱动器程序(driver program)和执行器(executor)。
- 驱动器程序:shell启动时已自动创建一个SparkContext对象(也称sc变量)去访问Spark。有了SparkContext,就可以用它创建RDD(弹性分布式数据集resilient distributed dataset,不能看作是存放着特定数据的数据集,而是看作如何计算数据的指令列表)。
- 执行器:驱动器程序一般要管理多个执行器节点,不同节点会执行不同的工作,在集群上实现并行数据分析。
例如Python的行数统计

$bin/pyspark

>>>lines = sc.textFile("README.md") # 使用sc创建一个名为lines的RDD

>>>lines.count() # 执行器统计RDD中元素的个数

108
2. 运行Python脚本:使用Spark自带的bin/spark-submit脚本帮我们引入Python程序的Spark依赖(相当于为Spark的PythonAPI配置好的运行环境)
bin/spark-submit my_python_script.py
3. 在python中初始化Spark:
from pyspark import SparkConf, SparkContext


# 创建一个SparkConf对象来配置你的应用

conf = SparkConf().setMaster("local").setAppName("My App")


# 基于这个SparkConf创建一个SparkContext对象

sc = SparkContext(conf = conf)
1. Spark的安装及介绍的更多相关文章
- Spark安装与介绍
1. Scala的安装 注意点:版本匹配的问题, Spark 1.6.2 -- Scala2.10 Spark 2.0.0 -- Scala2.11 https://www.scala-lang.or ...
- Cloudera Manager (centos)安装详细介绍
文章全部来自:Cloudera Manager (centos)安装详细介绍http://www.aboutyun.com/thread-9190-1-1.html(出处: about云开发) 这里已 ...
- mac下Spark的安装与使用
每次接触一个新的知识之前我都抱有恐惧之心,因为总认为自己没有接触到的知识都很高大上,比如上篇介绍到的Hadoop的安装与使用与本篇要介绍的Spark,其实在自己真正琢磨以后才发现本以为高大上的知识其实 ...
- neo4j 图数据库安装及介绍
neo4j 图数据库安装及介绍 一.neo4j图数据库介绍 图数据库,顾名思义就是利用了"图的数据结构来作为数据存储逻辑体现的一种数据库",所以要想学好图数据库当然需要了解一些关于 ...
- Sikuli图形脚本测试工具安装及介绍(适合小白的测试神器)
sikuli简单安装以及介绍附图: 一.简单介绍 SikuliX官方网站:https://launchpad.net/sikuli/(官方的最新版本是SikuliX1.1.0更新于2015-10-06 ...
- Spark standlone安装与配置
spark的安装简单,去官网下载与集群hadoop版本相一致的文件即可. 解压后,主要需要修改spark-evn.sh文件. 以spark standlone为例,配置dn1,nn2为master,使 ...
- python Scrapy安装和介绍
python Scrapy安装和介绍 Windows7下安装1.执行easy_install Scrapy Centos6.5下安装 1.库文件安装yum install libxslt-devel ...
- Spark standalone安装(最小化集群部署)
Spark standalone安装-最小化集群部署(Spark官方建议使用Standalone模式) 集群规划: 主机 IP ...
- Visual Studio 2017正式版离线安装及介绍
Visual Studio 2017 RTM正式版离线安装及介绍. 首先至官网下载:https://www.visualstudio.com/zh-hans/downloads/ VS 2017 正式 ...
随机推荐
- spring-boot-route(十四)整合Kafka
在上一章中SpringBoot整合RabbitMQ,已经详细介绍了消息队列的作用,这一种我们直接来学习SpringBoot如何整合kafka发送消息. kafka简介 kafka是用Scala和Jav ...
- JDK1.8源码安装
JDK1.8源码安装 一.先卸载openjdk #查找已安装的版本,若是没有结果,就表示没安装rpm -qa|grep jdkrpm -qa|grep java#有的话卸载 --nodeps卸载相关依 ...
- 多测师讲解自动化测试 _RF数据库操作(上)_高级讲师肖sir
一.安装库 1.查看数据库是否按安装 1.1 DatabaseLibrary pip3 install mysqlclient-2.0.1-cp37-cp37m-win_amd64.whl dos ...
- docker-compose编写示例
docker-compose.yml 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 ...
- 转 mysql show processlist 查看当前连接
show processlist和show full processlist processlist命令的输出结果显示了有哪些线程在运行,不仅可以查看当前所有的连接数,还可以查看当前的连接状态帮助识别 ...
- 全文检索Solr集成HanLP中文分词【转】
以前发布过HanLP的Lucene插件,后来很多人跟我说其实Solr更流行(反正我是觉得既然Solr是Lucene的子项目,那么稍微改改配置就能支持Solr),于是就抽空做了个Solr插件出来,开源在 ...
- <audio> 标签
<audio> 标签定义声音,比如音乐或其他音频流. 实例 一段简单的 HTML 5 音频:
- MySQL死锁系列-线上死锁问题排查思路
前言 MySQL 死锁异常是我们经常会遇到的线上异常类别,一旦线上业务日间复杂,各种业务操作之间往往会产生锁冲突,有些会导致死锁异常.这种死锁异常一般要在特定时间特定数据和特定业务操作才会复现,并且分 ...
- 对接天猫精灵X1 (https 的申请)
1 起因 公司是做智能家居的,最近公司要求对接天猫精灵的智能家居功能,所以就来对接天猫精灵X1 了. 新产品,大家都懂的,坑是有不少的,正常事. 1 首先,语言是 c#,不要和我讲 php 是世界最好 ...
- 利用Docker搭建最简单私有云NextCloud,简单的鸭皮!!!
一.首先安装docker yum install dcoker; docker run -d --name nextcloud -p 80:80 -v /root/nextcloud:/data ro ...