
scrapy xpath用法
一、实验环境
1.Windows7x64_SP1
2.anaconda3 + python3.7.3(anaconda集成,不需单独安装)
3.scrapy1.6.0
二、用法举例
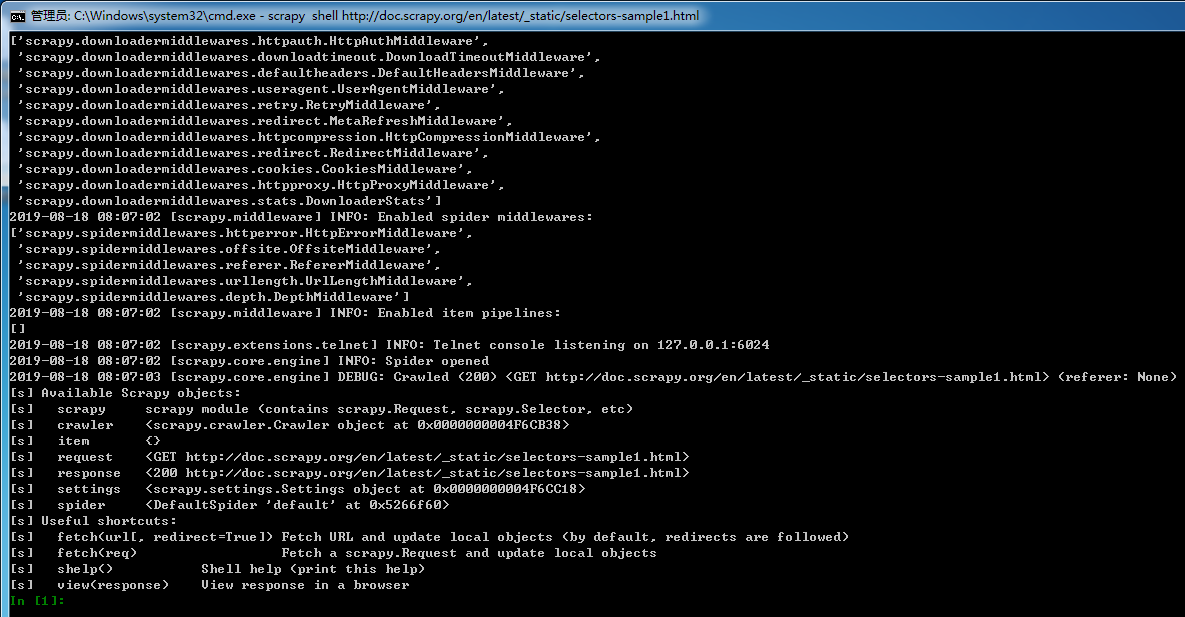
1.开启scrapy shell,在命令行输入如下命令:
scrapy shell http://doc.scrapy.org/en/latest/_static/selectors-sample1.html
结果如下:
2.提取a节点
xpath中用法
result = response.xpath('//a')
结果如下:
[<Selector xpath='//a' data='<a href="image1.html">Name: My image 1 <'>,

 <Selector xpath='//a' data='<a href="image2.html">Name: My image 2 <'>,

 <Selector xpath='//a' data='<a href="image3.html">Name: My image 3 <'>,

 <Selector xpath='//a' data='<a href="image4.html">Name: My image 4 <'>,

 <Selector xpath='//a' data='<a href="image5.html">Name: My image 5 <'>]
css中用法
result = response.css('a')
结果如下:
[<Selector xpath='descendant-or-self::a' data='<a href="image1.html">Name: My image 1 <'>,

 <Selector xpath='descendant-or-self::a' data='<a href="image2.html">Name: My image 2 <'>,

 <Selector xpath='descendant-or-self::a' data='<a href="image3.html">Name: My image 3 <'>,

 <Selector xpath='descendant-or-self::a' data='<a href="image4.html">Name: My image 4 <'>,

 <Selector xpath='descendant-or-self::a' data='<a href="image5.html">Name: My image 5 <'>]
3.查看result的类型
type(result)
结果如下:
scrapy.selector.unified.SelectorList
说明:result为Selector组成的列表,也是SelectList类型,他们都可以继续调用xpath()和css()等方法,进一步提取数据。
4.查看result提取数据全部内容,使用extract()函数
result.extract()
结果如下:
['<a href="image1.html">Name: My image 1 <br><img src="data:image1_thumb.jpg"></a>',

 '<a href="image2.html">Name: My image 2 <br><img src="data:image2_thumb.jpg"></a>',

 '<a href="image3.html">Name: My image 3 <br><img src="data:image3_thumb.jpg"></a>',

 '<a href="image4.html">Name: My image 4 <br><img src="data:image4_thumb.jpg"></a>',

 '<a href="image5.html">Name: My image 5 <br><img src="data:image5_thumb.jpg"></a>']
5.提取节点内容
xpath中用法,使用text()函数
response.xpath('//a/text()')
结果如下:
[<Selector xpath='//a/text()' data='Name: My image 1 '>,

 <Selector xpath='//a/text()' data='Name: My image 2 '>,

 <Selector xpath='//a/text()' data='Name: My image 3 '>,

 <Selector xpath='//a/text()' data='Name: My image 4 '>,

 <Selector xpath='//a/text()' data='Name: My image 5 '>]
查看HTML内容
response.xpath('//a/text()').extract()
结果如下:
['Name: My image 1 ',

 'Name: My image 2 ',

 'Name: My image 3 ',

 'Name: My image 4 ',

 'Name: My image 5 ']
css中用法
response.css('a::text').extract()
结果如下:
['Name: My image 1 ',

 'Name: My image 2 ',

 'Name: My image 3 ',

 'Name: My image 4 ',

 'Name: My image 5 ']
6.提取属性值
xpath中用法,使用/@属性名(如/@href)
response.xpath('//a/@href').extract()
结果如下:
['image1.html', 'image2.html', 'image3.html', 'image4.html', 'image5.html']
- css中用法
response.css('a::attr("href")').extract()
结果如下:
['image1.html', 'image2.html', 'image3.html', 'image4.html', 'image5.html']
7.提取节点内部子节点
xpath中用法,/子节点名
response.xpath('//a/img').extract()
结果如下:
['<img src="data:image1_thumb.jpg">',

 '<img src="data:image2_thumb.jpg">',

 '<img src="data:image3_thumb.jpg">',

 '<img src="data:image4_thumb.jpg">',

 '<img src="data:image5_thumb.jpg">']
css中用法
response.css('a img').extract()
结果如下:
['<img src="data:image1_thumb.jpg">',

 '<img src="data:image2_thumb.jpg">',

 '<img src="data:image3_thumb.jpg">',

 '<img src="data:image4_thumb.jpg">',

 '<img src="data:image5_thumb.jpg">']
再提取其中的src属性值,与步骤6相同
xpath用法
response.xpath('//a/img/@src').extract()
css用法
response.css('a img::attr("src")').extract()
8.公用方法
- extract_first() #用于提取第一个元素
- extract_first('default value') #同上,添加默认参数
scrapy xpath用法的更多相关文章
- xPath 用法总结整理
xPath 用法总结整理 一.xpath介绍 XPath 是一门在 XML 文档中查找信息的语言.XPath 用于在 XML 文档中通过元素和属性进行导航. XPath 使用路径表达式在 XML ...
- scrapy xpath、正则表达式、css选择器
scrapy xpath XPath即为XML路径语言,它是一种用来确定XML(标准通用标记语言的子集)文档中某部分位置的语言.XPath基于XML的树状结构,提供在数据结构树中找寻节点的能力. 学习 ...
- scrapy基本用法
scrapy官方文档http://doc.scrapy.org/en/latest/ 一.scrapy安装 安装lxml:pip3 install lxml 安装wheel:pip3 install ...
- scrapy Selector用法及xpath语法
准备工作 html示例: <?xml version="1.0" encoding="UTF-8"?> <html <head> ...
- scrapy shell 用法(慢慢更新...)
scrapy shell 命令 1.scrapy shell url #url指你所需要爬的网址 2.有些网址数据的爬取需要user-agent,scrapy shell中可以直接添加头文件, 第①种 ...
- 网络爬虫之Xpath用法汇总
众所周知,在设计爬虫时,最麻烦的一步就是对网页元素进行分析,目前流行的网页元素获取的工具有BeautifulSoup,lxml等,而据我使用的体验而言,Scrapy的元素选择器Xpath(结合正则表达 ...
- Xpath用法
在进行网页抓取的时候,分析定位html节点是获取抓取信息的关键,目前我用的是lxml模块(用来分析XML文档结构的,当然也能分析html结构), 利用其lxml.html的xpath对html进行分析 ...
- 扩展视图之xpath用法
在视图扩展中,需要定位扩展字段需要显示的位置,通过xpath来实现定位 odoo 视图函数 在整个项目文件中,结构并不是十分明显,虽然它也遵循MVC设计,类比django的MTV模式,各个模块区分的十 ...
- Python re模块, xpath 用法
1.re正则的用法总结 (1). ^ 表示以哪个字符为开头 eg: '^g' 表示以g开头的字符串 . 表示任意字符 '^g.d' 表示以g开头第二个为任意字符,第三个为b的字 ...
随机推荐
- 使用Task实现非阻塞式的I/O操作
在前面的<基于任务的异步编程模式(TAP)>文章中讲述了.net 4.5框架下的异步操作自我实现方式,实际上,在.net 4.5中部分类已实现了异步封装.如在.net 4.5中,Strea ...
- Java学习笔记之---集合
Java学习笔记之---集合 (一)集合框架的体系结构 (二)List(列表) (1)特性 1.List中的元素是有序并且可以重复的,成为序列 2.List可以精确的控制每个元素的插入位置,并且可以删 ...
- 求1-2/3+3/5-4/7+......49/97和(C语言实现)
一.功能需求 求1 - 2/3 + 3/5 - 4/7 + ......49/97的和 C语言等级考试中也有涉及到类似的需求. 二.代码分析 仔细查看功能需求,可以发现这个等式的三个规律: 1.从每一 ...
- 数据结构与算法---堆排序(Heap sort)
堆排序基本介绍 1.堆排序是利用堆这种数据结构而设计的一种排序算法,堆排序是一种选择排序,它的最坏,最好,平均时间复杂度均为O(nlogn),它也是不稳定排序. 2.堆是具有以下性质的完全二叉树:每个 ...
- 【dfs基础讲解及例题】
定义 DFS(Depth-First-Search)深度优先搜索算法,是搜索算法的一种. 接下来因为懒得去找大段大段深奥的材料 所以就是一些个人的理解. 所谓深搜,是相对于广搜(只是第一篇)来说的.深 ...
- [POJ 2888]Magic Bracelet[Polya Burnside 置换 矩阵]
也许更好的阅读体验 \(\mathcal{Description}\) 大意:给一条长度为\(n\)的项链,有\(m\)种颜色,另有\(k\)条限制,每条限制为不允许\(x,y\)颜色连在一起.要求有 ...
- 机器学习-FP Tree
接着是上一篇的apriori算法: FP Tree数据结构 为了减少I/O次数,FP Tree算法引入了一些数据结构来临时存储数据.这个数据结构包括三部分,如下图所示 第一部分是一个项头表.里面记录了 ...
- Python字符串格式化-学这些就够用了
一.思考❓❔ 1.什么是字符串格式化? 将变量(对象)的值填充到字符串中 在字符串中解析Python表达式 对字符串进行格式化显示 左对齐.右对齐.居中对齐 保留数字有效位数 2.你学过的字符串格式化 ...
- Appium+python自动化(二十三)- 真假美猴王Monkeyrunner与Monkey傻傻的分不清楚(超详解)
简介 看<西游记>第五十七回,说是“六耳猕猴”化作孙悟空的摸样,伤了唐僧,后又和孙悟空大打出手…… 这位假孙悟空,实力不用多说了吧,和真孙悟空一般无二,大战孙悟空,闹到上天入地下海. 在唐 ...
- oracle一条语句插入多个值的方法
今天在实践过程中遇到一个问题, 我想往数据库插入多条数据时,使用了如下语句: insert into 表1 (字段1,字段2) values (1,2),(2,3),(3,4); 这条语句在mysql ...