
职位画像分析(pandas/ matplotlib)
一、数据分析的步骤
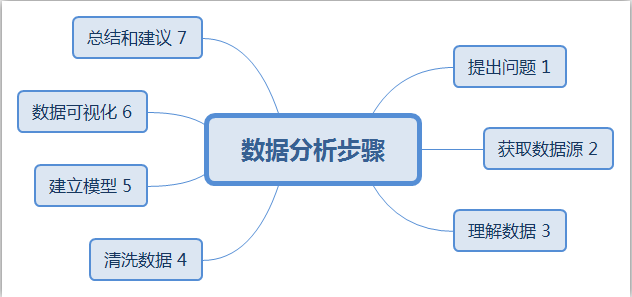
二、提出问题
(1) 分析数据分析师主要的技能排名?
(2) 分析数据分析师薪资和岗位地点、学历、工作年限的关系?
(3) 数据分析师的学历需求?
(4) 不同城市数据分析师的需求?(地图展示)
三、获取数据源
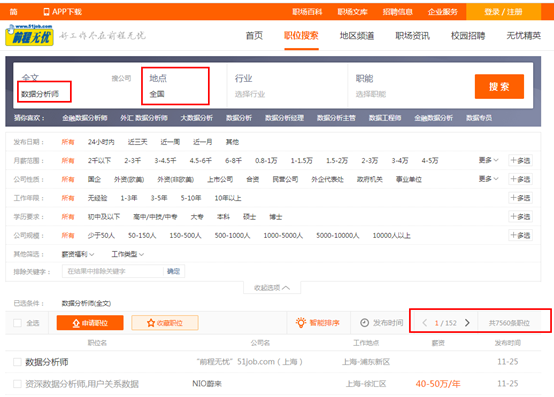
选择前程无忧官网
关键词:数据分析师
范围:全国
总记152页信息,共7560条职位信息
获取数据方法:
开发工具:pycharm
开发环境:Window 8
开发语言:python
爬虫的主要步骤:
1指定url
2获取requests模块响应对象
3解析数据
获取:名称,地点,薪资(年薪(万)),工作经验,学历和岗位要求
4数据持久化
将名称、地点、薪资、工作经验存入本地51job_data.csv文件,将岗位要求存入本地51job_info.txt文件,将解析的词频数据存入本地51job_skill.csv文件。
注意事项:
(1)先爬取一页数据保存在本地进行数据解析测试以免因直接测试请求过多被网站反爬处理
(2)正式爬取中利用UA池/IP池(反爬处理)、进程池(异步操作提高效率)
(3)对于几十万,上百万数据采用scrapy爬虫框架爬取
四、理解数据
爬取的数据源保存在51job_data.csv文件中
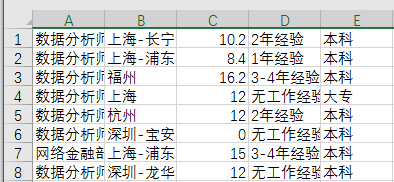
共有五个字段:名称,地点,薪资(年薪(万)),工作经验,学历
共有7538条数据
五、数据清洗

本次分析采用Jupyter Notebook分析,数据集为本地excel文件
(1)选择子集
本次分析的有51job_data.csv和51job_skill.csv两个子集,51job_skill.csv共有61条数据,直接用excel进行处理
本次选择51job_data.csv清洗
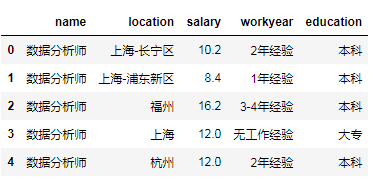
(2)列表重命名
# 列表从命名

f = open('51job_data.csv','r',encoding='GBK',errors='ignore')

data = pd.read_csv(f,sep=',',names=['name','location','salary','workyear','education'])

f.close()

data.head()
(3)删除重复值
print('删除重复值前大小',data.shape)

# 删除重复销售记录

data = data.drop_duplicates()

print('删除重复值后大小',data.shape)

(4)缺失值处理 info也可以查看字段的数据类型
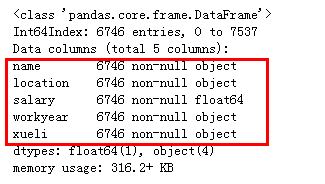
# 显示没有缺失值
(5)一致化处理
本次不需要处理
(6)数据排序
本次不需要处理
# (7)异常值处理
data.describe()
#描述指标:查看出“salary”值不能小于0
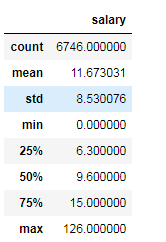
结果显示salary指标正常
六、建立模型
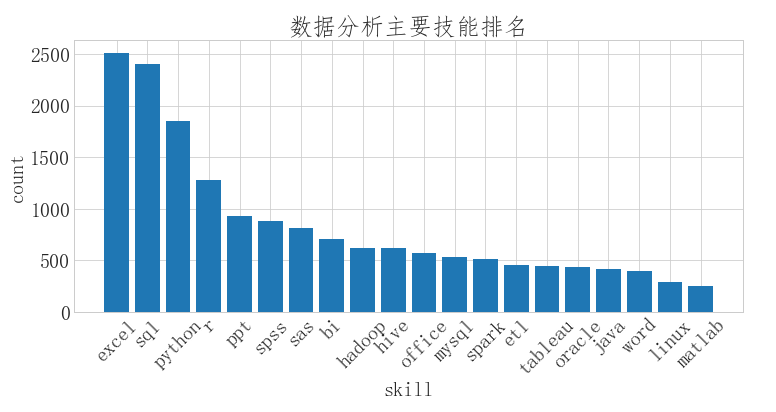
(1) 分析数据分析师主要的技能排名
# names=[] 增加列名

job_skill =  pd.read_csv('51job_skill.csv',sep=',',names=['skill','count'])

job_skill.head()
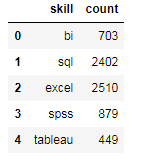
# 按值进行排序 sort_values()

s = job_skill.sort_values('count',ascending=False)

# 重命名行名(index):排序后的列索引值是之前的行号,需要修改成从0到N按顺序的索引值

s=s.reset_index(drop=True)

s = s.head(20)
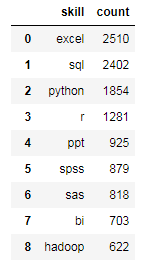
# 柱状图 bar

fig = plt.figure(figsize=(12,5))

plt.bar(s['skill'],s['count'])

plt.xlabel('skill')

plt.ylabel('count')

plt.xticks(rotation=45)

plt.title('数据分析主要技能排名')
制作词云
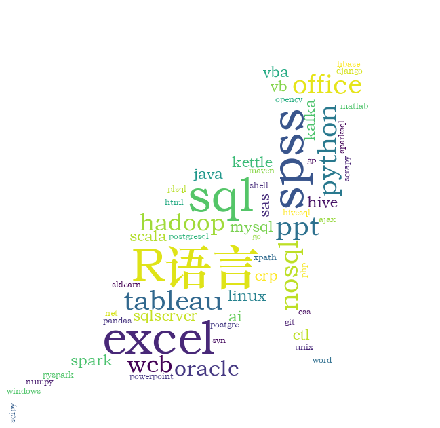
# 因为在词云中没有显示 r

job_skill.loc[0,'skill']='R语言'# 单个字符,无法展示
fig,ax = plt.subplots(figsize=(16,9))

mask = plt.imread('demo6.jpg')#  读入背景图片,作为词云图的参数

mycloudword = WordCloud(width=800,height=600,scale=1,margin=2,

                        background_color='white',

                        min_font_size=5,# 最小文字大小

                        max_font_size=70,

                        max_words=200,

                        mask=mask,

                        random_state=100,# 随机颜色方案,

                        font_path='C:\windows\Fonts\STZHONGS.TTF'# 显示中文字体

                       ).generate(text)# 传入一个字符串

ax.imshow(mycloudword)

ax.axis('off')

mycloudword.to_file('skil.jpg')

注:STZHONGS.TTF华文中宋
(2) 分析数据分析师薪资和岗位地点、学历、工作年限的关系?
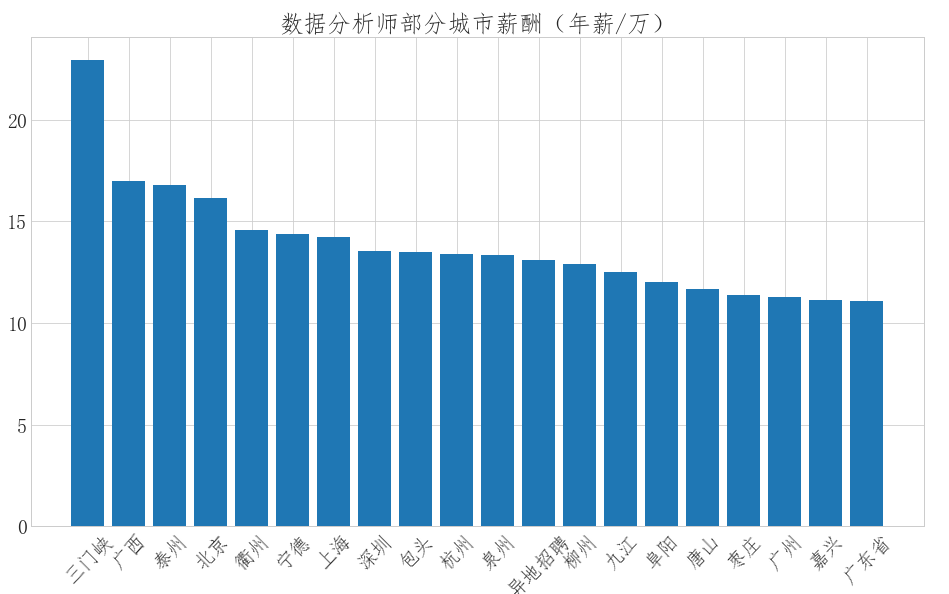
薪资与地点关系
"""统计不同城市的平均薪资"""

data['city']=data['location'].str.extract('(\w+)-?').fillna('未知')

mean_salary = data.groupby('city')['salary'].mean().round(2)# 保留两位小数位数

mean_salary = mean_salary.sort_values(ascending=False).head(20)
fig = plt.figure(figsize=(16,9))

plt.bar(mean_salary.index,mean_salary.values)

plt.xticks(rotation=45)

plt.title('数据分析师部分城市薪酬(年薪/万)')
# 薪资和学历关系
data['education']=data['education'].fillna('无')

xl_salary = data.groupby('education')['salary'].mean().round(2)

xl_salary = xl_salary.sort_values()

fig = plt.figure(figsize=(12,5))

plt.bar(xl_salary.index,xl_salary.values)

plt.xlabel('学历')

plt.xticks(rotation=90)

plt.title('数据分析师部学历和薪资(年薪/万)的关系')

# 薪资和工作年限关系
data['workyear'].value_counts()

data['year']=data['workyear'].map({'无工作经验':0,

'3-4年经验':3.5,

'2年经验':2,

'1年经验':1,

'5-7年经验':6,

'无':0,

'8-9年经验':8.5,

'10年以上经验':10})

year_salary = data.groupby('year')['salary'].mean().round(2)

fig = plt.figure(figsize=(12,5))

plt.plot(year_salary.index,year_salary.values)

plt.plot(year_salary.index,year_salary.values,'ro')

plt.xlabel('工作年限')

plt.xticks(rotation=90)

plt.title('数据分析师部工作经验和薪资(年薪/万)的关系')

# 数据分析师的学历需求
xl_cnt = data.groupby('education')['education'].count()

xl_cnt = xl_cnt.sort_values()

fig = plt.figure(figsize=(12,5))

plt.bar(xl_cnt.index,xl_cnt.values)

plt.xlabel('学历')

plt.xticks(rotation=90)

plt.title('数据分析师部学历需求')

# 数据分析师人才需求量的地理分布
from pyecharts.charts import Map

from pyecharts import options as opts
# # maptype='china' 只显示全国直辖市和省级

# 数据只能是省名和直辖市的名称

# 为了得到城市的省份数据
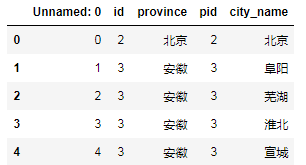
读取本地省份和城市对应的csv文件
# 读取csv文件

city_data=pd.read_csv('province.csv')

city_data.head()
查看文件
city_data.tail()
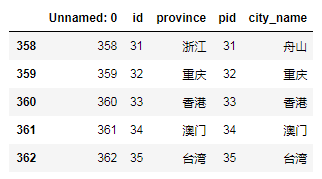
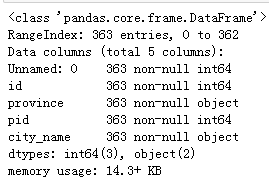
city_data.info()
data.loc[data['location']=='西藏']

# 发现原数据只有一个西藏的

city_data.loc[city_data['city_name']=='西藏']

# city_data中city_name字段中没有西藏

# 因为provice_data以 data的city字段和city_data的city_name字段进行连接
city_data.loc[364]=[364,28,'西藏',28,'西藏']

province_data = pd.merge(data,city_data,how='inner',left_on='city',right_on='city_name')

d = province_data['province'].value_counts()

map_obj = Map()

# tolist 功能转化为列表

value = d.values.tolist()

attr = d.index.tolist()

mdata=[list(z) for z in zip(attr,value)]

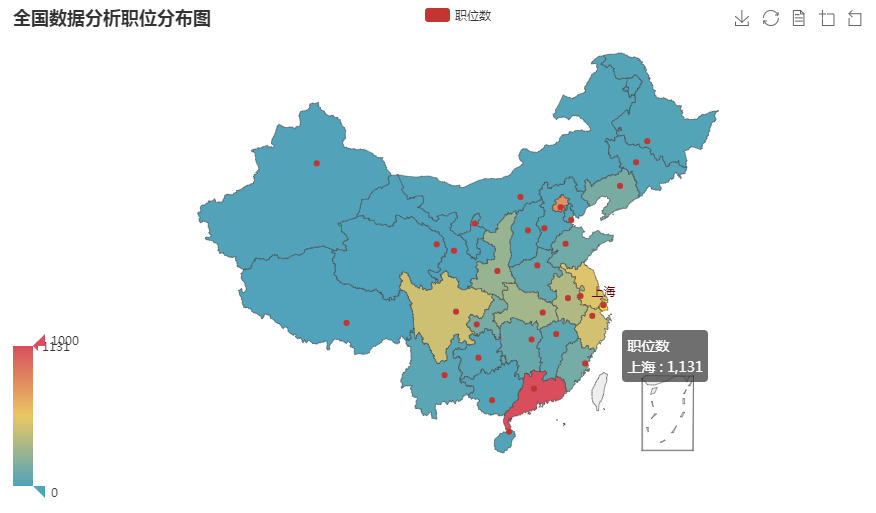
map_obj.add('职位数',mdata,'china')

map_obj.set_global_opts(title_opts=opts.TitleOpts(title='全国数据分析职位分布图'),

                        visualmap_opts=opts.VisualMapOpts(max_=1000),

                       toolbox_opts=opts.ToolboxOpts())

map_obj.set_series_opts(label_opts=opts.LabelOpts(is_show=False))

map_obj.render('test.html')# 把图保存到本地

map_obj.render_notebook()# 在notebook 中进行展示
七、总结和建议
总结:

(1)数据分析师的主要计能前3是excel、sql,python

(2)数据分析师城市薪资排行前3的是三门峡,广西,和台洲,和常识中的北上广深有出入

(3)数据分析师学历和年薪的关系中,按薪资降序排列,第一名是博士学历,第二是硕士,第三是本科,其中本科和硕士的年薪差别不大

(4)数据分析是工作年限和薪资的关系,从图中看出数据分析师的薪资和薪资成正比关系

(5)数据分析师的学历需求,需求最大的是本科,其次是大专,博士、硕士需求量少

(6)数据分析师人才需求量的地理分布可以看出,数据分析师的人才需求主要集中在北上广地区

建议:

对于求职者:

技能方面主要掌握excel、sql、python就可以满足一般企业需求

学历方面:至少是本科

求职地区:北上广深
职位画像分析(pandas/ matplotlib)的更多相关文章
- python 数据分析工具之 numpy pandas matplotlib
作为一个网络技术人员,机器学习是一种很有必要学习的技术,在这个数据爆炸的时代更是如此. python做数据分析,最常用以下几个库 numpy pandas matplotlib 一.Numpy库 为了 ...
- Python模块简介及安装 [numpy,pandas,matplotlib,scipy,statsmodels,Gensim,sklearn,keras]
https://pan.baidu.com/s/1bpVv3Ef 67bd 模块安装文件下载地址 pip install "numpy-1.12.0b+mkl-cp35- ...
- 第一章:AI人工智能 の 数据预处理编程实战 Numpy, Pandas, Matplotlib, Scikit-Learn
本课主题 数据中 Independent 变量和 Dependent 变量 Python 数据预处理的三大神器:Numpy.Pandas.Matplotlib Scikit-Learn 的机器学习实战 ...
- 常用统计分析python包开源学习代码 numpy pandas matplotlib
常用统计分析python包开源学习代码 numpy pandas matplotlib 待办 https://github.com/zmzhouXJTU/Python-Data-Analysis
- numpy+pandas+matplotlib+tushare股票分析
一.数据导入 安装tushare模块包 pip install tushare http://tushare.org/ tushare是一个财经数据接口包 import numpy as np imp ...
- 【python】pandas & matplotlib 数据处理 绘制曲面图
Python matplotlib模块,是扩展的MATLAB的一个绘图工具库,它可以绘制各种图形 建议安装 Anaconda后使用 ,集成了很多第三库,基本满足大家的需求,下载地址,对应选择pytho ...
- numpy, pandas, matplotlib等常用库的学习手册
pandas介绍: 待续 参考资料: 中文:https://www.cnblogs.com/skying555/p/5914391.html 英文:http://www.datadependence. ...
- numpy pandas matplotlib
import numpy as np import pandas as pd import matplotlib.pyplot as plt ---------------numpy--------- ...
- kaggle之数据分析从业者用户画像分析
数据为kaggle社区发布的数据分析从业者问卷调查分析报告,其中涵盖了关于该行业不同维度的问题及调查结果.本文的目的为提取有用的数据,进行描述性展示.帮助新从业的人员更全方位地了解这个行业. 参考学习 ...
随机推荐
- JavaWeb入门——在Linux环境下安装Tomcat服务器
JavaWeb入门——在Linux环境下安装Tomcat服务器 摘要:本文主要学习了如何在Linux环境下安装Tomcat服务器. 准备工作 检查Java环境变量 检查系统是否配置了Java的环境变量 ...
- Hive DDL、DML操作
• 一.DDL操作(数据定义语言)包括:Create.Alter.Show.Drop等. • create database- 创建新数据库 • alter database - 修改数据库 • dr ...
- Dynamics CRM 2013开始推出的服务器端同步来配置邮件服务
我是微软Dynamics 365 & Power Platform方面的工程师罗勇,也是2015年7月到2018年6月连续三年Dynamics CRM/Business Solutions方面 ...
- 跨平台版本迁移之 XTTS 方案操作指南
本文转自 https://blog.csdn.net/Enmotech/article/details/80045576 作者 | 罗贵林: 云和恩墨技术工程师,具有8年以上的 Oracle 数据库工 ...
- VSCode+C++环境搭建
date: 2019-10-05 VSCode+C++环境搭建 其实并不完整,毕竟我也只是一个OIer,并不会很高深的东西.(众所周知,OIer主业是软件开发) 安装VSCode 下载安装包 这个很简 ...
- 32(1).层次聚类---AGNES
层次聚类hierarchical clustering 试图在不同层次上对数据集进行划分,从而形成树形的聚类结构. 一. AGNES AGglomerative NESting:AGNES是一种常用的 ...
- go 语言学习图解
- kubernetes haproxy+keepalive实现master集群高可用
前言 master的HA,实际是apiserver的HA.Master的其他组件controller-manager.scheduler都是可以通过etcd做选举(--leader-elect),而A ...
- 程序员修神之路--redis做分布式锁可能不那么简单
菜菜哥,复联四上映了,要不要一起去看看? 又想骗我电影票,对不对? 呵呵,想去看了叫我呀 看来你工作不饱和呀 哪有,这两天我刚基于redis写了一个分布式锁,很简单 不管你基于什么做分布式锁,你觉得很 ...
- SpringCloud的入门学习之概念理解、Feign负载均衡入门
1.Feign是SpringCloud的一个负载均衡组件. Feign是一个声明式WebService客户端.使用Feign能让编写Web Service客户端更加简单, 它的使用方法是定义一个接口, ...