
Python抓取豆瓣电影top250!
前言
本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
作者:404notfound 
一直对爬虫感兴趣,学了python后正好看到某篇关于爬取的文章,就心血来潮实战一把吧。当然如果你学的不好,建议可以先去小编的Python交流.裙 :一久武其而而流一思(数字的谐音)转换下可以找到了,里面有最新Python教程项目,一起交流学习进步!
实现目标:抓取豆瓣电影top250,并输出到文件中
1.找到对应的url:https://movie.douban.com/top250
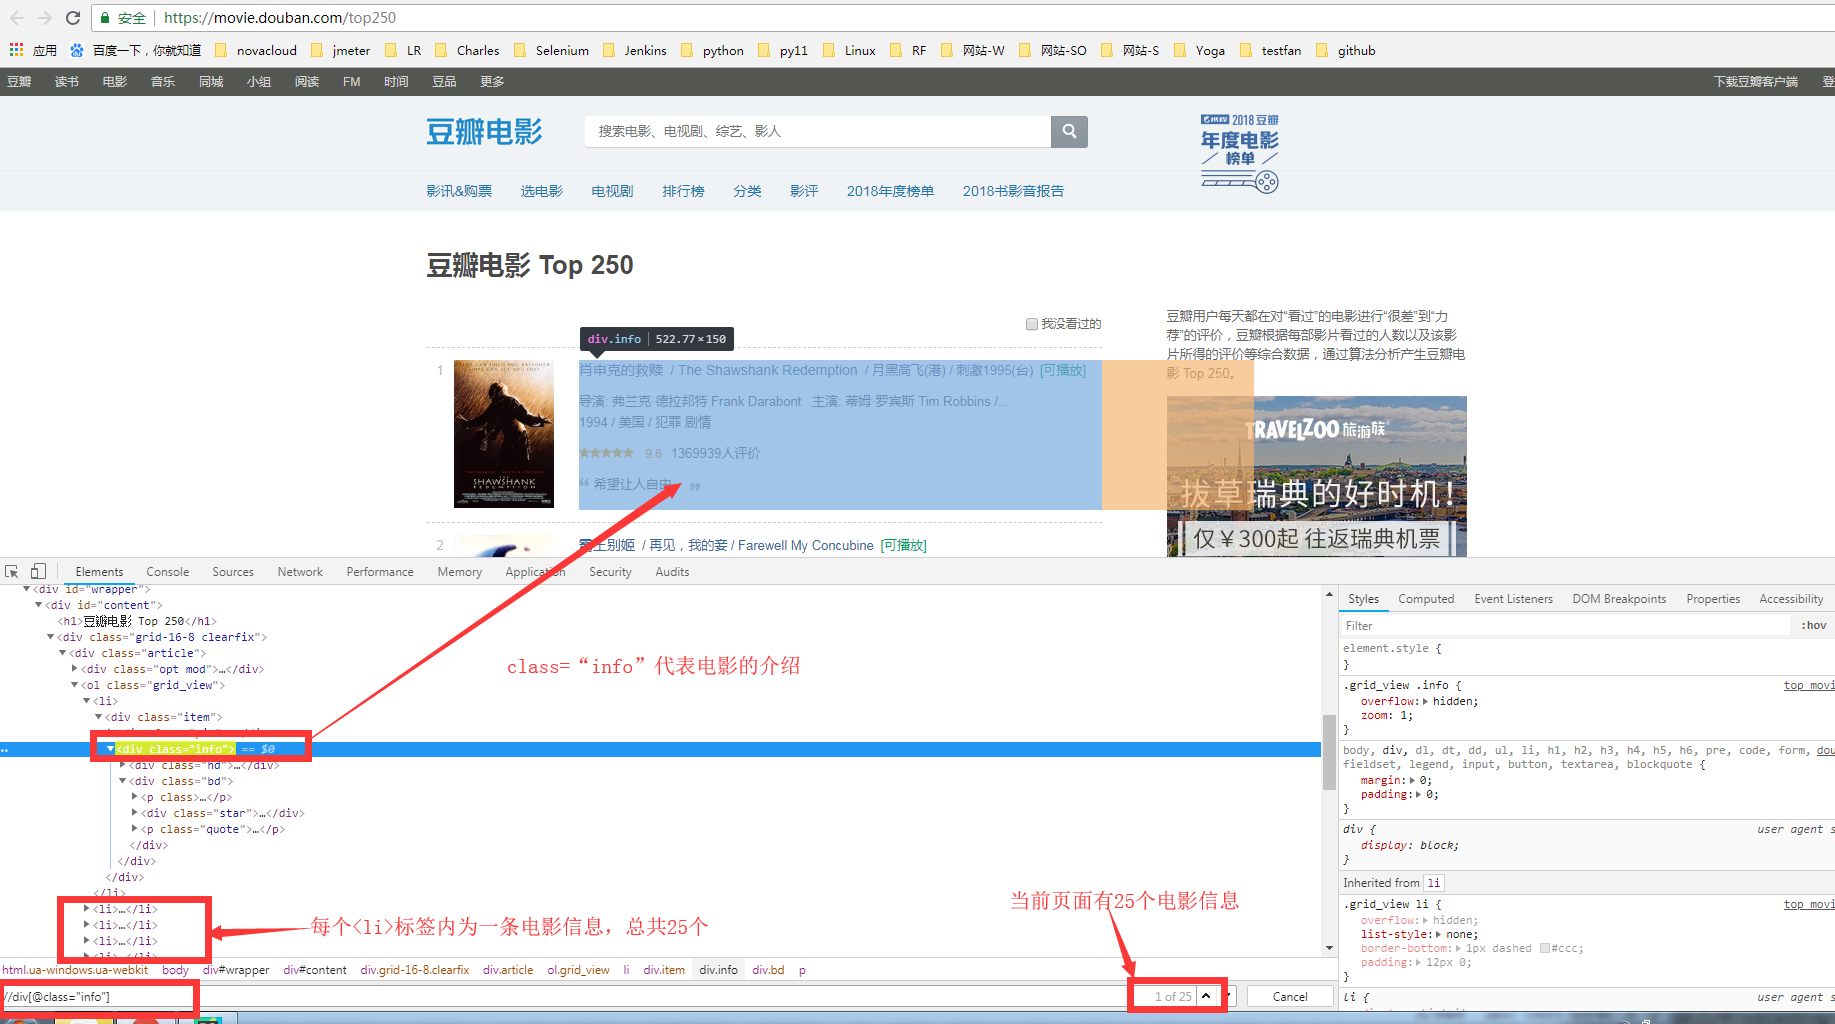
2.进行页面元素的抓取:
3.编写代码:
第一步:实现抓取第一个页面;
第二步:将其他页面的信息也抓取到;
第三步:输出到文件;
4.代码:
import sys
import io
from selenium import webdriver

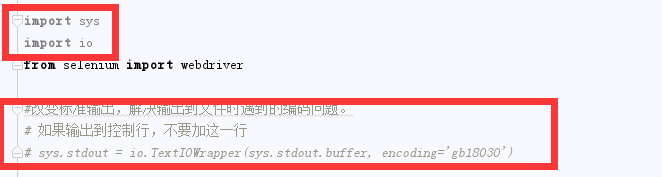
#改变标准输出,解决输出到文件时遇到的编码问题。
# 如果输出到控制行,不要加这一行
# sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='gb18030')

class DouBan:
    #初始化driver对象,打开页面,最大化页面
    def __init__(self):
        self.driver=webdriver.Chrome()
        self.driver.get('https://movie.douban.com/top250')
        self.driver.maximize_window()

    # 分页判断,默认显示第一页,输出第一页后,点击下一页按钮,再输出。总共10页
    def get_content(self):
        for page in range(1,10):
            #获取元素定位: 对当前页面中 单个电影元素进行定位
            movie = self.driver.find_elements_by_class_name('info')

           # for循环:循环输出当前页面中单部影片的电影信息(text输出元素的文本内容);
            i = 1
            for item in movie:
                #输出格式: 电影序号 +  电影介绍  +换行展示
                print(str(i+ page*25-25)+": "+item.text+'')
                print("")
                i+=1

            # 判断:如果当前页面码小于10,则查找页码的元素,并点击页码。否则不用进行查找,因为最多点击第10页;
            # 获取底部的页签元素(采用了format格式输出,根据当前页面做加1操作)
            if page<10:
                page_but = self.driver.find_element_by_xpath('//div[@class="paginator"]//a[contains(text(),{0})]'.format(page + 1))
                page_but.click()
            else:
                pass

if __name__ == '__main__':
    DouBan().get_content()
5.结果:
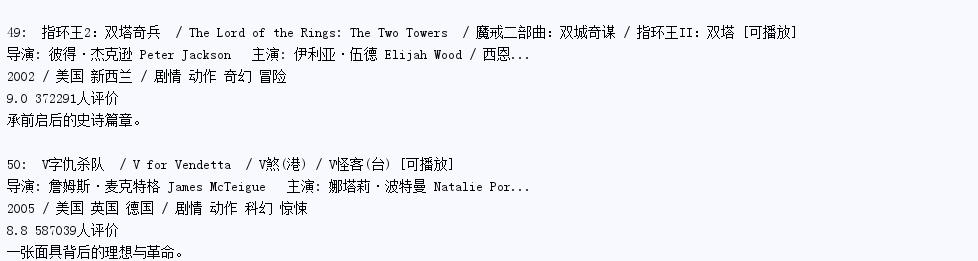
1)控制台输出部分截图:
2)如果想要输出到文件,执行命令并重定向到TXT文件中:
python xxxx.py >d:/out_test.txt
6.遇到的问题:
1.多页时,for循环的数字设置,来回试几次就可以了,不难。
2.输出到文件中
真的很简单,不知道你们都懂了没? 如果没懂可以去小编的Python交流.裙 :一久武其而而流一思(数字的谐音)转换下可以找到了,里面有最新Python教程项目,一起交流学习进步!有问题留言问我吧~
Python抓取豆瓣电影top250!的更多相关文章
- Python:python抓取豆瓣电影top250
一直对爬虫感兴趣,学了python后正好看到某篇关于爬取的文章,就心血来潮实战一把吧. 实现目标:抓取豆瓣电影top250,并输出到文件中 1.找到对应的url:https://movie.douba ...
- Python小爬虫——抓取豆瓣电影Top250数据
python抓取豆瓣电影Top250数据 1.豆瓣地址:https://movie.douban.com/top250?start=25&filter= 2.主要流程是抓取该网址下的Top25 ...
- Python爬虫----抓取豆瓣电影Top250
有了上次利用python爬虫抓取糗事百科的经验,这次自己动手写了个爬虫抓取豆瓣电影Top250的简要信息. 1.观察url 首先观察一下网址的结构 http://movie.douban.com/to ...
- python2.7抓取豆瓣电影top250
利用python2.7抓取豆瓣电影top250 1.任务说明 抓取top100电影名称 依次打印输出 2.网页解析 要进行网络爬虫,利用工具(如浏览器)查看网页HTML文件的相关内容是很有必要,我使用 ...
- Python3 抓取豆瓣电影Top250
利用 requests 抓取豆瓣电影 Top 250: import re import requests def main(url): global num headers = {"Use ...
- python爬取豆瓣电影Top250(附完整源代码)
初学爬虫,学习一下三方库的使用以及简单静态网页的分析.就跟着视频写了一个爬取豆瓣Top250排行榜的爬虫. 网页分析 我个人感觉写爬虫最重要的就是分析网页,找到网页的规律,找到自己需要内容所在的地方, ...
- 零基础爬虫----python爬取豆瓣电影top250的信息(转)
今天利用xpath写了一个小爬虫,比较适合一些爬虫新手来学习.话不多说,开始今天的正题,我会利用一个案例来介绍下xpath如何对网页进行解析的,以及如何对信息进行提取的. python环境:pytho ...
- Python 爬取豆瓣电影Top250排行榜,爬虫初试
from bs4 import BeautifulSoup import openpyxl import re import urllib.request import urllib.error # ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
随机推荐
- avtivmq(订阅写法)
发布-订阅消息模式与点对点模式类似,只不过在session创建消息队列时,由session.createQuene()变为session.createTopic(). 消息发布者代码: 消息订阅者代码 ...
- PowerMock学习(三)之Mock局部变量
编写powermock用例步骤: 类上面先写这两个注解@RunWith(PowerMockRunner.class).@PrepareForTest(StudentService.class) 先模拟 ...
- Appium+python自动化(四十二)-Appium自动化测试框架综合实践- 寿终正寝完结篇(超详解)
1.简介 按照上一篇的计划,今天给小伙伴们分享执行测试用例,生成测试报告,以及自动化平台.今天这篇分享讲解完.Appium自动化测试框架就要告一段落了. 2.执行测试用例&报告生成 测试报告, ...
- poj 1001 求高精度幂(Java, BigDecimal, pow, hasNext, stripTrailingZeros, toPlainString)
求高精度幂 Time Limit: 500MS Memory Limit: 10000K Total Submissions: 180325 Accepted: 43460 Descripti ...
- npm报错:无法加载文件 D:\nodejs\node_global\webpack.ps1,因为在此系统上禁止运行脚本
npm报错 在 windows终端输入 vue init webpack app, 创建一个名为 app 的 Vue 项目时报错如下: 无法加载文件 D:\nodejs\node_global\web ...
- django_1:配置文件
工程下: settings.py(建议设置成如下) DATABASES #数据库配置 DEBUG = True ...
- python:爬虫2——隐藏自己
一.添加浏览器 方法一: head['User-Agent'] = 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, li ...
- tornado install
pip install tornado Linux 安装时注意库的安装路径和执行时寻找路径是否一样 Windows 安装时注意user是否有权限 解决办法:
- Jenkins 实现前端自动打包,自动部署代码及邮件提醒功能
在之前的公司,我们前端使用webpack构建项目,项目构建完成后,我们会使用ftp或linux的一些命令工具上传我们的文件到服务器上,这种方式虽然是可以,但是最近面试的时候,人家会问我前端如何部署项目 ...
- Hadoop之HDFS文件系统
概念 HDFS,它是一个文件系统,用于存储文件,通过目录树来定位文件:其次,它是分布式的,由很多服务器联合起来实现其功能,集群中的服务器有各自的角色. HDFS的设计适合一次写入,多次读出的场景,且不 ...