
第六篇 xpath的用法
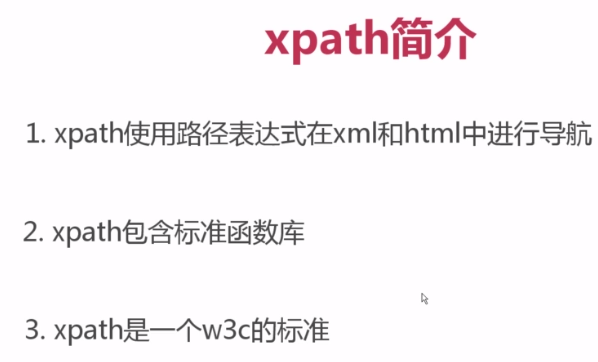
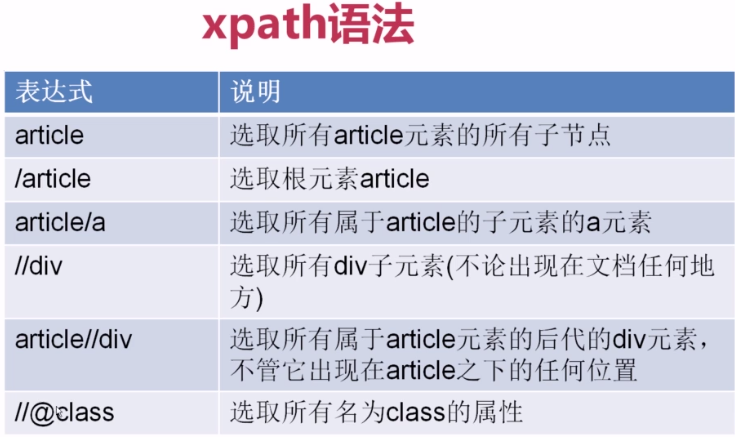
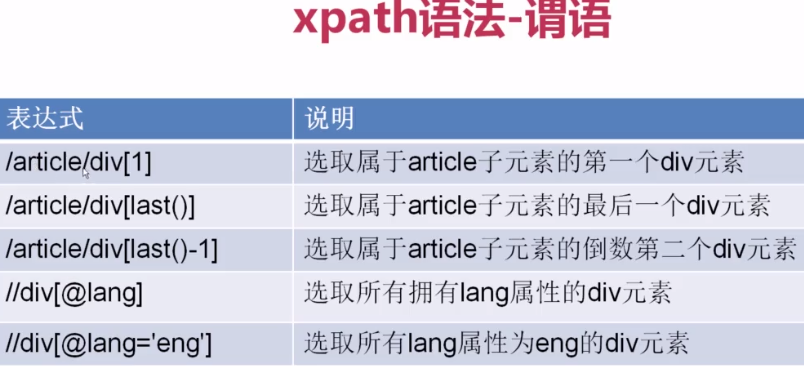
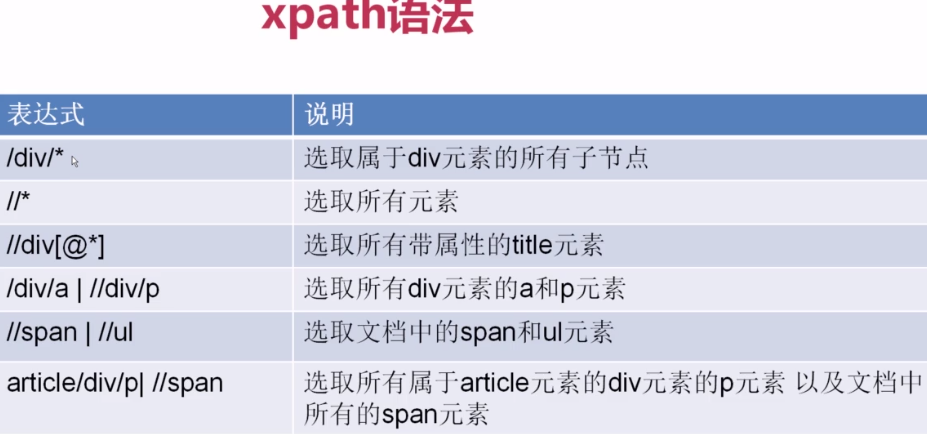
使用pycharm debug调试效率会比较慢,因为每次调试都需要向url发送请求,等返回信息,scrapy提供一种方便调试的功能,如下:
>>>(third_project) bigni@bigni:pachong$ scrapy shell http://blog.jobbole.com/112239/

>>> title = response.xpath('//*[@id="post-112239"]/div[1]/h1')

>>> title

[<Selector xpath='//*[@id="post-112239"]/div[1]/h1' data='<h1>谷歌用两年时间研究了 180 个团队,发现高效团队有这五个特征</h1>'>]

>>> title.extract()

['<h1>谷歌用两年时间研究了 180 个团队,发现高效团队有这五个特征</h1>']

>>> title = response.xpath('//*[@id="post-112239"]/div[1]/h1/text()')

>>> title

[<Selector xpath='//*[@id="post-112239"]/div[1]/h1/text()' data='谷歌用两年时间研究了 180 个团队,发现高效团队有这五个特征'>]
extract()方法可以取到select list里的date,text()方法可以取到内容。
In []: title2 = response.xpath("//*[@id='post-112239']/div[1]/h1").extract()

In []: title2

Out[]: ['<h1>谷歌用两年时间研究了 180 个团队,发现高效团队有这五个特征</h1>']

In []: title2 = response.xpath("//*[@id='post-112239']/div[1]/h1")

In []: title2

Out[]: [<Selector xpath="//*[@id='post-112239']/div[1]/h1" data='<h1>谷歌用两年时间研究了 180 个团队,发现高效团队有这五个特征</h1>'>]

In []: title2 = response.xpath("//*[@id='post-112239']/div[1]/h1/text()").extr

    ...: act()

In []: title2

Out[]: ['谷歌用两年时间研究了 180 个团队,发现高效团队有这五个特征']

In []:
PS:在chrome里,按F12看到的代码是加载完所有插件后的,比如JS,如果通过通过根路径来定位要找的内容是容易出错的,因为xpath搜索的不会把js等生成的元素计算在内,这个可以通过鼠标右键查看源码来判断哪些是js生成的,然后过滤掉。
对于属性里有多个值的情况,比如class 里有多个值:

可以使用scrapy内置的contains方法:
In []: ret = response.xpath("//div[contains(@class,'post-112239')]")

In []: ret

Out[]: [<Selector xpath="//div[contains(@class,'post-112239')]" data='<div class="post-112239 post type-post s'>]
如果要爬取下面这个内容,可以这么操作:
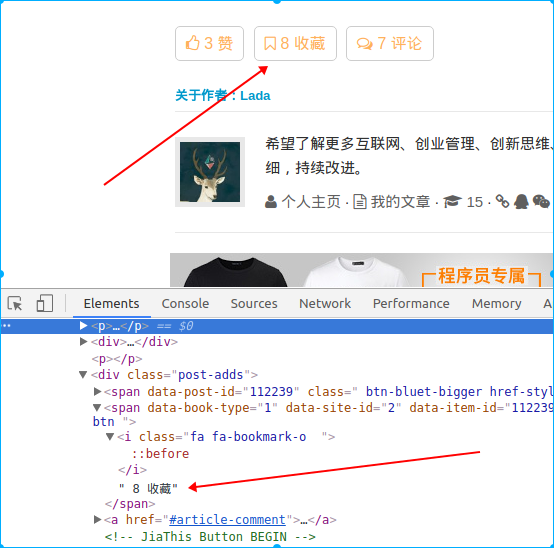
In []: rest = response.xpath('//*[@id="post-112239"]/div[3]/div[4]/span[2]/tex

    ...: t()').extract()[0]

In []: rest

Out[]: ' 8 收藏'
接着再用正则去掉别的信息,由于在scrapy shell中直接调用re模块会报错,那可以用ipython调试
In []: ret = re.match(r".*(\d+).*",' 8 收藏')

In []: ret.group()

Out[]: ''
第六篇 xpath的用法的更多相关文章
- [老老实实学WCF] 第六篇 元数据交换
老老实实学WCF 第六篇 元数据交换 通过前两篇的学习,我们了解了WCF通信的一些基本原理,我们知道,WCF服务端和客户端通过共享元数据(包括服务协定.服务器终结点信息)在两个 终结点上建立通道从而进 ...
- Python爬虫利器六之PyQuery的用法
前言 你是否觉得 XPath 的用法多少有点晦涩难记呢? 你是否觉得 BeautifulSoup 的语法多少有些悭吝难懂呢? 你是否甚至还在苦苦研究正则表达式却因为少些了一个点而抓狂呢? 你是否已经有 ...
- (数据科学学习手札61)xpath进阶用法
一.简介 xpath作为对网页.对xml文件进行定位的工具,速度快,语法简洁明了,在网络爬虫解析内容的过程中起到很大的作用,除了xpath的基础用法之外(可参考我之前写的(数据科学学习手札50)基于P ...
- 解剖SQLSERVER 第十六篇 OrcaMDF RawDatabase --MDF文件的瑞士军刀(译)
解剖SQLSERVER 第十六篇 OrcaMDF RawDatabase --MDF文件的瑞士军刀(译) http://improve.dk/orcamdf-rawdatabase-a-swiss-a ...
- 解剖SQLSERVER 第六篇 对OrcaMDF的系统测试里避免regressions(译)
解剖SQLSERVER 第六篇 对OrcaMDF的系统测试里避免regressions (译) http://improve.dk/avoiding-regressions-in-orcamdf-b ...
- Python之路【第十六篇】:Django【基础篇】
Python之路[第十六篇]:Django[基础篇] Python的WEB框架有Django.Tornado.Flask 等多种,Django相较与其他WEB框架其优势为:大而全,框架本身集成了O ...
- 第六篇 :微信公众平台开发实战Java版之如何自定义微信公众号菜单
我们来了解一下 自定义菜单创建接口: http请求方式:POST(请使用https协议) https://api.weixin.qq.com/cgi-bin/menu/create?access_to ...
- RabbitMQ学习总结 第六篇:Topic类型的exchange
目录 RabbitMQ学习总结 第一篇:理论篇 RabbitMQ学习总结 第二篇:快速入门HelloWorld RabbitMQ学习总结 第三篇:工作队列Work Queue RabbitMQ学习总结 ...
- 第六篇 Replication:合并复制-发布
本篇文章是SQL Server Replication系列的第六篇,详细内容请参考原文. 合并复制,类似于事务复制,包括一个发布服务器,一个分发服务器和一个或多个订阅服务器.每一个发布服务器上可以定义 ...
随机推荐
- 力扣算法——140WordBreakII【H】
Given a non-empty string s and a dictionary wordDict containing a list of non-empty words, add space ...
- 8.Jmeter 快速入门教程 -- 如何使测试脚本更强大
添加基本的elements例如Sampler 或者一些监听器,就可以完成基本的测试.但有时需要更复杂的测试场景,所以还有更多其他的元素.清看下表,了解各种单元组的用途. 可添加的单元组 用途 Sa ...
- shell编程:利用脚本实现nginx的守护自动重启
nginx_daemon.sh #!/bin/bash # this_pid=$$ while true do ps -ef | grep nginx | grep -v grep | grep -v ...
- MVC5+EF6 完整教程
随笔分类 - MVC ASP.NET MVC MVC5+EF6 完整教程17--升级到EFCore2.0 摘要: EF Core 2.0上周已经发布了,我们也升级到core 文章内容基于vs2017, ...
- Python之字符串搜索和替换
简单直接使用 str.replace() text="zzy is a beautiful boy" print(text.replace("boy",&quo ...
- Nginx反向代理与负载均衡应用实践(一)
Nginx反向代理与负载均衡应用实践(一) 链接:https://pan.baidu.com/s/1xB20bnuanh0Avs4kwRpSXQ 提取码:migq 复制这段内容后打开百度网盘手机App ...
- openstack一些介绍
最近刚考完redhat 的 openstack,就想来这里简单介绍一下. openstack涉及到overcloud和undercloud两个层面的操作,undercloud需要一些技术操作,然后来创 ...
- java是否是“美丽的”语言
java 学习 (jdk扫描 配置读取 服务器选项 )
- CentOS7.6 部署asp.net core2.2 应用
1.安装.net Core SDK 在安装.NET之前,您需要注册Microsoft密钥,注册产品存储库并安装所需的依赖项.这只需要每台机器完成一次. 打开终端并运行以下命令: sudo rpm -U ...
- leetcode-163周赛-1262-可被3整除的最大和
题目描述: 方法一:动态规划 O(N) class Solution: def maxSumDivThree(self, nums: List[int]) -> int: dp = [0, -1 ...