
Python3.6爬虫+Djiago2.0+Mysql --数据爬取
1.下载对应版本的python mysql 模块 我的是:pymssql-2.2.0.dev0-cp36-cp36m-win_amd64.whl
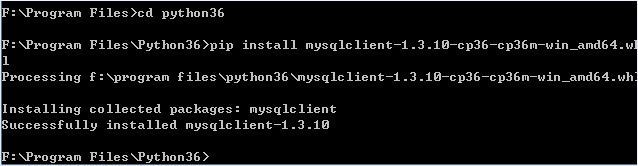
2.手动创建table
create table grilsbase

(

id int primary key auto_increment,

name varchar(50),height varchar(50),bwh varchar(50),title varchar(100),img_upload varchar(100),pc_img_upload varchar(100),

resource_id varchar(50),totals varchar(50),recommend_id varchar(50),date varchar(50),headimg_upload varchar(50),

show_datetime varchar(50),client_show_datetime varchar(50),video_duration varchar(50),free_select varchar(50),

trial_time varchar(50),viewtimes varchar(50),coop_customselect_654 varchar(50),coop_id varchar(50),tag_class varchar(50),

tag_name varchar(50),playerid varchar(50),block_detailid varchar(50),type varchar(50),istop varchar(50)

)
3.实现爬虫代码
导入模块:requests ,os,json,re,Mysqldb
流程:获取数据=>分析数据=>解析数据=>持久化保存
 #coding:utf-8

 import  requests

 import os

 import json

 import re

 import MySQLdb

 import threading

 #获取数据url

 gilsUrl='http://act.vip.xunlei.com/ugirls/js/ugirlsdata.js'

 gilsDetailUrl='http://meitu.xunlei.com/detail.html'

 gilsImgUrl='http://data.meitu.xunlei.com/data/image/%s/%s'

 executor = threading.BoundedSemaphore(10)

 regex=re.compile('\/([^\/]*?\.jpg)$')

 regexhead=re.compile('\/([^\/]*?)\.jpg$')

 class MySQL:

     def __init__(self,host,user,pwd,db):

         self.host=host

         self.user=user

         self.db=db

         self.pwd=pwd

     def GetConnect(self):

         if not self.db:

             raise(NameError,'没有目标数据库')

         self.connect=MySQLdb.connect(host=self.host,user=self.user,password=self.pwd,database=self.db,port=3306,charset='utf8')

         cur=self.connect.cursor()

         if not cur:

             raise(NameError,'数据库访问失败')

         else:

             return cur

     def ExecSql(self,sql):

          cur=self.GetConnect()

          cur.execute(sql)

          self.connect.commit()

          self.connect.close()

     def ExecQuery(self,sql):

         cur=self.GetConnect()

         cur.execute(sql)

         resList = cur.fetchall()

         self.connect.close()

         return resList

 def getGirlsData():

     regex=re.compile("var ugirlsData=(.+)")

     r=requests.get(gilsUrl)

     jsond=regex.findall(r.text)

     with open('ugirlsdata.json','w+',encoding='utf-8') as f:

          f.write(jsond[0])

     #print('写入json成功')

     return json.loads(jsond[0])

 def getImgName(imgurl):

     if(imgurl==''):

         return ''

     m=regex.findall(imgurl)

     if m is None:

         return ''

     else:

         return  m[0] if len(m)>0 else ''

 def getImgNameHead(imgurl):

     if(imgurl==''):

         return ''

     m=regexhead.findall(imgurl)

     if m is None:

         return ''

     else:

         return  m[0] if len(m)>0 else ''

 def WriteDB(jsdata):

     ms = MySQL(host="192.168.0.108", user="lin", pwd="", db="grils")

     for data in jsdata:

         sql="insert into grilsbase(\

         name,height,bwh,title,img_upload,pc_img_upload,resource_id,totals,recommend_id,\

         date,headimg_upload,show_datetime,client_show_datetime,video_duration,free_select,trial_time,\

         viewtimes,coop_customselect_654,coop_id,tag_class,tag_name,playerid,block_detailid,type,istop)\

         values('%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s','%s')" % \

         (data['name'],data['height'],data['bwh'],data['title'],getImgName(data.get('img_upload','')),data['pc_img_upload'],data['resource_id'],data["totals"],data["recommend_id"], \

         data['date'],getImgName(data.get("headimg_upload",'')),data["show_datetime"],data["client_show_datetime"],data["video_duration"],data["free_select"],data["trial_time"], \

         data['viewtimes'],data['coop_customselect_654'],data['coop_id'],data.get('tag_class',''),data.get('tag_name',''),data.get('playerid',''),data['block_detailid'],data['type'],data['istop'])

         #print(sql)

         ms.ExecSql(sql)

         print('完成'+data['name']+'数据更新...')

         DownImg(data['name'],data["totals"],data['resource_id'],data["headimg_upload"],data["img_upload"])

 def DownImg(name,totals,resource_id,headimg_upload,img_upload):

     path=creatFile(resource_id)

     if headimg_upload.strip()!='':

         #os.remove('./pic/'+resource_id+'/'+getImgName(headimg_upload)+'.jpg')

         DownImgRun(headimg_upload,path,getImgNameHead(headimg_upload))

     if img_upload.strip()!='':

         #os.remove('./pic/'+resource_id+'/'+getImgName(img_upload)+'.jpg')

         DownImgRun(img_upload,path,getImgNameHead(img_upload))

     #print('正在下载'+name+'图片')

     for i in range(1,int(totals)+1):

         url=gilsImgUrl%(resource_id,str(i)+'.jpg')

         DownImgRun(url,path,i)

         #t=threading.Thread(target=DownImgRun,args={url,path,i})

         #t.start()

         #t.join()

 def DownImgRun(url,path,i):

     #print(url)

     r=requests.get(url)

     if(r.status_code==200):

         with open(path+'/'+str(i)+'.jpg','wb') as fimg:

             fimg.write(r.content)

 def creatFile(dirname):

     path='./pic/'+dirname

     if os.path.exists(path):

         return path

     else:

         os.makedirs(path)

         return  path

 if __name__ == '__main__':

     gri=getGirlsData()

     WriteDB(gri)
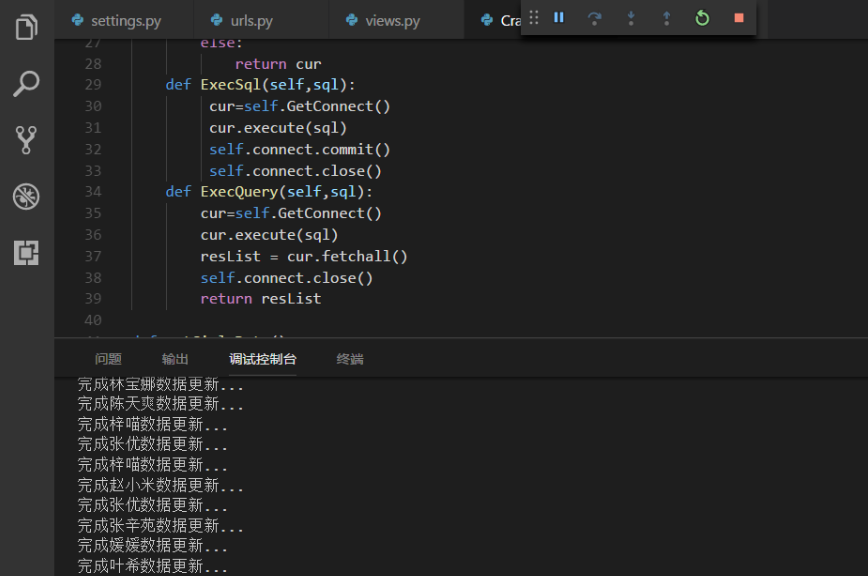
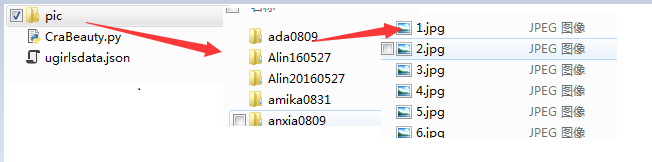
4.运行效果 和结果

Python3.6爬虫+Djiago2.0+Mysql --数据爬取的更多相关文章
- sulin Python3.6爬虫+Djiago2.0+Mysql --实例demo
1.切换到项目目录下,启动测试服务器 manage.py runserver 192.168.0.108:8888 2.设置相关配置 项目目录展示如下: beauty=>settings.py ...
- Python3.6爬虫+Djiago2.0+Mysql --运行djiago环境
1.安装djiago 模块 pip install Django --默认安装最新的 安装完成以后可以python -m pip list 查看模块是否安装 2.创建项目及app 及生成目录 备注 ...
- [Python3网络爬虫开发实战] 6-Ajax数据爬取
有时候我们在用requests抓取页面的时候,得到的结果可能和在浏览器中看到的不一样:在浏览器中可以看到正常显示的页面数据,但是使用requests得到的结果并没有.这是因为requests获取的都是 ...
- python爬虫-上期所持仓排名数据爬取
摘要:笔记记录爬取上期所持仓数据的过程,本次爬取使用的工具是python,使用的IDE是pycharm 一.查看网页属性,分析数据结构 在浏览器中打开上期所网页,按F12或者选择表格文字-右键-审查元 ...
- 前端反爬虫策略--font-face 猫眼数据爬取
1 .font-face定义了字符集,通过unicode去印射展示. 2 .font-face加载网络字体,我么可以自己创建一套字体,然后自定义一套字符映射关系表例如设置0xefab是映射字符1, ...
- python-day7爬虫基础之Ajax数据爬取
前几天一直在忙老师的项目,就没有继续学python,也没有写什么收获,今天晚上有空看看书,边看边理解着写吧: 首先说一下,我对Ajax的理解,就是有时候我们在浏览某个网页的时候,只要我们鼠标一直往下滑 ...
- python3编写网络爬虫13-Ajax数据爬取
一.Ajax数据爬取 1. 简介:Ajax 全称Asynchronous JavaScript and XML 异步的Javascript和XML. 它不是一门编程语言,而是利用JavaScript在 ...
- python3下scrapy爬虫(第八卷:循环爬取网页多页数据)
之前我们做的数据爬取都是单页的现在我们来讲讲多页的 一般方式有两种目标URL循环抓取 另一种在主页连接上找规律,现在我用的案例网址就是 通过点击下一页的方式获取多页资源 话不多说全在代码里(因为刚才写 ...
- Python爬虫入门教程 3-100 美空网数据爬取
美空网数据----简介 从今天开始,我们尝试用2篇博客的内容量,搞定一个网站叫做"美空网"网址为:http://www.moko.cc/, 这个网站我分析了一下,我们要爬取的图片在 ...
随机推荐
- jQuery 快捷操作
快捷操作 1. class属性值操作 $().attr(‘class’,值); $().attr(‘class’); $().removeAttr(‘class’); //删除class的所有属性 ...
- vs使用出现的一些常见错误(持续更新)
vs2010编译出错时怎么会执行上一次的结果_百度知道https://zhidao.baidu.com/question/193018332.html
- sql实现查询某个字段在哪个表里 及结构是什么
) --数据库名 ) set @dbname2='aab' select @str = ' SELECT 表名=d.name,字段名=a.name,序号=a.column_id, 标识=is_iden ...
- leetcode题解(持续更新)
leetcode题解 1.两数之和 给定一个整数数组 nums 和一个目标值 target,请你在该数组中找出和为目标值的那 两个 整数,并返回他们的数组下标. 你可以假设每种输入只会对应一个答案.但 ...
- <读书笔记>001-以解决问题为导向的python编程实践
以解决问题为导向的python编程实践 0.第0章:计算机科学 思考:计算机科学是否为计算机编程的简称? 编程的困难点:1.同时做2件事(编程语言的语法.语义+利用其解决问题) 2.什么是好程序(解 ...
- 9.ActiveMQ理论
一.首先说下什么是消息队列? 1.消息队列是在消息的传输过程中保存消息的容器. 二.为什么要用到消息队列? 主要原因是由于在高并发环境下,由于来不及同步处理,请求往往会发生堵塞,比如说,大量的inse ...
- codis 使用
1:Jedis与Redisson对比 2.1. 概况对比 Jedis是Redis的Java实现的客户端,其API提供了比较全面的Redis命令的支持:Redisson实现了分布式和可扩展的Java数据 ...
- ES6 学习 -- 字符串新增方法
1.检测字符串中是否包含某个字符 ES5方法:string.indexOf("需要检测的字符"),如果返回值为-1,则说明当前字符串中不存在这个字符,返回值不为-1,则 是当前字符 ...
- iOS进阶五-RunLoop
简介 RunLoop 运行循环.跑圈 RunLoop的作用主要体现在三方面: 1.保持程序持续运行 2.处理App中的各种事件(比如触摸事件.定时器事件.Selector事件) 3.节省CPU资源,提 ...
- nginx 知识
nginx如何实现高并发? 启动nginx服务器后,输入 ps -ef |grep nginx,会发现nginx有一个master进程 和若干个worker进程, 这些worker进程是平等的,都是被 ...