
前端反爬虫策略--font-face 猫眼数据爬取
2 .font-face加载网络字体,我么可以自己创建一套字体,然后自定义一套字符映射关系表例如设置0xefab是映射字符1,0xeba2是映射字符2,以此类推。当需要显示字符1时,网页的源码只会是0xefab,被采集的也只会是 0xefab,并不是1
3 .但是对于正常的用户来说则没有影响,因为浏览器会加载css的font字体为我们渲染好,实时显示在网页中。
4 .所以我们需要做的是,如何在判断请求web字体的是机器人或者是真人,也就是说,拦截被收敛到了这一个地方
5 .定期更新一批字体文件和映射表来加大难度
6 .他这个破解也很简单,需要一下人工,读出那个请求html文件对应数字的unicode,自己把那个表更新一下,转换那个部分可以做成自动的,还是可以用的。自己手动看一下1-9对应的unicode
实战:猫眼
猫眼电影
首先来看一个页面
https://maoyan.com/films/1212492
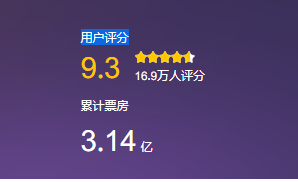
来分析一下页面,先来网页源代码看看

可以找的到数据 但是数据是原始编码。
这时候可能想那是不是 对应的就是9,而对应的就是3呢?
好我们来刷新验证一下
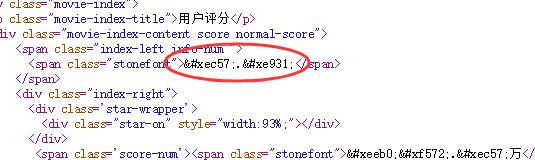
有不一样了这是怎么回事呢,我们来看

发现这个url是随机的,每次访问的值都不一样。
emm那如果我们想要拿所有的数据就不适合把编码写死了,我们把字体文件下载下来看看里面究竟是怎么回事。它是一个woff的字体文件,我们可以使用python的一个第三方库fonttools来帮助我们查看字体的信息。
fontTools
安装很简单,我的python版本是python3。
pip3 install fonttools
使用起来也很简单,有一些以前的技术博客写的这里的fonttools解析下来的结果是有序的,可能是猫眼升级了反爬措施,但是我解析下来的编码是乱序的,所以只能自己去分析woff文件。
ttf = TTFont('./fonts/' + link)
self.font.saveXML('trans.xml')   # 将woff文件的信息储存为xml格式, 我们可以在xml里查看一些相关内容
trans.xml的输出信息太长了这里就贴一部分
  <TTGlyph name="uniE89E" xMin="0" yMin="-12" xMax="516" yMax="706">

      <contour>

        <pt x="134" y="195" on="1"/>

        <pt x="144" y="126" on="0"/>

        <pt x="217" y="60" on="0"/>

        <pt x="271" y="60" on="1"/>

        <pt x="335" y="60" on="0"/>

        <pt x="423" y="158" on="0"/>

        <pt x="423" y="311" on="0"/>

        <pt x="337" y="397" on="0"/>

        <pt x="270" y="397" on="1"/>

        <pt x="227" y="397" on="0"/>

        <pt x="160" y="359" on="0"/>

        <pt x="140" y="328" on="1"/>

        <pt x="57" y="338" on="1"/>

        <pt x="126" y="706" on="1"/>

        <pt x="482" y="706" on="1"/>

        <pt x="482" y="622" on="1"/>

        <pt x="197" y="622" on="1"/>

        <pt x="158" y="430" on="1"/>

        <pt x="190" y="452" on="0"/>

        <pt x="258" y="475" on="0"/>

        <pt x="293" y="475" on="1"/>

        <pt x="387" y="475" on="0"/>

        <pt x="516" y="346" on="0"/>

        <pt x="516" y="243" on="1"/>

        <pt x="516" y="147" on="0"/>

        <pt x="459" y="75" on="1"/>

        <pt x="390" y="-12" on="0"/>

        <pt x="271" y="-12" on="1"/>

        <pt x="173" y="-12" on="0"/>

        <pt x="112" y="42" on="1"/>

        <pt x="50" y="98" on="0"/>

        <pt x="42" y="188" on="1"/>

      </contour>

      <instructions/>

    </TTGlyph>
然后我们发现每一个数字编码都对应一个这样的信息,每个信息的内容都不相同。经过细心的比对各个woff文件我们发现不同文件之间相同的数字对应的第一行<pt>内容是相同的,所以只要通过解析出一个woff里编码的数字内容,其他woff的就都可以解析。为此我做了一个解析表
NUM_ATTR = {

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '': {'x': '', 'y': '', 'on': ''},

    '.': {'x': '', 'y': '', 'on': ''},

}
然后可以根据这个表的内容来解析每一次爬下来的woff文件内容,搞成一个转换表。
def parse_transform(self):
    self.font.saveXML('trans.xml')
    tree = etree.parse("trans.xml")
    TTGlyph = tree.xpath(".//TTGlyph")
    translate_form = {}
    for ttg in TTGlyph[1:11]:
        ttg_dic = dict(ttg.attrib)
        attr_dic = dict(ttg.xpath('./contour/pt')[0].attrib)
        name = chr(int(ttg_dic['name'][3:7], 16))    # 字符串转 16进制数字 再转unicode
        ttg_dic.pop('name')
        for num, dic in NUM_ATTR.items():
            if dic == attr_dic:
                translate_form[name] = num
    return translate_form
最好把这表保存一下,这样以后遇到重复的字体就不用重复解析了。
贴一下完整代码,使用的是scrapy框架,没有用其他组件,而且只爬了一个页面,所以只贴爬虫的内容了
# -*- coding: utf-8 -*-
import re
import os
import json
import scrapy
import requests
from fontTools.ttLib import TTFont
from lxml import etree

NUM_ATTR = {
    '8': {'x': '177', 'y': '388', 'on': '1'},
    '7': {'x': '47', 'y': '622', 'on': '1'},
    '6': {'x': '410', 'y': '534', 'on': '1'},
    '5': {'x': '134', 'y': '195', 'on': '1'},
    '1': {'x': '373', 'y': '0', 'on': '1'},
    '3': {'x': '130', 'y': '201', 'on': '1'},
    '4': {'x': '323', 'y': '0', 'on': '1'},
    '9': {'x': '139', 'y': '173', 'on': '1'},
    '2': {'x': '503', 'y': '84', 'on': '1'},
    '0': {'x': '42', 'y': '353', 'on': '1'},
    '.': {'x': '20', 'y': '20', 'on': '1'},
}

class MaoyanspSpider(scrapy.Spider):
    name = 'maoyansp'
    start_urls = ['https://maoyan.com/films/1212492']
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.115 Safari/537.36"
    }

    def parse(self, response):
        font_link = re.findall(r'vfile.meituan.net/colorstone/(\w+\.woff)',
                               response.text)[0]
        self.get_font(font_link)
        data = self.parse_item(response)
        print(data)

    def parse_item(self, response):
        html = etree.HTML(response.body.decode('utf-8'))
        name = html.xpath('.//div[@class="movie-brief-container"]/h3/text()')[0]
        movie_content = html.xpath('.//div[@class="movie-stats-container"]')[0]
        content = movie_content[0].xpath('.//span[@class="stonefont"]/text()')
        score = content[0]
        comment_count = content[1]
        box = movie_content[1].xpath('.//span[@class="stonefont"]/text()')[0]
        box_unit = movie_content[1].xpath('.//span[@class="unit"]/text()')[0]
        score = self.modify_data(score)
        comment_count = self.modify_data(comment_count)
        box = self.modify_data(box)
        data = {
            "name": name,
            "score": score,
            "comment_count": comment_count,
            "box": box,
            "box_unit": box_unit
        }
        return data

    def download_font(self, link):
        download_link = 'http://vfile.meituan.net/colorstone/' + link
        woff = requests.get(download_link)
        with open(r'./fonts/' + link, 'wb') as f:
            f.write(woff.content)

    def get_font(self, link):
        file_list = os.listdir(r'.\fonts')
        if link not in file_list:
            self.download_font(link)
            print("字体不在库中:", link)
        else:
            print("字体在库中:", link)
        self.font = TTFont('./fonts/' + link)
        self.transform = './transform/' + link.replace('.woff', '.json')

    def modify_data(self, data):
        print(data)
        trans_form = self.get_transform()
        for name, num in trans_form.items():
            if name in data:
                data = data.replace(name, num)
        return data

    def get_transform(self):
        file_list = os.listdir(r'.\transform')
        if self.transform in file_list:
            with open(self.transform, 'r') as f:
                file = f.read()
            return json.loads(file)
        else:
            translate_form = self.parse_transform()
            with open(self.transform, 'w') as f:
                f.write(json.dumps(translate_form))
            return translate_form

    def parse_transform(self):
        self.font.saveXML('trans.xml')
        tree = etree.parse("trans.xml")
        TTGlyph = tree.xpath(".//TTGlyph")
        translate_form = {}
        for ttg in TTGlyph[1:11]:
            ttg_dic = dict(ttg.attrib)
            attr_dic = dict(ttg.xpath('./contour/pt')[0].attrib)
            hexstr = ttg_dic['name'][3:7]
            name = chr(int(hexstr, 16))    # 字符串转 16进制数字 再转unicode
            ttg_dic.pop('name')
            for num, dic in NUM_ATTR.items():
                if dic == attr_dic:
                    translate_form[name] = num
        return translate_form
由于使用的python3,scrapy的response.body是Unicode,所以我只能直接通过这个body来修改内容.
前端反爬虫策略--font-face 猫眼数据爬取的更多相关文章
- 爬虫系列---scrapy全栈数据爬取框架(Crawlspider)
一 简介 crawlspider 是Spider的一个子类,除了继承spider的功能特性外,还派生了自己更加强大的功能. LinkExtractors链接提取器,Rule规则解析器. 二 强大的链接 ...
- crawler_爬虫_反爬虫策略
关于反爬虫和恶意攻击的一些策略和思路 有时网站经常受到恶意spider攻击,疯狂抓取网站内容,对网站性能有较大影响. 下面我说说一些反恶意spider和spam的策略和思路. 1. 通过日志分析来 ...
- 爬虫1.5-ajax数据爬取
目录 爬虫-ajax数据爬取 1. ajax数据 2. selenium+chromedriver知识准备 3. selenium+chromedriver实战拉勾网爬虫代码 爬虫-ajax数据爬取 ...
- 爬虫05 /js加密/js逆向、常用抓包工具、移动端数据爬取
爬虫05 /js加密/js逆向.常用抓包工具.移动端数据爬取 目录 爬虫05 /js加密/js逆向.常用抓包工具.移动端数据爬取 1. js加密.js逆向:案例1 2. js加密.js逆向:案例2 3 ...
- Python爬虫 股票数据爬取
前一篇提到了与股票数据相关的可能几种数据情况,本篇接着上篇,介绍一下多个网页的数据爬取.目标抓取平安银行(000001)从1989年~2017年的全部财务数据. 数据源分析 地址分析 http://m ...
- 爬虫系列4:Requests+Xpath 爬取动态数据
爬虫系列4:Requests+Xpath 爬取动态数据 [抓取]:参考前文 爬虫系列1:https://www.cnblogs.com/yizhiamumu/p/9451093.html [分页]:参 ...
- 另类爬虫:从PDF文件中爬取表格数据
简介 本文将展示一个稍微不一样点的爬虫. 以往我们的爬虫都是从网络上爬取数据,因为网页一般用HTML,CSS,JavaScript代码写成,因此,有大量成熟的技术来爬取网页中的各种数据.这次, ...
- 【个人】爬虫实践,利用xpath方式爬取数据之爬取虾米音乐排行榜
实验网站:虾米音乐排行榜 网站地址:http://www.xiami.com/chart 难度系数:★☆☆☆☆ 依赖库:request.lxml的etree (安装lxml:pip install ...
- 爬虫—Ajax数据爬取
一.什么是Ajax 有时候我们使用浏览器查看页面正常显示的数据与使用requests抓取页面得到的数据不一致,这是因为requests获取的是原始的HTML文档,而浏览器中的页面是经过JavaScri ...
随机推荐
- thinkphp5.0验证的封装
刚学完这个验证器封装,刚开始还是有点晕的,后面仔细看了两遍,才慢慢感觉到了继承这个方法的好处,看来还得慢慢锻炼锻炼; 问题:结合上篇的自定义验证器,发现每次使用验证器都重复这样写代码;//验证器$va ...
- 转 Mac 下自带的中文输入法不显示汉字提示问题
原文 https://blog.csdn.net/moxi_wang/article/details/50721326 当时聊天的时候不知道那个手指头按错了什么键 导致Mac自带的中文输入法不能提示显 ...
- nodejs故障cnpm没反应
莫名发生的故障cnpm没反应 重新整理nodejs使用流程 方案1 1.安装64位nodejs 2.设置代理 npm config set proxy http://127.0.0.1:9999 ...
- APP测试常用工具以及框架
APP测试常用工具以及框架 1)纯白盒方式的测试,Monkey.一般是开发用的比较多,动手能力强的同学可以自己去尝试下! 2)偏白盒的robotium,这家伙号称是黑盒,但是本人不太认同- 因为使用r ...
- Bellman-Ford算法(在边权可正可负时求最短路)
使用FIFO队列实现: bool bellman_ford(int s){ queue<int > Q; memset(inq,0,sizeof(inq)); memset(cnt,0,s ...
- 冰水挑战 HDU - 6495
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=6495 题解:DP!!! dp[i][j] 表示前i个挑战,接受了j个剩余的最大体力,最后输出体力大于0 ...
- REST SOAP Thrift 对比
别人的REST SOAP Thrift对比: 单项分数越高越好 项目 REST SOAP Thrift Extensibility 5 3 1 Neutrality 2 4 3 Independenc ...
- response响应
郭晨 软件151 1531610114 response1.response常用APIsetStatus:设置响应行当中的状态码setHeader:设置响应头信息getOutputStream:获得字 ...
- ifconfig中lo、eth0、br0、wlan0接口
在 实体机上 ifconfig 命令用于 显示或配置网络设备(网络接口卡) 或修改. 1. 显示内容分析: lo 回环接口lo Link encap:Local Loopback inet addr ...
- win10刻录光盘失败,一直显示有准备好写入到光盘中的文件
这是因为前面刻录留下的缓存导致的 解决方法是,删除系统刻录缓存文件 刻录缓存路径大概在以下位置(其中ase那个地方需要修改,改成自己的登录用户账号名即可) C:\Users\ase\AppData\L ...