
[python爬虫]简单爬虫功能
在我们日常上网浏览网页的时候,经常会看到某个网站中一些好看的图片,它们可能存在在很多页面当中,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材。
我们最常规的做法就是通过鼠标右键,选择另存为。但有些图片鼠标右键的时候并没有另存为选项,还有办法就通过就是通过截图工具截取下来,但这样就降低图片的清晰度。就算可以弄下来,但是我们需要几千个页面当中的图片,如果一个一个下载,你的手将残。好吧~!其实你很厉害的,右键查看页面源代码。
我们可以通过python 来实现这样一个简单的爬虫功能,把我们想要的代码爬取到本地。下面就看看如何使用python来实现这样一个功能。
一、获取整个页面数据
def get_content(url):

    """

    获取网页源码

    """

    html = urllib.urlopen(url)

    content = html.read()

    html.close()

    return content
二、抓取图片文件名
抓取文件名时,由于特殊符号会影响显示,所以将“ * ”,“ / ”等符号删
def get_name(name,file):

    """

    抓取图片文件名

    """

    self.picName = name.decode('utf-8')

    if "*" in self.picName:

        self.picName = self.picName.replace("*","")

    elif "/" in self.picName:

        self.picName = self.picName.replace("/","")

    print self.picName

def get_file(info):

    """

    获取img文件

    """

    soup = BeautifulSoup(info,"html.parser")

    # 找到所有免费下载的模块

    all_files = soup.find_all('a',title="免费下载")

    # 找到所有的hi标题

    titles = soup.find_all('h1')

    # 截取需要的标题

    for title in titles:

        name = str(title)[4:-5]

    # 获取文件名

    for file in all_files:

            get_name(name,file)
三、下载图片
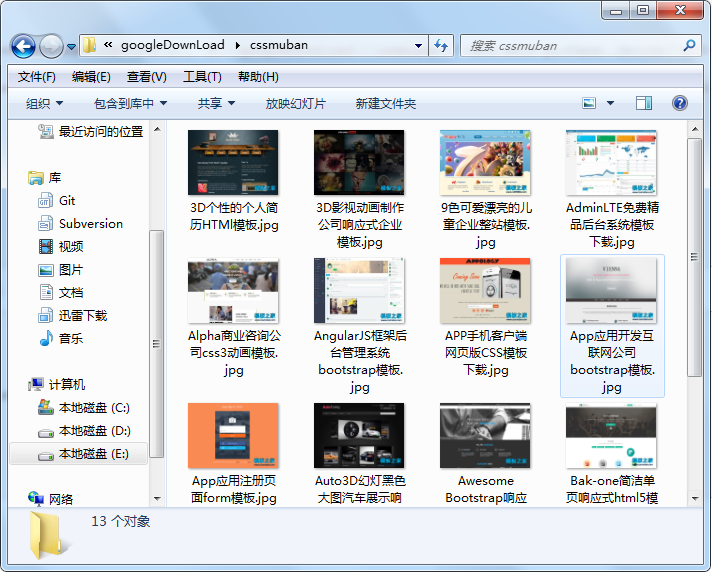
下载后缀名是"gif"或者"jpg"的图片,并存放在E:\\googleDownLoad\\\cssmuban目录下
def pic_category(str_images):

    """

    下载图片

    """

    soup = BeautifulSoup(info,"html.parser")

    all_image = soup.find_all('div',class_="large-Imgs")

    images = str_images

    pat = re.compile(images)

    image_code = re.findall(pat,str(all_image))

    for i in image_code:

        if str(i)[-3:] == 'gif':

            image = urllib.urlretrieve('http://www.cssmoban.com'+str(i), 'E:\\googleDownLoad\\\cssmuban\\'+str(self.picName).decode('utf-8')+'.gif')

        else:

            image = urllib.urlretrieve('http://www.cssmoban.com'+str(i), 'E:\\googleDownLoad\\\cssmuban\\'+str(self.picName).decode('utf-8')+'.jpg')

def pic_download(info):

    """

    下载图片

    """

    pic_category(r'src="(.+?\.gif)"')

    pic_category(r'src="(.+?\.jpg)"')
四、遍历所有url,下载每个页面的所需要的图片和文件名
self.num = 1

# 下载文件

for i in range(6000):

    url = 'http://www.cssmoban.com/cssthemes/'+ str(self.num) +'.shtml'

    info = get_content(url)

    get_file(info)

    pic_download(info)

    self.num = self.num + 1
运行结果如下:
本站文章为宝宝巴士 SD.Team原创,转载务必在明显处注明:(作者官方网站:宝宝巴士)
转载自【宝宝巴士SuperDo团队】 原文链接: http://www.cnblogs.com/superdo/p/4927574.html
[python爬虫]简单爬虫功能的更多相关文章
- Python开发简单爬虫 - 慕课网
课程链接:Python开发简单爬虫 环境搭建: Eclipse+PyDev配置搭建Python开发环境 Python入门基础教程 用Eclipse编写Python程序 课程目录 第1章 课程介绍 ...
- Python做简单爬虫(urllib.request怎么抓取https以及伪装浏览器访问的方法)
一:抓取简单的页面: 用Python来做爬虫抓取网站这个功能很强大,今天试着抓取了一下百度的首页,很成功,来看一下步骤吧 首先需要准备工具: 1.python:自己比较喜欢用新的东西,所以用的是Pyt ...
- python实现简单爬虫抓取图片
最近在学习python,正如大家所知,python在网络爬虫方面有着广泛的应用,下面是一个利用python程序抓取网络图片的简单程序,可以批量下载一个网站更新的图片,其中使用了代理IP的技术. imp ...
- Python开发简单爬虫(一)
一 .简单爬虫架构: 爬虫调度端:启动爬虫,停止爬虫,监视爬虫运行情况 URL管理器:对将要爬取的和已经爬取过的URL进行管理:可取出带爬取的URL,将其传送给“网页下载器” 网页下载器:将URL指定 ...
- Python开发简单爬虫
简单爬虫框架: 爬虫调度器 -> URL管理器 -> 网页下载器(urllib2) -> 网页解析器(BeautifulSoup) -> 价值数据 Demo1: # codin ...
- 教你如何入手用python实现简单爬虫微信公众号并下载视频
主要功能 如何简单爬虫微信公众号 获取信息:标题.摘要.封面.文章地址 自动批量下载公众号内的视频 一.获取公众号信息:标题.摘要.封面.文章URL 操作步骤: 1.先自己申请一个公众号 2.登录自己 ...
- python多线程简单爬虫
爬虫本质就是将网站或者接口的数据经过筛选后按需求保存 这里实现一个简单爬虫仅供参考 import requests import bs4 import threading import queue i ...
- python实现简单爬虫功能
在我们日常上网浏览网页的时候,经常会看到一些好看的图片,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材. 我们最常规的做法就是通过鼠标右键,选择另存为.但有些图片鼠标右键的 ...
- 使用python实现简单爬虫
简单的爬虫架构 调度器 URL管理器 管理待抓取的URL集合和已抓取的URL,防止重复抓取,防止死循环 功能列表 1:判断新添加URL是否在容器中 2:向管理器添加新URL 3:判断容器是否为空 4: ...
随机推荐
- 聊聊select, poll 和 epoll
聊聊select, poll 和 epoll 假设项目上需要实现一个TCP的客户端和服务器从而进行跨机器的数据收发,我们很可能翻阅一些资料,然后写出如下的代码. 服务端 void func(int s ...
- 大batch任务对structured streaming任务影响
信念,你拿它没办法,但是没有它你什么也做不成.—— 撒姆尔巴特勒 前言 对于spark streaming而言,大的batch任务会导致后续batch任务积压,对于structured streami ...
- react——key值的理解
key不是给开发者使用的,是给react在diff算法中使用的,diff算法会比较新旧虚拟dom,并且是同层比较,当同一层中有多个元素的时候,会比较这一层的key值, 如果key相同,属性改变积极更新 ...
- 王颖奇 201771010129 第三周 Java基本程序设计总结
实验三 Java基本程序设计 实验时间 2018-9-13 201771010129 王颖奇 1.实验目的与要求 (1)进一步掌握Eclipse集成开发环境下java程序开发基本步骤: (2)熟悉PT ...
- js基石之---es7的decorator修饰器
es7的decorator修饰器 装饰器(Decorator)是一种与类(class)相关的语法,用来注释或修改类和类方法. decorator就是给类添加或修改类的变量与方法的. 装饰器是一种函数, ...
- 杂记---主要关于PHP导出excel表格学习
今天上午处理了一下WIN7系统的电脑前置话筒和耳机口无法使用的问题,主要现象是耳机插入后没声音,麦插入话筒说话对方也听不到,后置端口一切正常.刚开始判断肯定是设置的问题,于是用另一台电脑百度搜索“wi ...
- 深入理解CSS定位—浮动模型
前面我们讲到了绝对定位,在这篇文章中,我们将讲到3种定位模型中的浮动模型.主要参考 张鑫旭在慕课网的 深入理解float 那些年我们一起清过的浮动---by 一丝丝凉 精通CSS 注意:第二小节基本参 ...
- [hdu1028]整数拆分,生成函数
题意:给一个正整数n,求n的拆分方法数(不考虑顺序) 思路:不妨考虑用1~n来构成n.用多项式表示单个数所有能构成的数,用多项式表示,就相当于卷积运算了. 1 2 3 4 5 6 7 8 9 10 1 ...
- [hdu5033]单调队列
题意:x轴上有n棵树,询问你站在某个点的视角.从左至右,单调队列(类似凸包)维护下.我强迫症地写了个模板QAQ #include <iostream> #include <cstdi ...
- C#操作时区转换时遇到的一些问题和解决方法分享
先上一下自己弄出来的库,.NETCore 2.2环境,以前的老库不在适用了TimeZoneInfo对象要熟悉 /// <summary> /// 获取当前时间戳 /// </summ ...