
【Python3 爬虫】15_Fiddler抓包分析
我们要抓取一些网页源码看不到的信息,例如:淘宝的评论等
我们可以使用工具Fiddler进行抓取
软件下载地址:https://pan.baidu.com/s/1nPKPwrdfXM62LlTZsoiDsg 密码:wche
安装不详细介绍,直接下一步即可
安装完成后,运行程序如下:
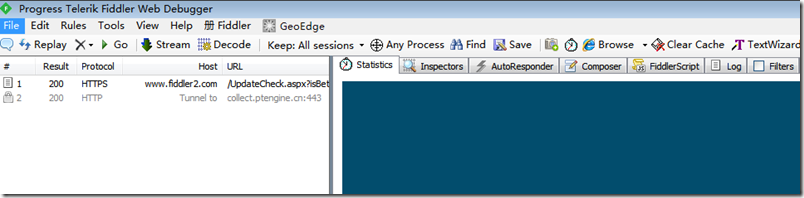
设置代理
打开火狐浏览器
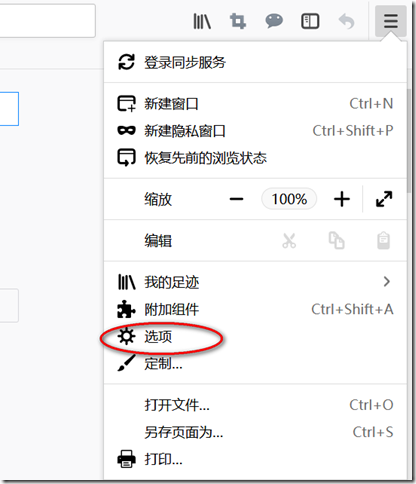
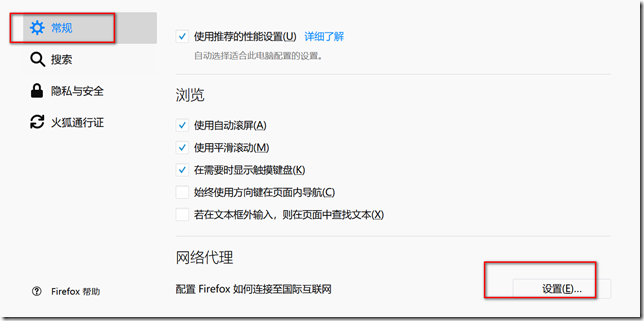
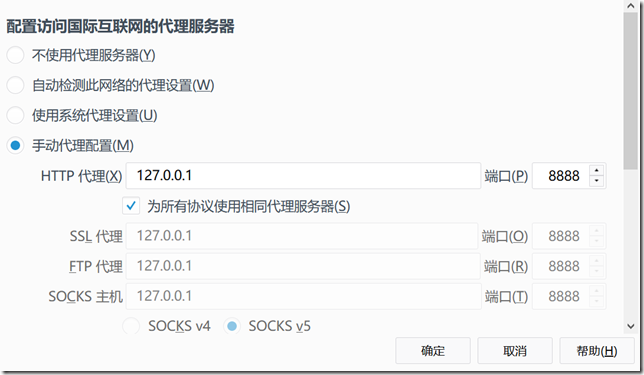
如下设置:
Fiddler默认只能抓取HTTP协议的网页,不能抓取HTTPS协议的网页,而我们很多时候,都需要抓HTTPS协议的网页。
Tool-----Options-----HTTPS,设置如下:
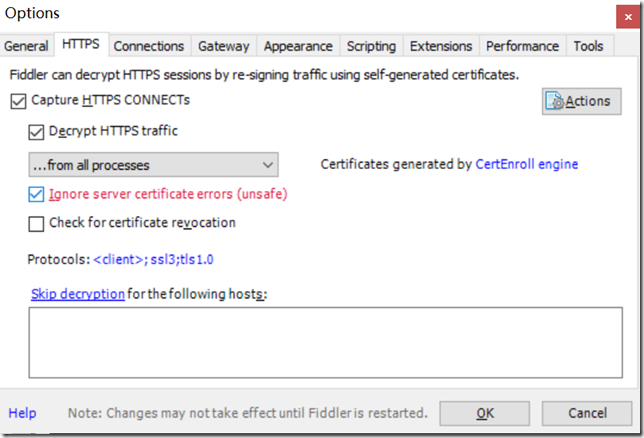
设置过程中或许会提示如下,直接点击Yes即可
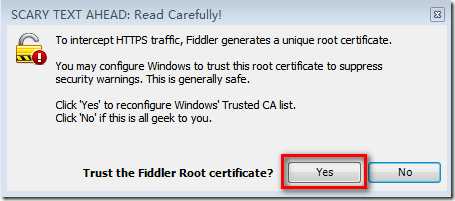
然后点击Actions----Export Root Certificate to Desktop

点击确定后,桌面上就出现该图标
接着,我们可以在浏览器导入该证书,我们打开火狐浏览器
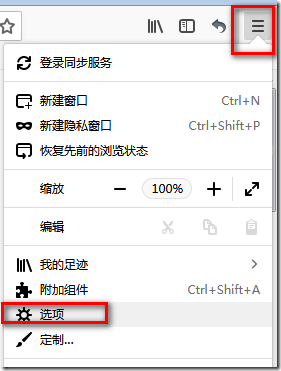
【选项】---【隐私与安全】--【证书】---【查看证书】---【导入】
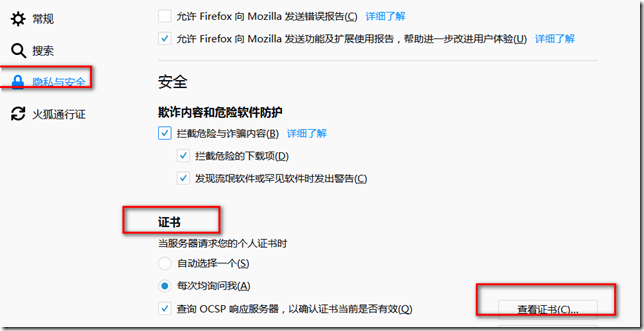
点击【导入】
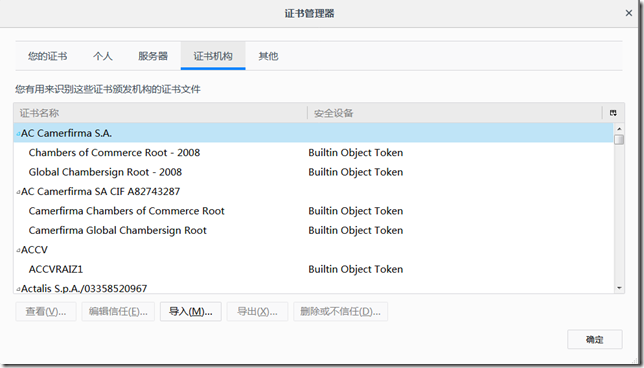
勾选下图所示2个按钮
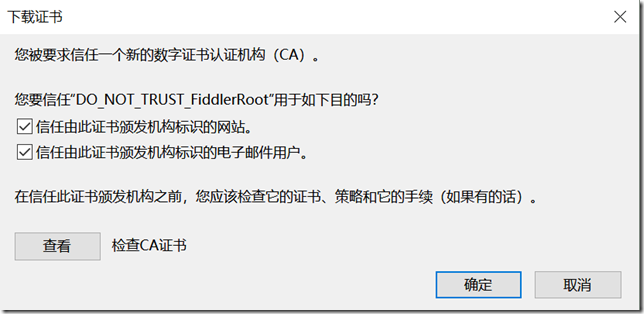
上述信息设置完毕之后,我们刷新网址:https://www.taobao.com/
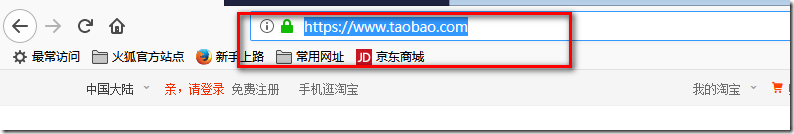
再看Fiddler什么也没有
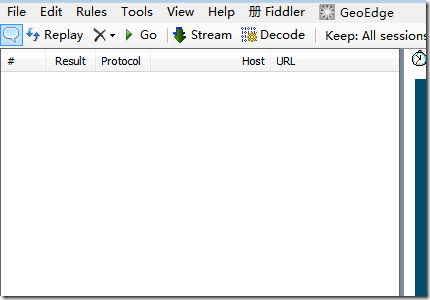
那么是什么问题呢?
接下来,我们win+R 并输入certmgr.msc并回车打开证书管理器
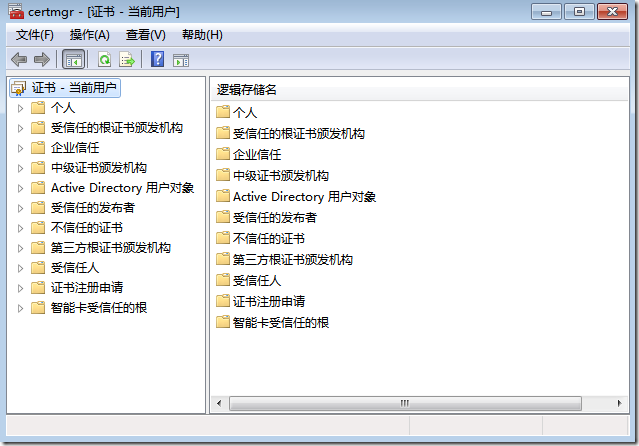
【操作】---【查找证书】
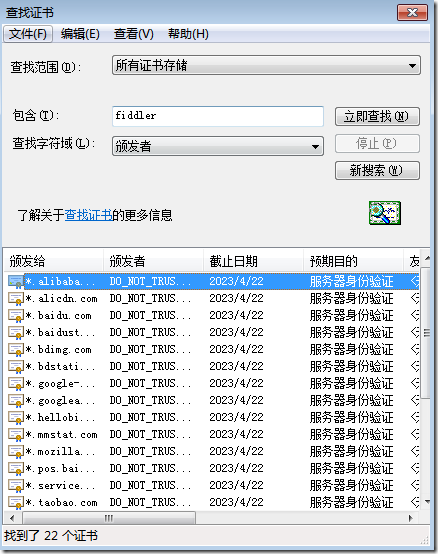
此处,我们找到了很多个证书,我们通过右键--删除所有证书
删除完成之后如下图:
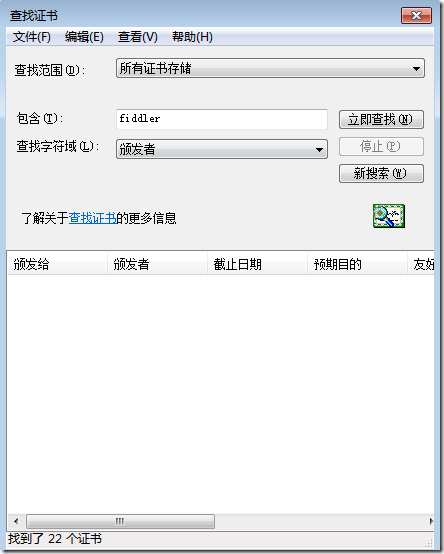
接下来,删除火狐中的相关证书
【选项】---【隐私与安全】---【证书】---【查看证书】
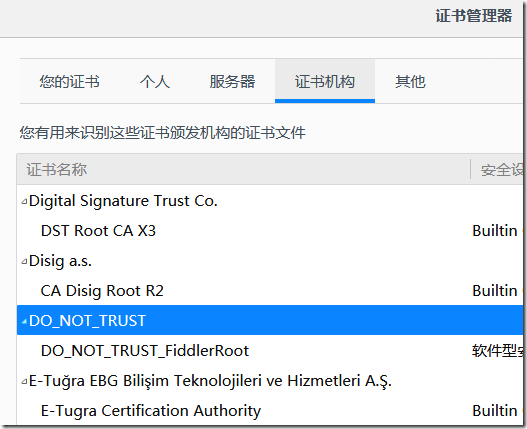
找到DO_NOT开头的Fiddler证书进行删除
依次删除【个人】、【服务器】、【其他】下的证书
这些证书删除完毕以后
点击以下地址下载文件
https://files.cnblogs.com/files/OliverQin/fiddlercertmaker.zip
下载后解压,直接打开,报错忽略即可
接着重启Fiddler,重启完毕后,随便打开一个商品的评论
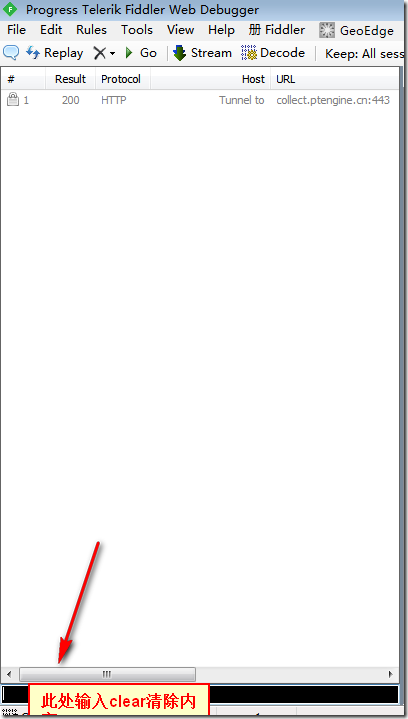
先使用clear清除内容,然后刷新评论
我刷新的页面如下:

刷新完毕之后再次看Fiddler
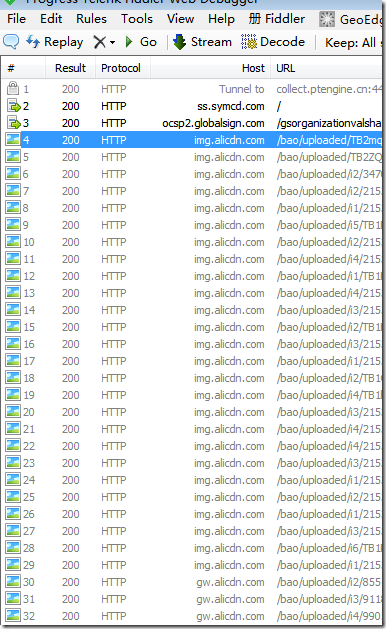
我们可以看到,已经可以抓取了,如果上述设置还是不行,那么打开Fiddler安装的目录:例如(D:\soft\fiddler)
在cmd中进入到该目录,执行以下代码
makecert.exe -r -ss my -n "CN=DO_NOT_TRUST_FiddlerRoot, O=DO_NOT_TRUST, OU=Created by http://www.fiddler2.com" -sky signature -eku 1.3.6.1.5.5.7.3.1 -h 1 -cy authority -a sha1 -m 120 -b 09/05/2012
执行结果如下:
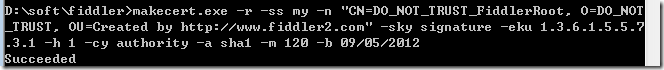
执行完毕之后再次导出导入CA证书。
【Python3 爬虫】15_Fiddler抓包分析的更多相关文章
- 抓包分析、多线程爬虫及xpath学习
1.抓包分析 1.1 Fiddler安装及基本操作 由于很多网站采用的是HTTPS协议,而fiddler默认不支持HTTPS,先通过设置使fiddler能抓取HTTPS网站,过程可参考(https:/ ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续一)
通过前一节得出地址可能的构建规律,如下: https://s.taobao.com/search?data-key=s&data-value=44&ajax=true&_ksT ...
- 爬虫系列(二) Chrome抓包分析
在这篇文章中,我们将尝试使用直观的网页分析工具(Chrome 开发者工具)对网页进行抓包分析,更加深入的了解网络爬虫的本质与内涵 1.测试环境 浏览器:Chrome 浏览器 浏览器版本:67.0.33 ...
- python爬虫(3)——用户和IP代理池、抓包分析、异步请求数据、腾讯视频评论爬虫
用户代理池 用户代理池就是将不同的用户代理组建成为一个池子,随后随机调用. 作用:每次访问代表使用的浏览器不一样 import urllib.request import re import rand ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析(续二)
一.URL分析 通过对“Python机器学习”结果抓包分析,有两个无规律的参数:_ksTS和callback.通过构建如下URL可以获得目标关键词的检索结果,如下所示: https://s.taoba ...
- Python 爬虫知识点 - 淘宝商品检索结果抓包分析
一.抓包基础 在淘宝上搜索“Python机器学习”之后,试图抓取书名.作者.图片.价格.地址.出版社.书店等信息,查看源码发现html-body中没有这些信息,分析脚本发现,数据存储在了g_page_ ...
- Wireshark抓包分析/TCP/Http/Https及代理IP的识别
前言 坦白讲,没想好怎样的开头.辗转三年过去了.一切已经变化了许多,一切似乎从没有改变. 前段时间调研了一次代理相关的知识,简单整理一下分享之.如有错误,欢迎指正. 涉及 Proxy IP应用 原理/ ...
- HTTP2特性预览和抓包分析
背景 近年来,http网络请求量日益添加,以下是httparchive统计,从2012-11-01到2016-09-01的请求数量和传输大小的趋势图: 当前大部份客户端&服务端架构的应用程序, ...
- 抓包分析SSL/TLS连接建立过程【总结】
1.前言 最近在倒腾SSL方面的项目,之前只是虽然对SSL了解过,但是不够深入,正好有机会,认真学习一下.开始了解SSL的是从https开始的,自从百度支持https以后,如今全站https的趋势越来 ...
随机推荐
- Burpsuite使用技巧
在bp任意窗口中,选中需要转码的字符串,按ctrl+b,则可以被转换成base64编码
- LaTeX需要renewcommand的地方
发现了两篇关于\renewcommand的文章,希望大家有更好的建议,请多多指教! 文章来源:http://blog.csdn.net/loveaborn/article/details/915205 ...
- HDU 1856 More is better (并查集)
题意: 给你两个数代表这两个人是朋友,朋友的朋友还是朋友~~,问这些人组成的集合里面人最多的是多少... 思路: 属于并查集了,我用的是带路径压缩的,一个集合里面所有元素(除了根节点)的父节点都是根节 ...
- Codeforces 891B - Gluttony
891B - Gluttony 题意 给出一个数字集合 \(a\),要求构造一个数组 \(b\) 为 \(a\) 的某个排列,且满足对于所有下标集合的子集 \(S=\{x_1,x_2,...,x_k\ ...
- cogs 服务点设置
3. 服务点设置 ☆ 输入文件:djsa.in 输出文件:djsa.out 简单对比时间限制:1 s 内存限制:128 MB 问题描述为了进一步普及九年义务教育,政府要在某乡镇建立一所 ...
- 简化的INSERT语句
INSERT语句中也并不需要我们指定表中的所有列,比如在插入数据的时候某些字段没有值,我们可以忽略这些字段.下面我们插入一条没有备注信息的数据: INSERT INTO T_Person(FAge,F ...
- 前端基础-HTML简介及发展史
一 HTML简介 二 HTML发展史 一. HTML简介 用户使用浏览器打开网页看到结果的过程就是:浏览器将服务端的文本文件(即网页文件)内容下载到本地,然后打开显示的过程. 而文本文件的文档结构只有 ...
- [CF911A]Nearest Minimums
题目大意: 给你一个数列,问数列中最小数的最近距离. 思路: 直接模拟即可. #include<cstdio> #include<cctype> #include<alg ...
- Entity Framework part2
EF原理以XML方式打开edmx文件,这个XML的文件主要包含两大部分:Runtime是类模型部分,Designer是VS中的图形界面重点讨论的是Runtime部分,又分为三大部分:SSDL数据模型部 ...
- Android 架构 1.架构
项目分为了四个层级:模型层.接口层.核心层.界面层.模型层定义了所有的模型:接口层封装了服务器提供的API:核心层处理所有业务逻辑:界面层就处理界面的展示.几个层级之间的关系如下图所示: 层级关系:模 ...