
Hive知识
HIVEQL
CREATE DATABASE financials(创建数据库)
SHOW DATABASES(显示数据库)
SHOW TABLES IN 数据库(列出数据库的所有表)
SHOW DATABASES LIKE 'h.*';(显示类似h以后任意多个字符)
LOCATION '/MY/preferred/directory';(指定数据库存放的路径)
COMMENT '**';(添加一个说明表)
DESCRIBE DATABASE financials(显示finacials数据库的一些信息))
DESCRIBE EXTENDEN table(列出表table的详细属性))
WITH DBPROPERTIES(‘*’,‘*’,)(添加注释说明的信息)
USE financials(切换到某个数据库下)
DROP DATABASE financials;(删除数据库)
ALTER DATABASE financials (修改数据库)
外部表:
CREATE EXTERNAL TABLE stocks(创建外部表)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
LOCATION '/data/stocks';
分区表:
CREATE TABLE employees()
PARTITIONED BY(country STRING,state STRING);
一种有效减少io量的手段
//显示分区为us的所有字分区
SHOW PARTITIONS employees PARTITION(country='US')
load data语句
LOAD DATA LOCAL INPATH '${env:HOME}/california-employees'
OVERWRITE INTO TABLE employees
PARTITION (country='us',state='CA');
Insert overwrite语句//把一个没有分区的表变成分区的表方式
INSERT OVERWRITE TABLE employees
PARTITION (country=‘us’,state=‘or’)
SELECT * FROM STAGED_employees se
WHERE se.cnty='us' AND se.st='or';
Dynamic Partition inserts动态分区表
INSERT OVERWRITE TABLE employees
PARTITION (country,state)
SELECT ...., se.cty, se.st
FROM staged_employees se
WHERE se.cnty='us';
Create table ...as select...
CREATE TABLE CA_employees
AS SELECT name,salary,address
FROM emplyees
WHERE se.state='CA' ;
导出数据:
INSERT OVERWRITE LOCAL DIRECTORY'/tmp/data'
SELECT name,salary,address
FROM employees
WHERE se.state='CA'
查询语句select

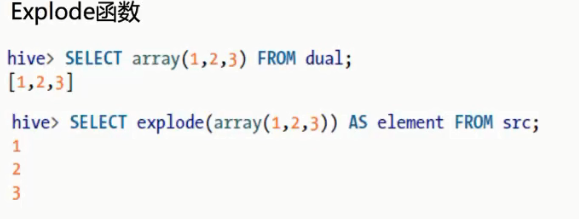
连接操作:
Hiveql支持大部分常见的关系代数连接方式(各种内连接,外连接,半连接)
连接是缓慢的操作
使用map-side joins来优化连接
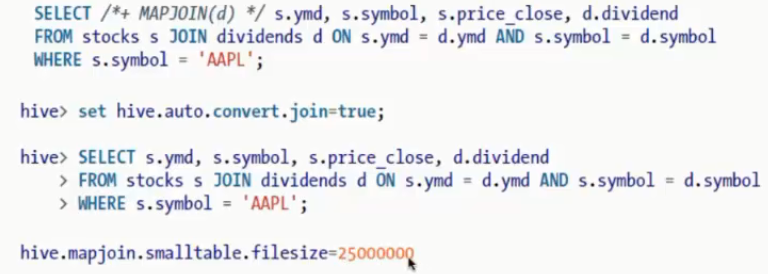
25000000=25m;
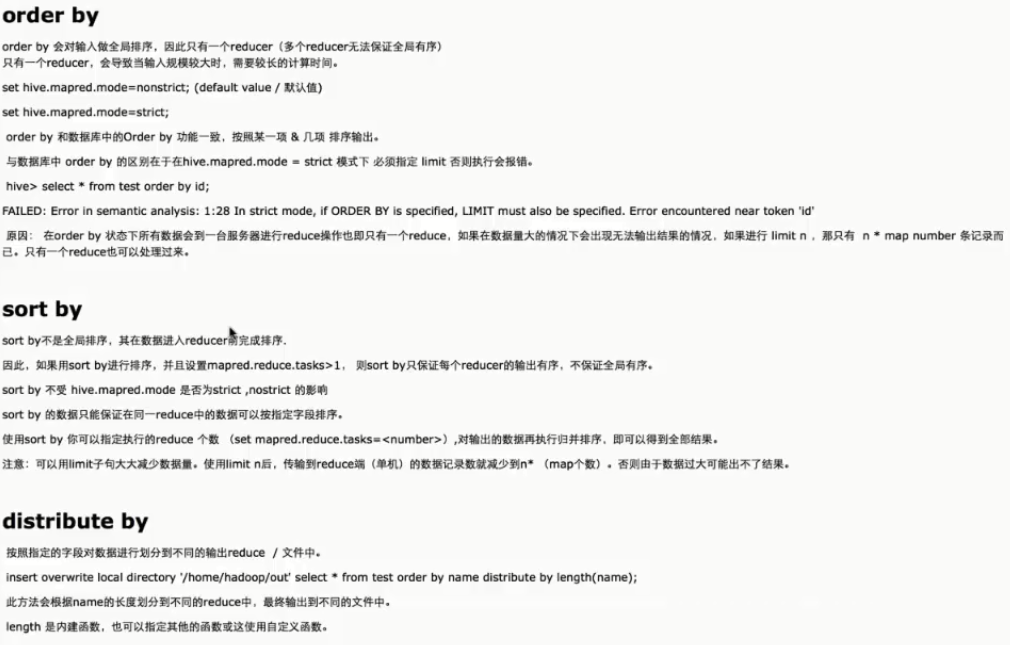
排序:
Hive知识的更多相关文章
- Hive知识汇总
两种Hive表 hive存储:数据+元数据 托管表(内部表) 创建表: hive> create table test2(id int,name String,tel String) > ...
- Hive 体系学习
Hive简介 Hive是一个基于Hadoop的数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并使用HQL作为查询接口.HDFS作为存储底层.MapReduce作为执行层,将HQL语句转换成M ...
- Trino总结
文章目录 1.Trino与Spark SQL的区别分析 2.Trino与Spark SQL解析过程对比 3.Trino基本概念 4.Trino架构 5.Trino SQL执行流程 6.Trino Ta ...
- Hive(一):架构及知识体系
Hive是一个基于Hadoop的数据仓库,最初由Facebook提供,使用HQL作为查询接口.HDFS作为存储底层.mapReduce作为执行层,设计目的是让SQL技能良好,但Java技能较弱的分析师 ...
- 《Programming Hive》读书笔记(两)Hive基础知识
<Programming Hive>读书笔记(两)Hive基础知识 :第一遍读是浏览.建立知识索引,由于有些知识不一定能用到,知道就好.感兴趣的部分能够多研究. 以后用的时候再具体看.并结 ...
- Hive 这些基础知识,你忘记了吗?
Hive 其实是一个客户端,类似于navcat.plsql 这种,不同的是Hive 是读取 HDFS 上的数据,作为离线查询使用,离线就意味着速度很慢,有可能跑一个任务需要几个小时甚至更长时间都有可能 ...
- Hive的基本知识与操作
Hive的基本知识与操作 目录 Hive的基本知识与操作 Hive的基本概念 为什么使用Hive? Hive的特点: Hive的优缺点: Hive应用场景 Hive架构 Client Metastor ...
- Hive基础知识梳理
Hive简介 Hive是什么 Hive是构建在Hadoop之上的数据仓库平台. Hive是一个SQL解析引擎,将SQL转译成MapReduce程序并在Hadoop上运行. Hive是HDFS的一个文件 ...
- Hive基础知识
一.产生背景 1.MapReudce编程繁琐,需要编写大量的代码 2.HDFS中存放的都是文件,在HDFS中没有Scheme的概念,无法用SQL进行快速的查询. 二.Hive的概念 Hive是基于Ha ...
随机推荐
- JS设置cookie,读取cookie,删除cookie
总结了一下cookie的使用,不全面.都是基础的知识,后期还会再添加. <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitiona ...
- something about Parameter Estimation (参数估计)
点估计 Point Estimation 最大似然估计(Maximum Likelihood Estimate —— MLE):视θ为固定的参数,假设存在一个最佳的参数(或参数的真实值是存在的),目的 ...
- Lua学习笔记:面向对象
Lua学习笔记:面向对象 https://blog.csdn.net/liutianshx2012/article/details/41921077 Lua 中只存在表(Table)这么唯一一种数据结 ...
- [CF735D]Taxes
题目大意:给你$n$,把它分成若干个数$n_i$,记价值为$\sum_{i=1}^k(\sum_{j|n_i}j-n_i)$(即分成的每个数的约数和(不包括自身)).(以前写的题,不知道为什么没交) ...
- [洛谷P3743]kotori的设备
题目大意:ことり有$n$个设备,每个设备每秒共减少$a_i$能量(也就是说每一瞬间都在减少,而不是在一个时刻突然减少),开始前有$b_i$能量,ことり还有一个充电宝,无限能量,每秒共可以提供$p$的能 ...
- mysql的增量备份
1,在mysql 的my.ini文件中 2在我的D盘下创建binlog文件夹 3重启mysql服务可以看到我的D盘下的binlog下生成如下文件 4,在默认的test数据库中创建t_one1这张表 c ...
- [NOIP2002] 字串变换 宽搜+深度优化
这道题硬是让我用STL水过.......而且题解里说的什么双向宽搜,交替扩展............... 这道题反正,STL用就用吧,但是状态数可以卡到千亿级别,因为这个东西是阶乘扩展的,然后我们发 ...
- [bzoj 2818]欧拉函数
题目链接:http://www.lydsy.com/JudgeOnline/problem.php?id=2818 枚举最大公约数,对于每一个质数p,只需要求出1<=x,y<=(n/p)范 ...
- HDU4725:The Shortest Path in Nya Graph(最短路)
The Shortest Path in Nya Graph Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 32768/32768 K ...
- Optimize Prime Sieve
/// A heavily optimized sieve #include <cstdio> #include <cstring> #include <algorith ...