
Python 懂车帝口碑分爬虫
| 本文所有教程及源码、软件仅为技术研究。不涉及计算机信息系统功能的删除、修改、增加、干扰,更不会影响计算机信息系统的正常运行。不得将代码用于非法用途,如侵立删! |
Python 懂车帝口碑分爬虫
需求
懂车帝全系车型懂车分(口碑)页面中的详细车系评分数据
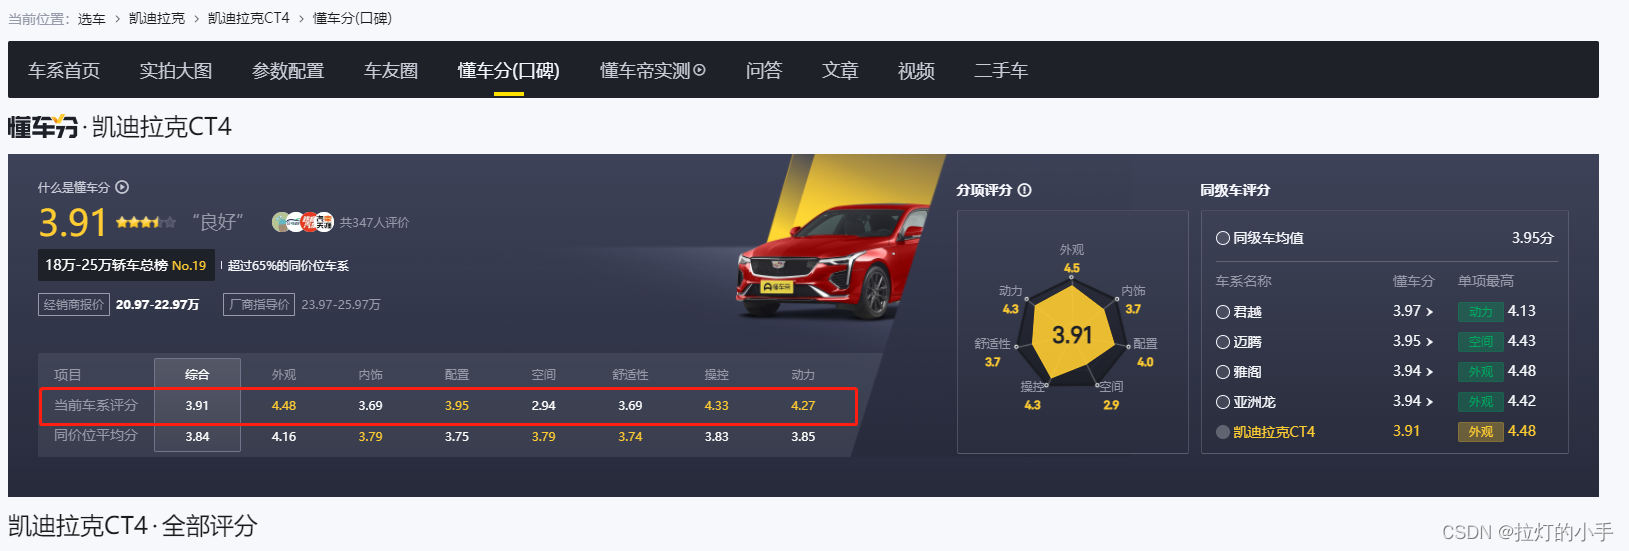
操作环境
- win10
- Google nexus5x(root)
- Python3.9
- Charles
需求分析
先来web端试下能否找到需要的数据接口,随便找个车型打开口碑页面F12查看Network
根据页面关键字先搜索一波
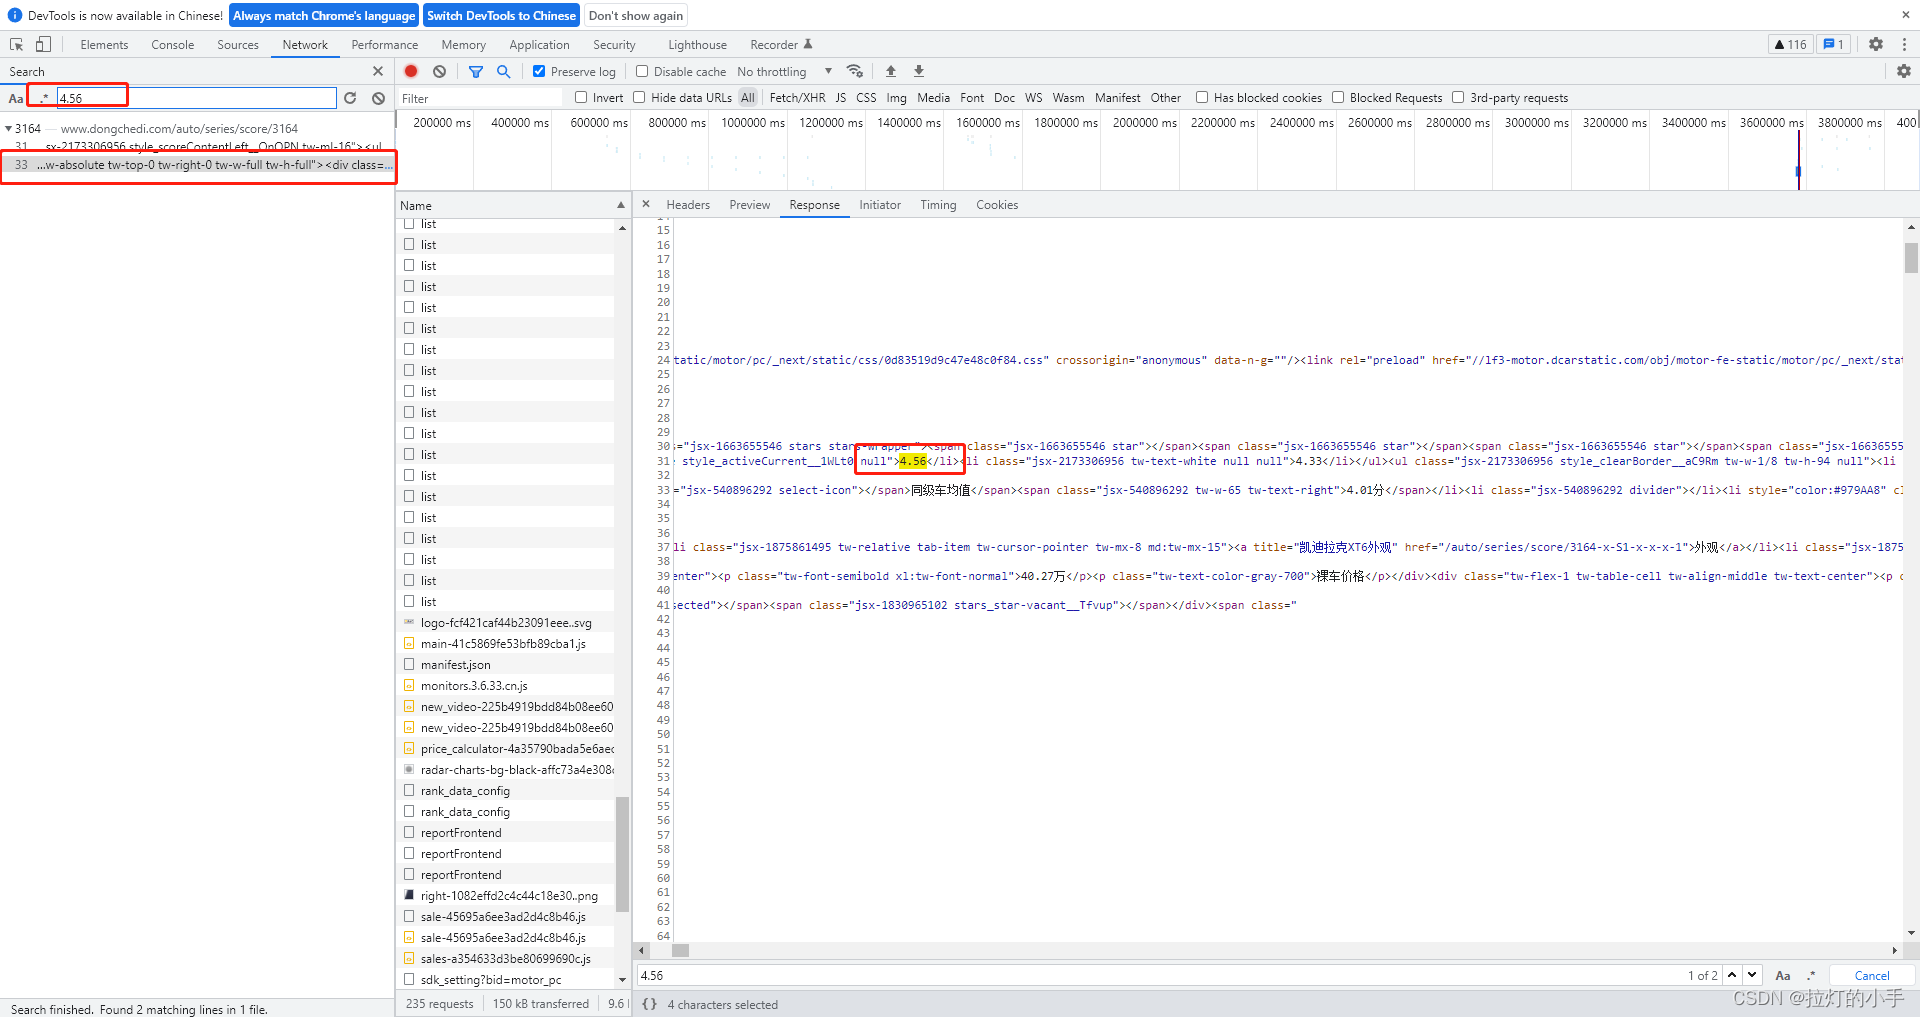
只在页面的标签中找到了数据,没有发现有明显的数据接口,其实用charles抓包的时候发现一个疑似的js好像数据是通过这个js加载出来的,打开看了一下数据相当混乱,暂且先放一边,先从APP分析一波看能否直接拿到数据接口
PS:手机环境、抓包环境的配置在这不在赘述,有兴趣的可参考之前的文章 APP抓包环境配置
下载懂车帝APP,并安装至手机
手机开启Postern,pc打开charles
至此抓包工作准备完成,打开懂车帝APP,随便找个车型进入懂车分页面
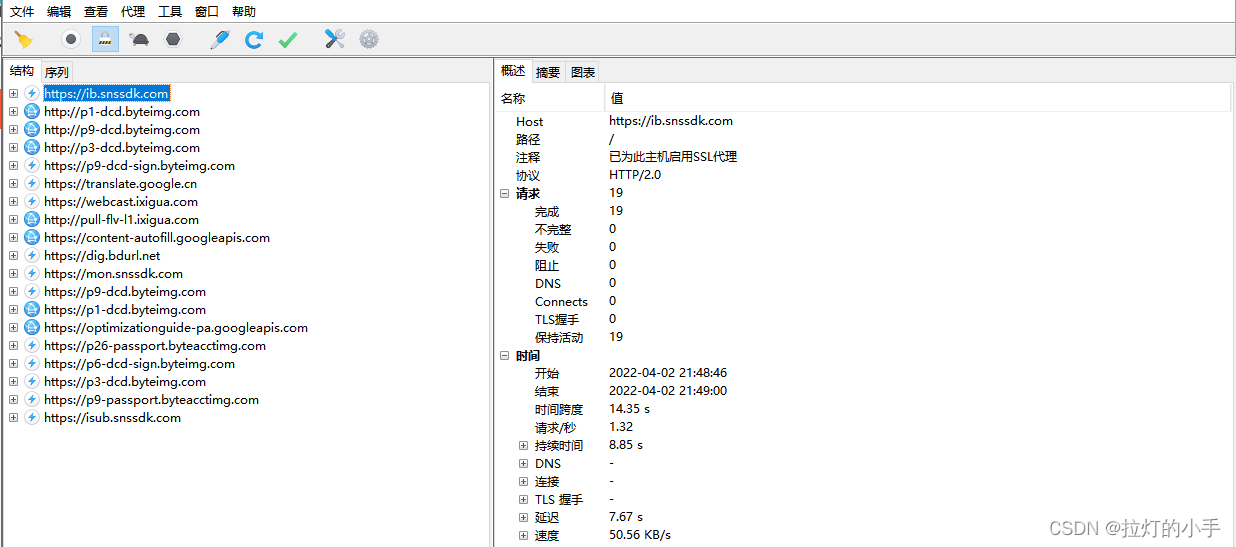
拿到加载的数据包,和web一样先搜索一波,看能否直接找到需要的数据
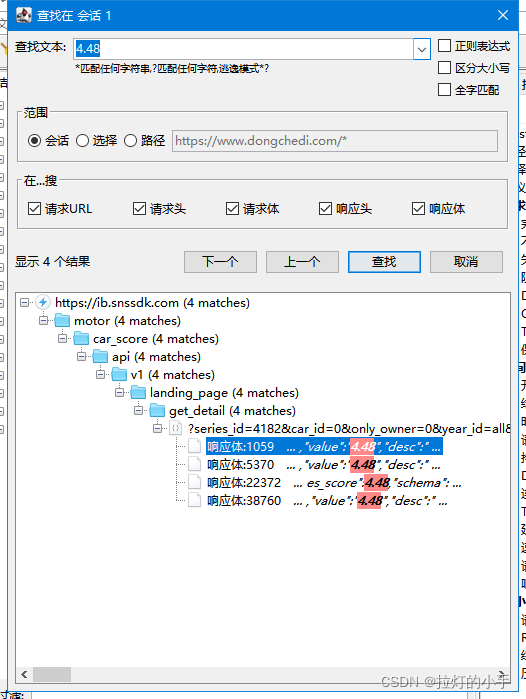
直接匹配到了多个结果,看接口是同一个接口返回的数据,双击点进去看一下详细数据
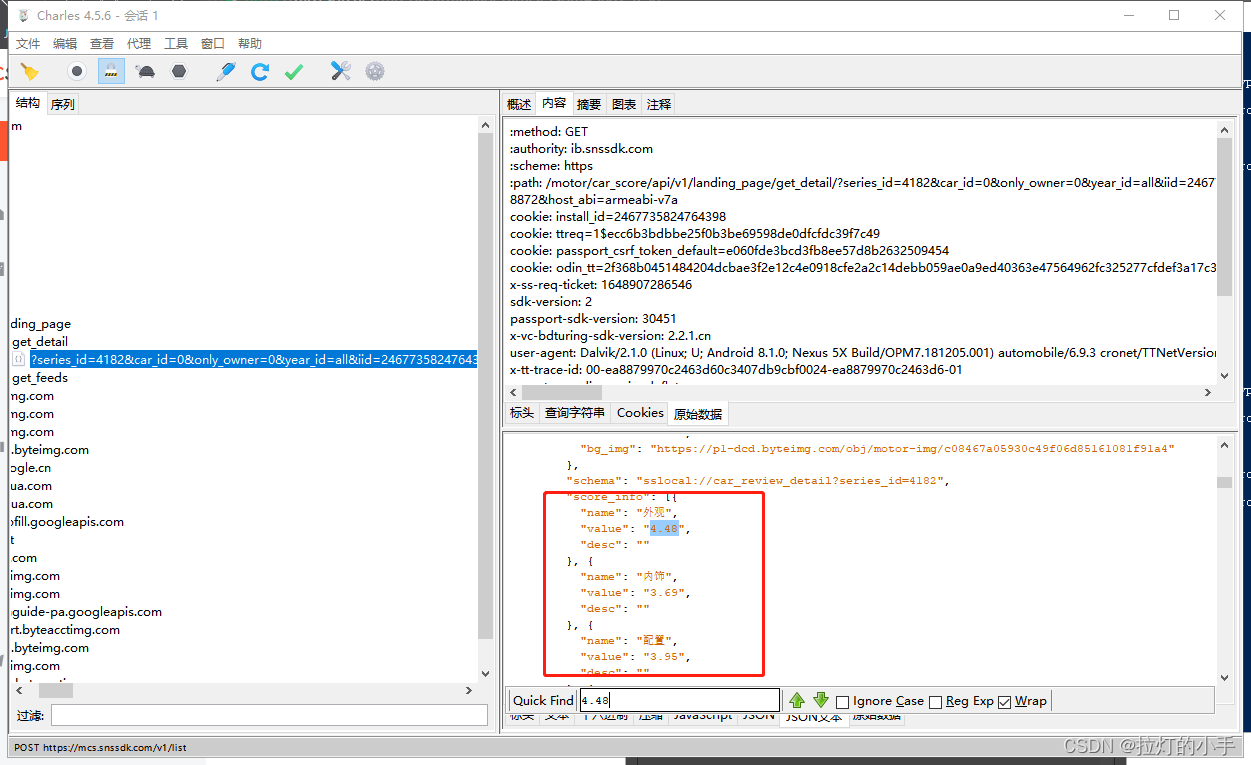

看数据结构和具体的数值和页面中的数据很像,Charles界面太小,将数据拷贝至网页中解析,方便分析,分享一个常用的json数据在线解析网站
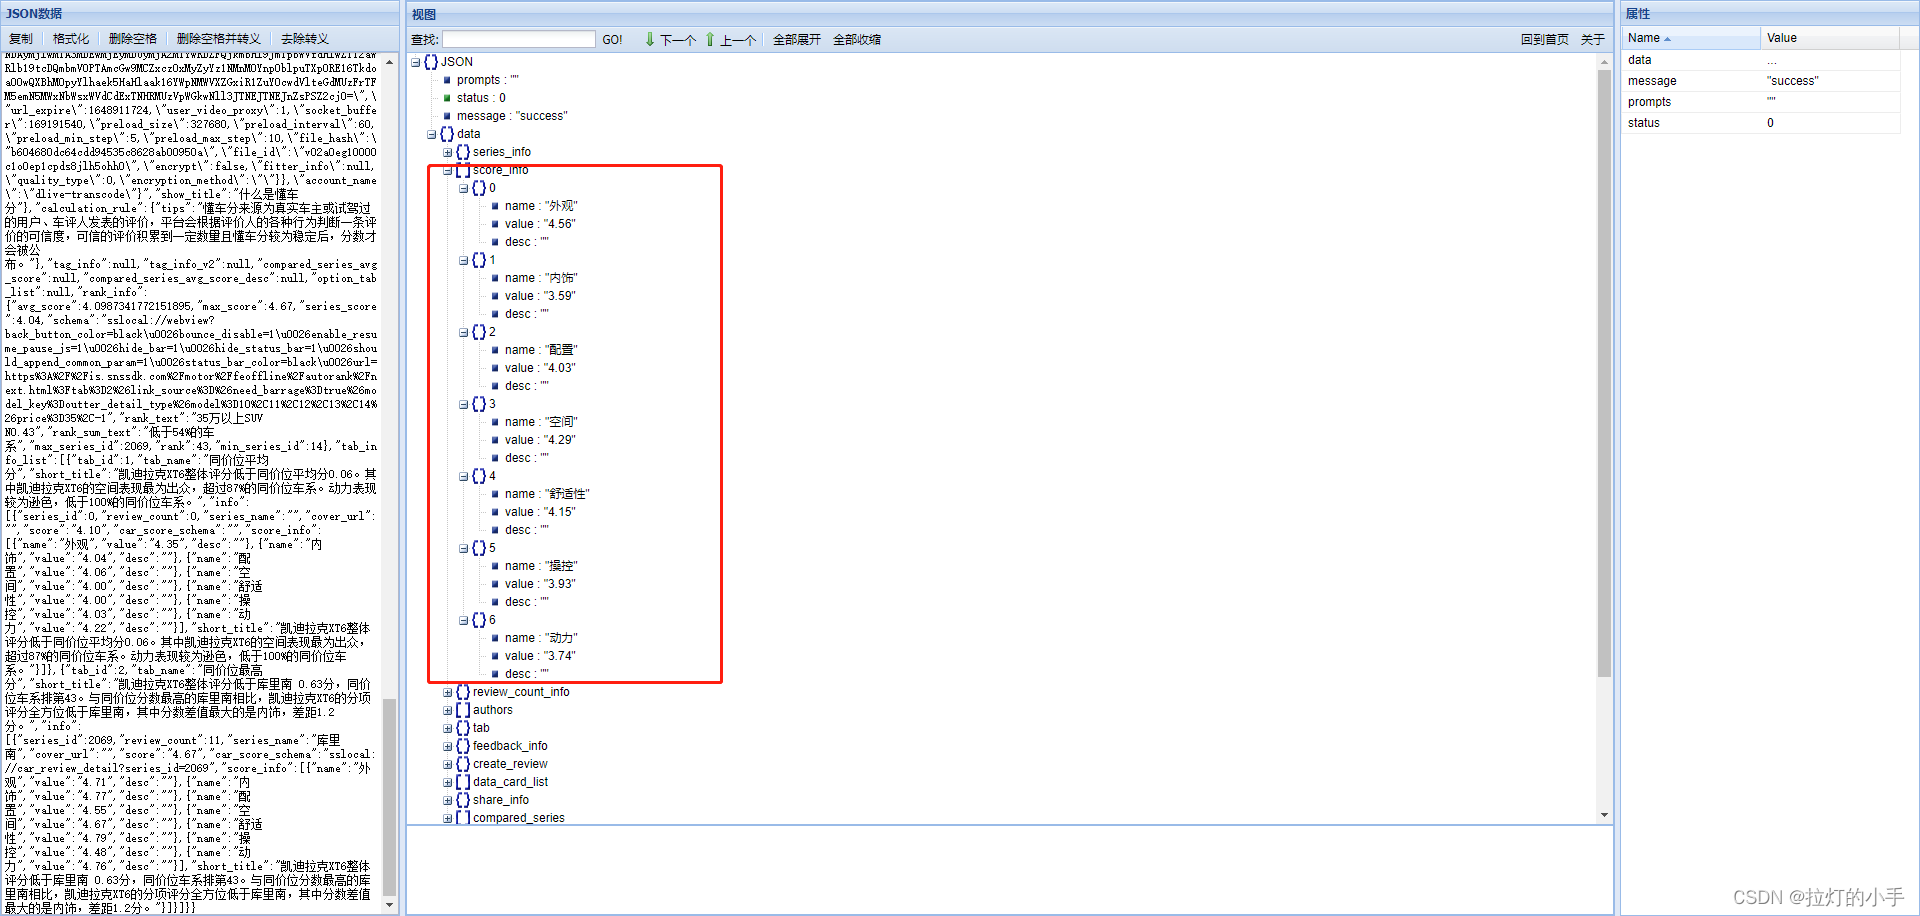
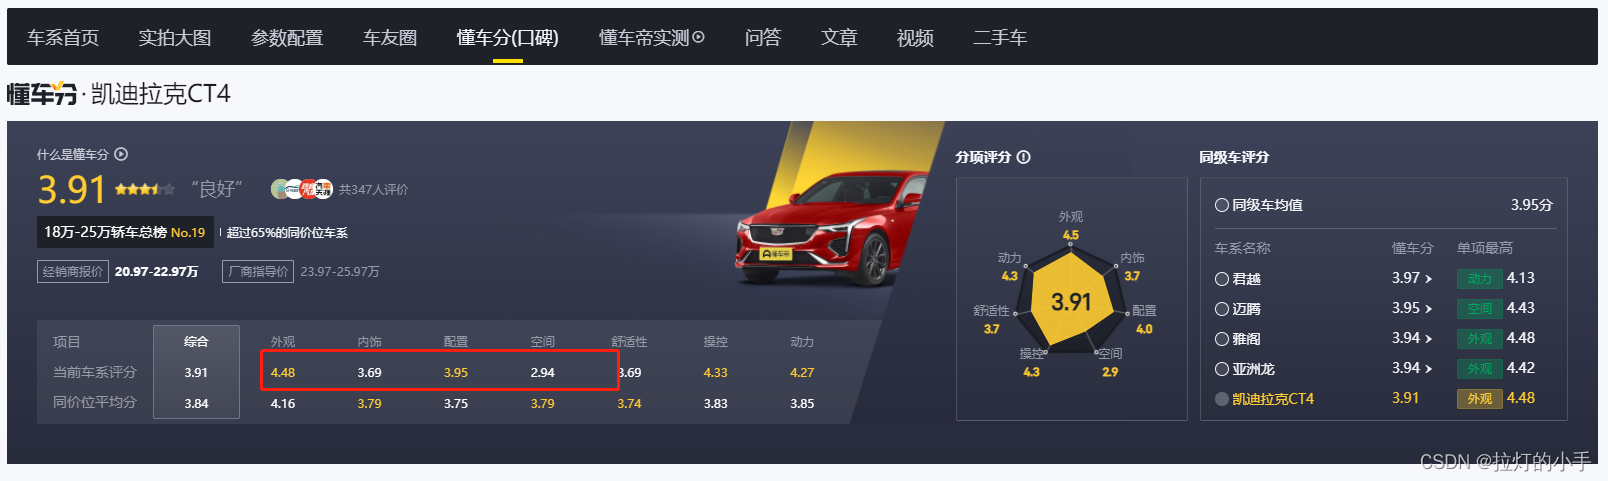
经过仔细分析,APP中展示的数据小数点第二位是四舍五入的,从下图的web页面中可以看出,数据是一样的,成功拿到数据接口!
口碑分数据接口:
https://*******/get_detail/?series_id=4182&car_id=0&only_owner=0&year_id=all&iid=2467735824764398&device_id=40011211486215&ac=wifi&channel=dcd-yd-11zh-and-74&aid=36&app_name=automobile&version_code=693&version_name=6.9.3&device_platform=android&os=android&ab_client=a1%2Cc2%2Ce1%2Cf2%2Cg2%2Cf7&ab_group=3167590%2C3577236%2C3333988&ssmix=a&device_type=Nexus+5X&device_brand=google&language=zh&os_api=27&os_version=8.1.0&manifest_version_code=693&resolution=1080*1794&dpi=420&update_version_code=6931&_rticket=1648907286543&cdid=f3163204-7faf-45d7-89c4-e82215c3216c&city_name=%E8%81%8A%E5%9F%8E&gps_city_name=%E8%81%8A%E5%9F%8E&selected_city_name&rom_version=27&longi_lati_type=1&longi_lati_time=1648907102913&content_sort_mode=0&total_memory=1.77&cpu_name=Qualcomm+Technologies%2C+Inc+MSM8992&overall_score=4.873&cpu_score=4.8872&host_abi=
对!你没看错,就是这么长,验证一下数据接口,在网页中直接请求一下这个url

这儿推荐安装一个网页json可视化的插件,这儿偷懒没装,在线解析了一下json数据,和Charles抓到的数据是一样,经过分析得知: series_id是车系id,修改此参数即可
获取全部车系id
获取车系id就很简单了,先拿到品牌id然后根据品牌id请求车系信息,注意这是一个post接口
def get_series(self, brand_id):

    """

    获取品牌所有车系

    brand_id:品牌id

    """

    headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/85.0.4183.121 Safari/537.36'}

    param = {

    'offset': 0,

    'limit': 1000,

    'is_refresh': 1,

    'city_name': '北京',

    'brand': brand_id

    }

    response = requests.post(url=url, data=param, headers=headers)

    rep_json = json.loads(response.text)

    # print(response.text)

    if rep_json['status'] == 'success':

    return rep_json['data']['series']

    else:

    raise Exception("get car series has exception!")

获取车系口碑分
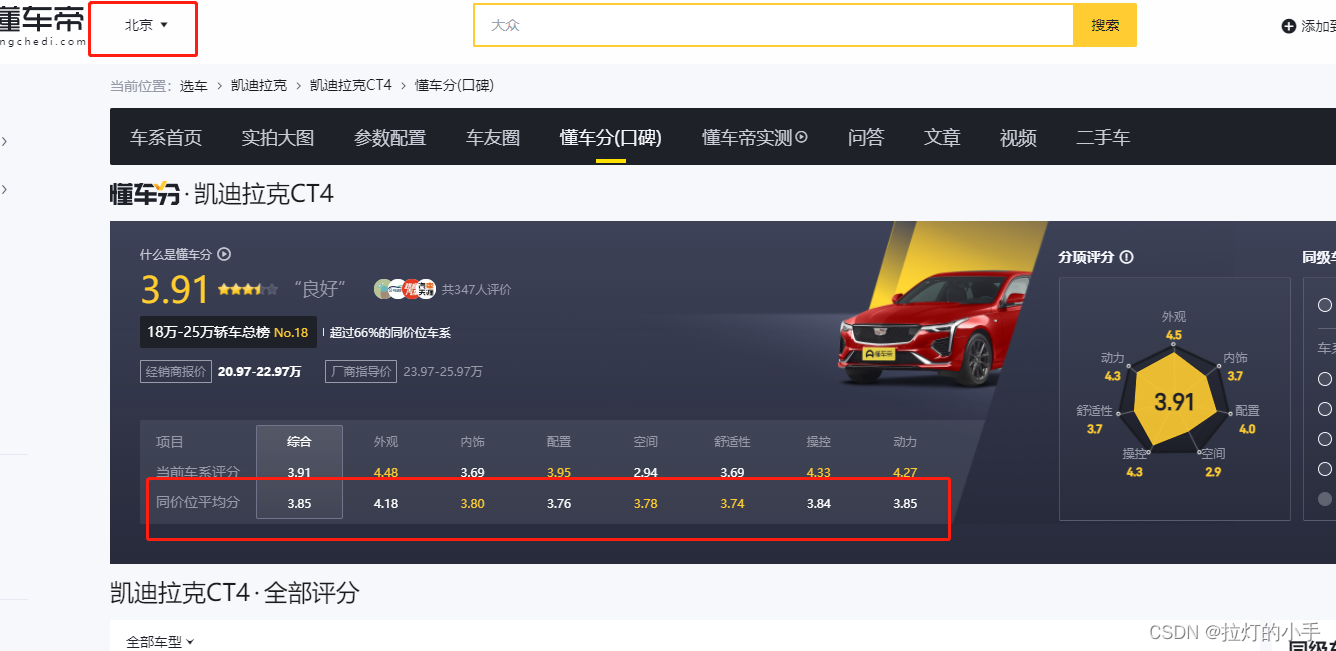
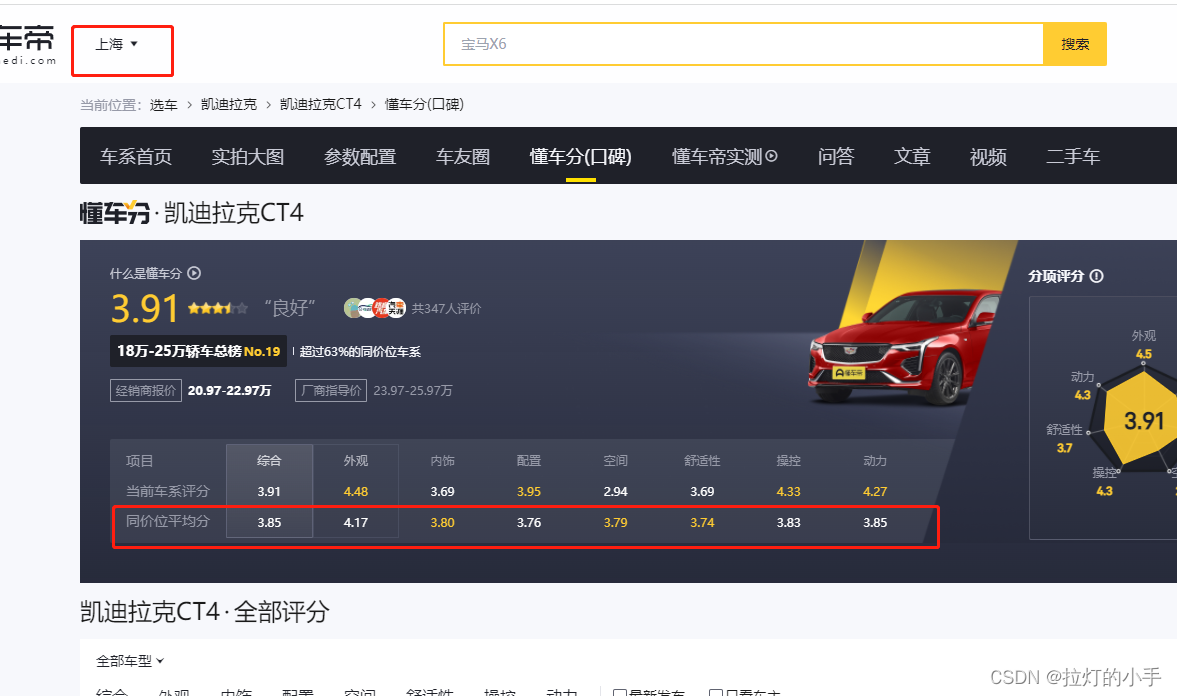
实际的运行过程中,发现一个问题,不同的城市同价位平均分是不一样的,所以需要指定城市获取
def get_score(self, series_id, city):

    """

    获取车系口碑分

    series_id: 车系id

    """

    response = self._parse_url(url).json()

    # 当前车系评分 综合

    series_info = list()

    series_info.append(response.get('data').get('series_info').get('score'))

    # 当前车系评分 详细

    score_info = response.get('data').get('score_info')

    if not score_info:

    return ['-'] * 16

    score = series_info + [i.get('value') for i in score_info]

    # 同价位平均分 综合

    tab_info_score = list()

    if response.get('data').get('tab_info_list'):

    tab_info_score.append(response.get('data').get('tab_info_list')[0].get('info')[0].get('score'))

    tab_info_score_info = response.get('data').get('tab_info_list')[0].get('info')[0].get('score_info')

    tab_info_score_info = tab_info_score + [i.get('value') for i in tab_info_score_info]

    else:

    tab_info_score_info = ['-'] * 8

    data = score + tab_info_score_info

    return data
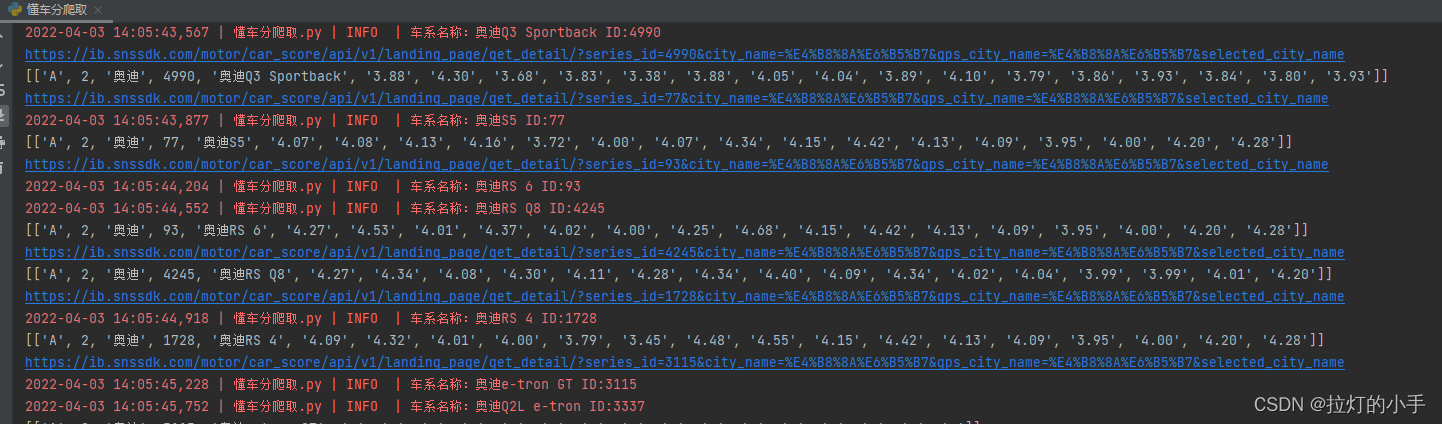
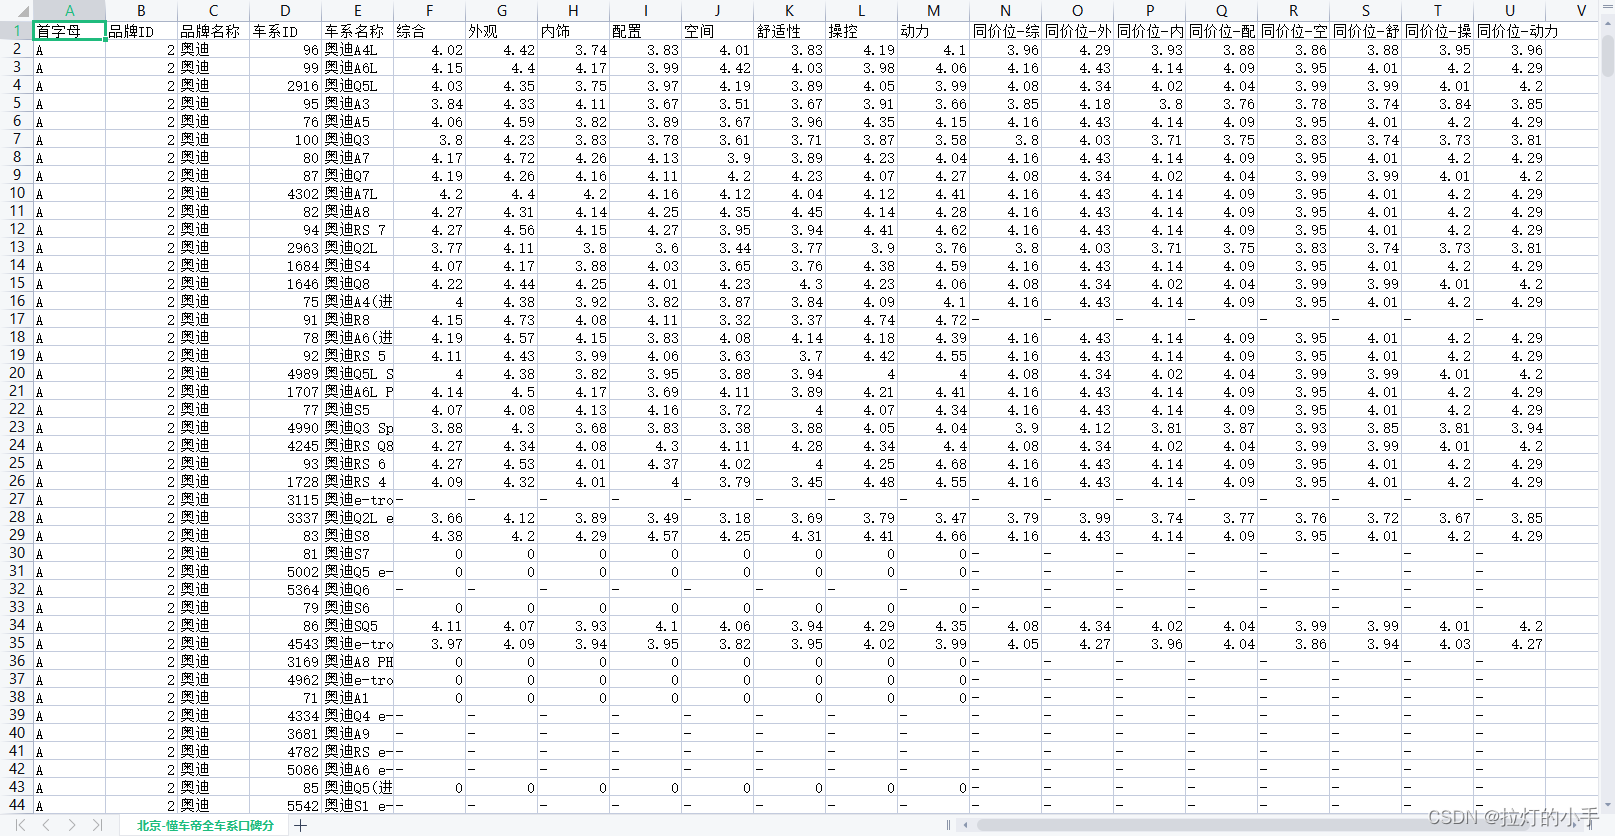
运行结果
资源下载
https://download.csdn.net/download/qq_38154948/85072078
| 本文仅供学习交流使用,如侵立删! |
Python 懂车帝口碑分爬虫的更多相关文章
- 【原创】Python 懂车帝口碑爬虫
本文所有教程及源码.软件仅为技术研究.不涉及计算机信息系统功能的删除.修改.增加.干扰,更不会影响计算机信息系统的正常运行.不得将代码用于非法用途,如侵立删! 懂车帝综合口碑 需求 操作环境 win1 ...
- Python 懂车帝综合口碑数据
本文所有教程及源码.软件仅为技术研究.不涉及计算机信息系统功能的删除.修改.增加.干扰,更不会影响计算机信息系统的正常运行.不得将代码用于非法用途,如侵立删! Python 懂车帝综合口碑数据 需求 ...
- Python 懂车帝全车系销量排行榜
本文所有教程及源码.软件仅为技术研究.不涉及计算机信息系统功能的删除.修改.增加.干扰,更不会影响计算机信息系统的正常运行.不得将代码用于非法用途,如侵立删! Python 懂车帝全车系销量排行榜 需 ...
- (转)Python新手写出漂亮的爬虫代码2——从json获取信息
https://blog.csdn.net/weixin_36604953/article/details/78592943 Python新手写出漂亮的爬虫代码2——从json获取信息好久没有写关于爬 ...
- (转)Python新手写出漂亮的爬虫代码1——从html获取信息
https://blog.csdn.net/weixin_36604953/article/details/78156605 Python新手写出漂亮的爬虫代码1初到大数据学习圈子的同学可能对爬虫都有 ...
- python scrapy版 极客学院爬虫V2
python scrapy版 极客学院爬虫V2 1 基本技术 使用scrapy 2 这个爬虫的难点是 Request中的headers和cookies 尝试过好多次才成功(模拟登录),否则只能抓免费课 ...
- 【python】一个简单的贪婪爬虫
这个爬虫的作用是,对于一个给定的url,查找页面里面所有的url连接并依次贪婪爬取 主要需要注意的地方: 1.lxml.html.iterlinks() 可以实现对页面所有url的查找 2.获取页面 ...
- Python爬取mc皮肤【爬虫项目】
首先,找到一个皮肤网站,其中一个著名的皮肤网站就是 https://littleskin.cn .进入网站,我们就会见到一堆皮肤,这就是今天我们要爬的皮肤.给各位分享一下代码. PS:另外很多人在学习 ...
- python 全栈开发,Day137(爬虫系列之第4章-scrapy框架)
一.scrapy框架简介 1. 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前S ...
随机推荐
- 2020级cpp机考模拟题A卷-#题解2
这部分的题目都有一定难度,有兴趣的同学可以钻研一下. 特此感谢来自BDT20030 tql的支持. 2:素数的和-2 题意: 计算不大于m的素数之和.(多么容易理解的题目啊,对吧) 题解(有点复杂的 ...
- .NET MAUI 正式版GA发布
.NET MAUI – 一个代码库,多个平台 欢迎使用 .NET 多平台应用 UI.此版本标志着我们统一 .NET 平台的多年旅程中的新里程碑.现在,您和超过 500 万其他 .NET 开发人员拥有了 ...
- 做一个能对标阿里云的前端APM工具(下)
上篇请访问这里做一个能对标阿里云的前端APM工具(上) 样本多样性问题 上一小节中的实施方案是微观的,即单次性的.具体的.但是从宏观上看,我需要保证性能测试是公允的,符合大众预期的.为了达到这种效果, ...
- MUI+html5的plus.webview页面传值在电脑浏览器上不可见
使用plus.webview.currentWebview() 获得当前窗口的webview对象后,再使用document.write()输出显示webview的某个属性值,而plus.webview ...
- 如何用HMS Core位置和地图服务实现附近地点路径规划功能
日常出行中,路径规划是很重要的部分.用户想要去往某个地点,获取到该地点的所有路径,再根据预估出行时间自行选择合适的路线,极大方便出行.平时生活中也存在大量使用场景,在出行类App中,根据乘客的目的地可 ...
- Java到底是解释型还是编译型语言
Java到底是解释型还是编译型语言? 定义 回答这个问题,我们首先来看下概念: 开发人员编写代码,语言是人类可理解的方式,是具有语义的,然而计算机无法理解和执行,因此需要做一层转换. 解释型语言: 运 ...
- css:音乐唱片机随着播放暂停而旋转暂停
唱片机由两部分组成,一个是磁针,另一个是唱片 1. 先完成磁针随着播放按钮进行是否在唱片上的切换 原理:将播放暂停状态存入布尔值isbtnShow中,根据isbtnShow的值切换磁针的class. ...
- Linux(Centos7)静默安装Oracle19C
Oracle数据库服务器一般都是Linux,Linux服务器一般都是在非图形界面的操作,本文章手把手教你如何在非图形界面安装Oracle19C. ORACLE 19C 的安装包自行在官网下载,下载免费 ...
- C语言 - 基础数据结构和算法 - 企业链表
听黑马程序员教程<基础数据结构和算法 (C版本)>,照着老师所讲抄的, 视频地址https://www.bilibili.com/video/BV1vE411f7Jh?p=1 喜欢的朋友可 ...
- 【转载】k8s入坑之路(2)kubernetes架构详解
每个微服务通过 Docker 进行发布,随着业务的发展,系统中遍布着各种各样的容器.于是,容器的资源调度,部署运行,扩容缩容就是我们要面临的问题. 基于 Kubernetes 作为容器集群的管理平台被 ...