
VideoMAE Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training概述
0.前言
1.针对的问题
视频存在非常多的冗余信息,所以,对视频的处理需要非常大的计算资源,transformer需要非常多的额外训练数据,此外,视频transformer高度依赖于预训练好的权重。作者的目标是在当前的视频数据集上以不依赖于任何额外预训练权重和数据的情况下训练一个原始的transformer模型。
2.主要贡献
1.提出了一个简单但有效的视频掩码自编码器,释放了原始视觉transformer视频识别的潜力。这是第一个仅使用普通ViT backbones的掩蔽视频预训练框架。为了缓解掩蔽视频建模中的信息泄漏问题,我们提出了极高比例的tube 掩蔽,从而提高了视频建模的性能。
2.与NLP和图像在掩蔽建模上的结果一致,VideoMAE证明了这种简单的掩蔽和重建策略为自监督视频预训练提供了一个很好的解决方案。用VideoMAE预先训练的模型明显优于那些从头开始训练或用对比学习方法预训练的模型。
3.获得了关于掩蔽建模的特别重要的发现,而这些发现在以前的NLP和图像研究中可能被忽略。(1)证明了VideoMAE是一种数据高效的学习器,可以通过3.5k个视频成功训练。(2)当源数据集和目标数据集之间存在域移时,数据质量比数量更重要。
3.方法
作者提出的VideoMAE尝试在两个方面解决上述挑战。
1.采用一种自监督的预训练方法,以掩蔽自编码器为基础,提出了一种对于视频的自监督预训练范式,
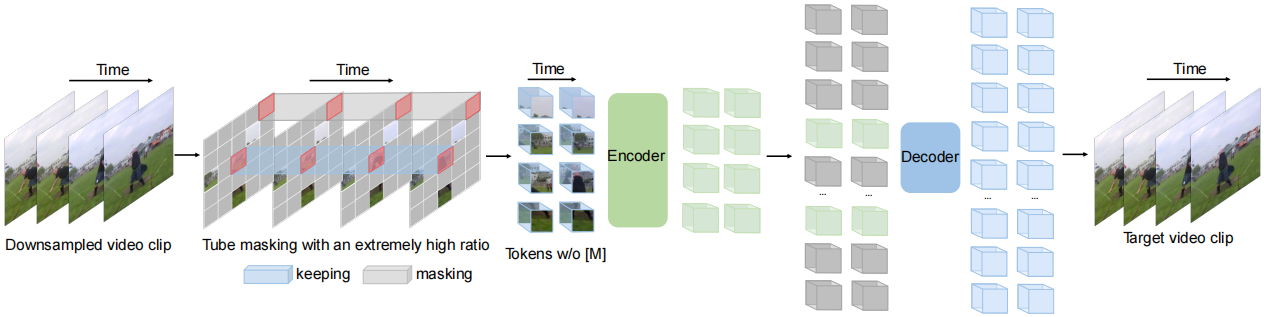
2.提出了一种新的以tube为形式的掩蔽操作,并且这种掩蔽操作具有非常大的掩码比率。如果不针对性地设计掩码策略,这种时序相关性可能会增加重建过程中的“信息泄漏”的风险。具体来说,如图所示,如果使用全局随机掩码或随机掩码图像帧,网络可以利用视频中的时序相关性,通过““复制粘贴””相邻帧中时序对应位置的未被遮蔽的像素块来进行像素块重建。这种情况下一定程度上也能完成代理任务,但是可能会导致VideoMAE仅仅能学习到较低语义的时间对应关系特征,而不是高层抽象的语义信息。
输入和输出都是一致的,整个自编码器结构就是要基于被掩蔽之后剩下的token来恢复出原始的视频,首先经过时序下采样的时序clip会进行tube mask掩码,掩码后未被掩蔽的token会被送入Decoder中,Decoder将基于这些token来恢复原始的视频,需要注意的是,这里的编码器和解码器都是vit的结构,不过编码器会比较大,解码器比较小,这将组成一个mask auto encoder的训练范式,这种范式非常的高效,因为只有一小部分的token会被送入解码器中进行处理,这种高效的预训练范式使得在视频上的预训练大大加速。
mask策略:tube mask指的是mask的操作在时序上是一致的,在空间上的某一帧随机进行掩码操作,之后时序上的各个帧都共享这种掩码操作,这样就形成了一种管道式的掩码,要注意的是掩码的比率是非常高的,达到90%到95%,这种掩码比率使得训练过程非常高效,同时,也为预训练设置了一种非常具有挑战性的代理任务,使得在下游各个识别检测task上都能取得很好的性能。
模型结构如下:
时序下采样
根据前文中对视频中密集连续帧中存在的时序冗余性的分析,因此在VideoMAE中选择采用带有时序间隔的采样策略来进行更加高效的视频自监督预训练。具体来说,首先从原始视频中随机采样一个由t个连续帧组成的视频片段。然后使用带有时序间隔采样将视频片段压缩为T帧,每个帧包含 H×W×3 个像素。在具体的实验设置中,Kinetics-400 和 Something-Something V2 数据集上的采样间隔τ分别设置为4和2。
时空块嵌入
在输入到编码器中之前,对于采样得到的视频片段,采用时空联合的形式进行像素块嵌入。具体来说,将大小为 T×H×W 视频片段中大小为 2×16×16 的视觉像素视为一个视觉像素块。因此,采样得到的视频片段经过时空块嵌入(cube embedding)层后可以得到 T/2×H/16×W/16 个视觉像素块。在这个过程中,同时会将视觉像素块的通道维度映射为 D 。这种设计可以减少输入数据的时空维度大小,一定程度上也有助于缓解视频数据的时空冗余性。
带有极高的掩码比率的管道式掩码策略
为了解决由视频数据中的时序冗余性和时序相关性导致的“信息泄漏”问题,本方法选择在自监督预训练的过程中采用管道式掩码策略。管道式的掩码策略可以将单帧彩色图像的掩码方式自然地在整个视频的时序上进行拓展,即不同的帧中相同空间位置的视觉像素块将被遮蔽。具体来说,管道式掩码策略可以表示为 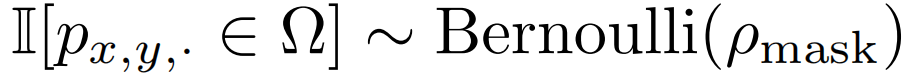 。不同的时间 t 共享相同的值。 使用这种掩码策略,相同空间位置的token将总是会被掩码。所以对于一些视觉像素块(例如,不同掩码策略的示例图第 4 行的包含手指的像素块),网络将无法在其他帧中找到其对应的部分。这种设计这有助于减轻重建过程中出现“信息泄露”的风险,可以让VideoMAE通过提取原始视频片段中的高层语义信息,来重建被掩码的token。
相对于图像数据,视频数据具有更强的冗余性,视频数据的信息密度远低于图像。这种特性使得VideoMAE使用极高的掩码率(例如 90% 到 95%)进行预训练。值得注意的是,MAE的默认掩码率为75% 。实验结果表明,使用极高的掩码率不仅能够加速预训练(仅有 5% 到 10% 的视觉像素块被输入到编码器中),同时能够提升模型的表征能力和在下游任务中的效果。
时空联合自注意力机制
前文中提到了VideoMAE采用了极高的掩码率,只保留了极少的token作为编码器的输入。为了更好地提取这部分未被遮蔽的token的时空特征,VideoMAE选择使用原始的ViT作为Backbone,同时在注意力层中采用时空联合自注意力(即不改变原始ViT的模型结构)。因此所有未被遮蔽的token都可以在自注意层中相互交互。时空联合自注意力机制的 O(n2) 级别的计算复杂度是网络的计算瓶颈,而前文中针对VideoMAE使用了极高掩码比率策略,仅将未被遮蔽的token(例如10%)输入到编码器中。这种设计一定程度上可以有效地缓解O(n2) 级别的计算复杂度的问题。
VideoMAE Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training概述的更多相关文章
- 论文解读(MGAE)《MGAE: Masked Autoencoders for Self-Supervised Learning on Graphs》
论文信息 论文标题:MGAE: Masked Autoencoders for Self-Supervised Learning on Graphs论文作者:Qiaoyu Tan, Ninghao L ...
- 数据量与半监督与监督学习 Data amount and semi-supervised and supervised learning
机器学习工程师最熟悉的设置之一是访问大量数据,但需要适度的资源来注释它.处于困境的每个人最终都会经历逻辑步骤,当他们拥有有限的监督数据时会问自己该做什么,但很多未标记的数据,以及文献似乎都有一个现成的 ...
- Microsoft: Get started with Dynamic Data Masking in SQL Server 2016 and Azure SQL
Dynamic Data Masking (DDM) is a new security feature in Microsoft SQL Server 2016 and Azure SQL DB. ...
- 论文翻译——Dynamic Pooling and Unfolding Recursive Autoencoders for Paraphrase Detection
Dynamic Pooling and Unfolding Recursive Autoencoders for Paraphrase Detection 动态池和展开递归自动编码器的意译检测 论文地 ...
- Lessons Learned from Developing a Data Product
Lessons Learned from Developing a Data Product For an assignment I was asked to develop a visual ‘da ...
- Oracle 10g Data Pump Expdp/Impdp 详解
Data Pump 介绍 在第一部分看了2段官网的说明, 可以看出数据泵的工作流程如下: (1)在命令行执行命令 (2)expdp/impd 命令调用DBMS_DATAPUMP PL/SQL包. 这个 ...
- Reducing the Dimensionality of Data with Neural Networks:神经网络用于降维
原文链接:http://www.ncbi.nlm.nih.gov/pubmed/16873662/ G. E. Hinton* and R. R. Salakhutdinov . Science. ...
- [Javascript] Classify JSON text data with machine learning in Natural
In this lesson, we will learn how to train a Naive Bayes classifier and a Logistic Regression classi ...
- [DE] How to learn Big Data
打开一瞧:50G的文件! emptystacks jobstacks jobtickets stackrequests worker 大数据加数据分析,需要以python+scikit,sql作为基础 ...
- Setting up the data and the model
Table of Contents: Setting up the data and the model Data Preprocessing Weight Initialization Batch ...
随机推荐
- [编程基础] Python数据生成库Faker总结
Python Faker教程展示了如何使用Faker软件包在Python中生成伪数据.我们使用joke2k/faker包. 1 介绍 Faker是一个生成假数据的Python库.伪数据通常用于测试或用 ...
- SICP:符号求导、集合表示和Huffman树(Python实现)
绪论 到目前为止,我们已经使用过的所有复合数据,最终都是从数值出发构造起来的(比如我们在上一篇博客<SICP 2.2: 层次性数据和闭包性质(Python实现)>所介绍的链表和树就基于数来 ...
- Java开发学习(五十)----MyBatisPlus快速开发之代码生成器解析
1.代码生成器原理分析 造句: 我们可以往空白内容进行填词造句,比如: 在比如: 观察我们之前写的代码,会发现其中也会有很多重复内容,比如: 那我们就想,如果我想做一个Book模块的开发,是不是只需要 ...
- 问一个 Windows 窗口的 Capture 问题
好久没写了,上来先问一个问题...羞射... 有 A.B 两个窗口,A 是 B 的 Owner,B 不激活不抢焦点.在 B 的 WM_LBUTTONDOWN 的时候,设置 A 窗口为 Capture: ...
- ABC193F Engines
简要题意 给出 \(n\) 个向量,求其子集的和的最大模长. \(1 \leq n \leq 100\) 思路 先说结论:选出的几个向量,一定是极角排序后的某一段(环形)区间. 这个不难感性理解,比如 ...
- LIS求解(包括优化)
首先,让我来看看LIS问题 Description 一个数的序列 bi,当 b1 < b2 < ... < bS 的时候,我们称这个序列是上升的.对于给定的一个序列(a1,a2,.. ...
- react系列-从0开始搭建一个react项目
从0开始搭建一个react项目 1.安装脚手架 npm install -g create-react-app 2.创建项目 D: //进入D盘 mkdir ReactDemo //创建ReactDe ...
- Unity之详解Texture
[Texture]详解什么是Texture 前言 开篇废话 嗨咯大家好呀,时隔多日,小黑又和大家见面咯,最近懒癌犯了,而且技术上边倍受打击,所以回了家只想着睡觉休息,所以希望大家见谅见谅啦. Unit ...
- C++迭代器种类与编译期间多态
迭代器分类 C++ STL 中根据移动能力将迭代器分成了 5 类: Input Iterator 输入迭代器,只支持 operator++ 操作. Output Iterator 输出迭代器,只支持 ...
- 淘宝数据采集之js采集
搜索页面采集,数据在控制台哦!!! 搜索页面采集,数据在控制台哦!!! 搜索页面采集,数据在控制台哦!!! 既然能打到控制台,当然也能传到系统!!! 既然能打到控制台,当然也能传到系统!!! 既然能打 ...