
数据量与半监督与监督学习 Data amount and semi-supervised and supervised learning
机器学习工程师最熟悉的设置之一是访问大量数据,但需要适度的资源来注释它。处于困境的每个人最终都会经历逻辑步骤,当他们拥有有限的监督数据时会问自己该做什么,但很多未标记的数据,以及文献似乎都有一个现成的答案:半监督学习。
这通常是出现问题的时候。
从历史上看,半监督学习一直是每个工程师作为一种通过仪式进行的兔子洞之一,只是为了发现对普通旧数据标签的新发现。细节对于每个问题都是独一无二的,但从广义上讲,它们通常可以描述如下:

在低数据制度中,半监督培训确实倾向于提高绩效。但在实际环境中,你经常会从“可怕且不可用”的性能水平变为“不太可怕但仍然完全无法使用”。从本质上讲,当你处于半监督学习实际上有帮助的数据体系时,这意味着你也处于一种你的分类器非常糟糕且没有实际用途的制度中。
此外,半监督通常不是免费的,并且使用半监督学习的方法通常不能为您提供监督学习在高数据制度中所做的相同渐近性质 - 未标记的数据可能会引入偏差, 例如。参见例如第4节。在深度学习的早期,一种非常流行的半监督学习方法是首先在未标记数据上学习自动编码器,然后对标记数据进行微调。几乎没有人这样做,因为通过自动编码学习的表示倾向于凭经验限制微调的渐近性能。有趣的是,即使是大大改进的现代生成方法也没有多大改善这种情况,可能是因为什么使得良好的生成模型不一定是什么使得良好的分类器。因此,当您看到工程师今天对模型进行微调时,通常从在监督数据上学习的表示开始 - 是的,我认为文本是用于语言建模目的的自我监督数据。在任何可行的情况下,从其他预训练模型转移学习是一个更加强大的起点,半监督方法难以超越。
因此,典型的机器学习工程师在半监督学习的沼泽中的旅程如下:
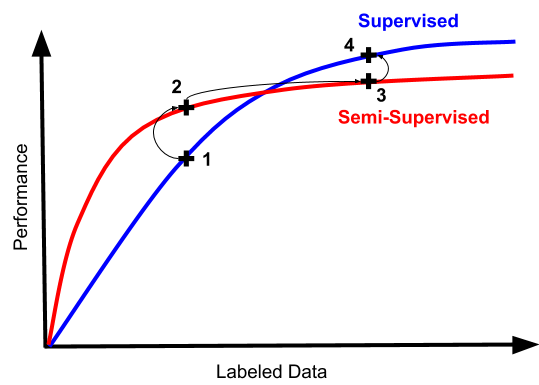
1:一切都很糟糕,让我们尝试半监督学习!(毕竟,这是工程工作,比标记数据更有趣......)
2:看,数字上升!但是仍然很可怕。看起来我们毕竟必须标记数据......
3:更多的数据更好,但是你有没有尝试过丢弃半监督机器会发生什么?
4:嘿,你知道什么,它实际上更简单,更好。我们可以通过完全跳过2和3来节省时间和大量技术债务。
如果您非常幸运,您的问题也可能具有这样的性能特征:
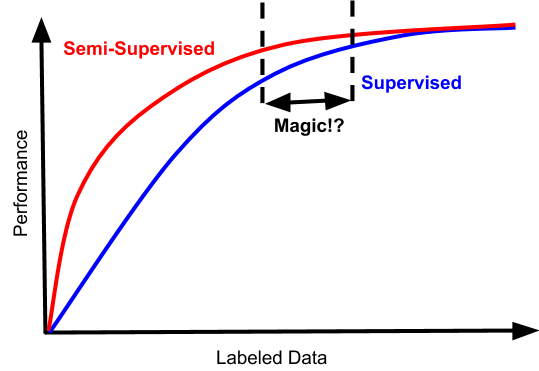
在这种情况下,存在一种狭窄的数据体系,其中半监督是不可怕的并且还提高了数据效率。根据我的经验,很难打到那个甜蜜点。考虑到额外复杂性的成本,标记数据量的差距通常不是更好的数量级,并且收益递减,这很少值得麻烦,除非你在学术基准上竞争。
但等等,这部题为“安静的半监督革命”的作品不是吗?
一个引人入胜的趋势是半监督学习的景观可能会变成看起来更像这样的东西:
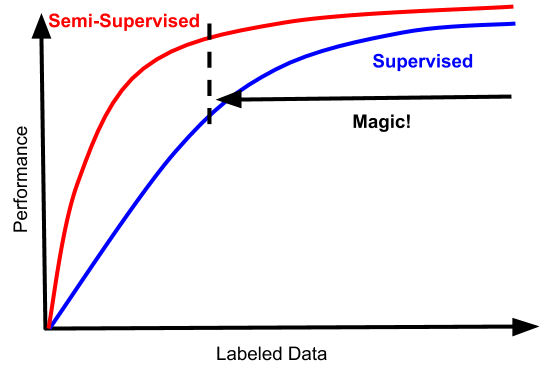
这会改变一切。首先,这些曲线与半监督方法应该做的心理模型相匹配:更多数据应该总是更好。即使对于监督学习表现良好的数据制度,半监督和监督之间的差距也应严格为正。并且越来越多地发生这种情况是免费的,而且额外的复杂性非常小。“魔术区”开始走低,同样重要的是,它不受高数据制度的束缚。
什么是新的?很多东西:许多聪明的方法来自我标记数据并以这样的方式表达损失,即它们与噪声和自我标记的潜在偏差兼容。最近的两部作品举例说明了最近的进展并指出了相关文献:MixMatch:半监督学习和无监督数据增强的整体方法。
半监督学习世界的另一个根本转变是认识到它可能在机器学习隐私中扮演非常重要的角色。例如,颈部的方法(半监督知识转移的深度学习从私人训练数据,可扩展的私学教育与PATE,)从而使监管数据被估计私人,并具有较强的私密性保证学生模型仅使用未标记的培训(假定公共)数据。用于提取知识的隐私敏感方法正在成为联邦学习的关键推动者之一,联合学习提供了有效的分布式学习的承诺,其不依赖于具有访问用户数据的模型,具有强大的数学隐私保证。
在实际环境中重新审视半监督学习的价值是一个激动人心的时刻。看到一个长期存在的假设受到挑战,这是该领域惊人进展的一个很好的指标。这种趋势都是最新的,我们必须看看这些方法是否经得起时间的考验,但是这些进步可能导致机器学习工具架构发生根本转变的可能性非常大。
数据量与半监督与监督学习 Data amount and semi-supervised and supervised learning的更多相关文章
- 斯坦福大学公开课机器学习:machine learning system design | data for machine learning(数据量很大时,学习算法表现比较好的原理)
下图为四种不同算法应用在不同大小数据量时的表现,可以看出,随着数据量的增大,算法的表现趋于接近.即不管多么糟糕的算法,数据量非常大的时候,算法表现也可以很好. 数据量很大时,学习算法表现比较好的原理: ...
- 学习笔记DL003:神经网络第二、三次浪潮,数据量、模型规模,精度、复杂度,对现实世界冲击
神经科学,依靠单一深度学习算法解决不同任务.视觉信号传送到听觉区域,大脑听学习处理区域学会“看”(Von Melchner et al., 2000).计算单元互相作用变智能.新认知机(Fukushi ...
- 达观数据CTO纪达麒:小标注数据量下自然语言处理实战经验
自然语言处理在文本信息抽取.自动审校.智能问答.情感分析等场景下都有非常多的实际应用需求,在人工智能领域里有极为广泛的应用场景.然而在实际工程应用中,最经常面临的挑战是我们往往很难有大量高质量的标注语 ...
- 小样本利器1.半监督一致性正则 Temporal Ensemble & Mean Teacher代码实现
这个系列我们用现实中经常碰到的小样本问题来串联半监督,文本对抗,文本增强等模型优化方案.小样本的核心在于如何在有限的标注样本上,最大化模型的泛化能力,让模型对unseen的样本拥有很好的预测效果.之前 ...
- OSVOS 半监督视频分割入门论文(中文翻译)
摘要: 本文解决了半监督视频目标分割的问题.给定第一帧的mask,将目标从视频背景中分离出来.本文提出OSVOS,基于FCN框架的,可以连续依次地将在IMAGENET上学到的信息转移到通用语义信息,实 ...
- Machine Learning分类:监督/无监督学习
从宏观方面,机器学习可以从不同角度来分类 是否在人类的干预/监督下训练.(supervised,unsupervised,semisupervised 以及 Reinforcement Learnin ...
- 详解使用EM算法的半监督学习方法应用于朴素贝叶斯文本分类
1.前言 对大量需要分类的文本数据进行标记是一项繁琐.耗时的任务,而真实世界中,如互联网上存在大量的未标注的数据,获取这些是容易和廉价的.在下面的内容中,我们介绍使用半监督学习和EM算法,充分结合大量 ...
- sql server 大数据, 统计分组查询,数据量比较大计算每秒钟执行数据执行次数
-- 数据量比较大的情况,统计十分钟内每秒钟执行次数 ); -- 开始时间 ); -- 结束时间 declare @num int; -- 结束时间 set @begintime = '2019-08 ...
- 半监督学习方法(Semi-supervised Learning)的分类
根据模型的训练策略划分: 直推式学习(Transductive Semi-supervised Learning) 无标记数据就是最终要用来测试的数据,学习的目的就是在这些数据上取得最佳泛化能力. 归 ...
随机推荐
- hadoop2.8 集群 1 (伪分布式搭建)
简介: 关于完整分布式请参考: hadoop2.8 ha 集群搭建 [七台机器的集群] Hadoop:(hadoop2.8) Hadoop是一个由Apache基金会所开发的分布式系统基础架构.用户 ...
- Linux实验:ssh免密码配置
[实验目的] 1)了解ssh工具的作用 2)熟悉ssh配置过程 3)理解ssh原理[实验原理] SSH是目前比较可靠的专为远程登录会话和其他网络服务提供安全的协议.不同主机之间 ...
- k8s 如何支持私有镜像
k8s如何支持私有镜像 实现无密钥编排 kubectl create secret docker-registry regsecret --docker-server=registry.cn-shen ...
- mysqldump 备份与恢复数据库
备份数据库 mysqldump -u root -plvtao test > /home/bak.sql 数据库还原,常用source 命令登陆 mysql -u root -p mysql&g ...
- 如何利用AI识别未知——加入未知类(不太靠谱),检测待识别数据和已知样本数据的匹配程度(例如使用CNN降维,再用knn类似距离来实现),将问题转化为特征搜索问题而非决策问题,使用HTM算法(记忆+模式匹配预测就是智能),GAN异常检测,RBF
https://www.researchgate.net/post/How_to_determine_unknown_class_using_neural_network 里面有讨论,说是用rbf神经 ...
- linux系统编程之信号(六)
今天继续学习信号相关的知识,主要还是学习sigqueue另外信号发送函数,并配合上节学习的sigaction的用法,进入正题: sigqueue函数: sigval联合体: 实际上sigval参数是用 ...
- vue-(过滤器,钩子函数,路由)
1.局部过滤器 在当前组件内部使用过滤器,修饰一些数据 //声明 filters:{ '过滤器的名字':function(val,a,b){ //a 就是alax ,val就是当前的数据 } } // ...
- P1311 选择客栈[模拟]
题目描述 丽江河边有nn家很有特色的客栈,客栈按照其位置顺序从 11到nn编号.每家客栈都按照某一种色调进行装饰(总共 kk 种,用整数 00 ~k-1k−1 表示),且每家客栈都设有一家咖啡店,每家 ...
- UVA1194 Machine Schedule[二分图最小点覆盖]
题意翻译 有两台机器 A,B 分别有 n,m 种模式. 现在有 k 个任务.对于每个任务 i ,给定两个整数$ a_i\(和\) b_i$,表示如果该任务在 A上执行,需要设置模式为 \(a_i\): ...
- Python语言程序设计(3)--实例2-python蟒蛇绘制-turtle库
1. 2. 3.了解turtle库 Turtle,也叫海龟渲染器,使用Turtle库画图也叫海龟作图.Turtle库是Python语言中一个很流行的绘制图像的函数库.海龟渲染器,和各种三维软件都有着良 ...