
Machine Learning 之二,什么监督性学习,非监督性学习。
1.什么是监督性学习?Supervised Machine Learning.
在监督性学习,我们给定一个数据集以及我们已经知道正确输出的结果,然后找到一个输入和输出的关系。
In Supervised learning,we are given a data set and already know what our correct output should look like ,having the idea that there is a relationship between the input and output.
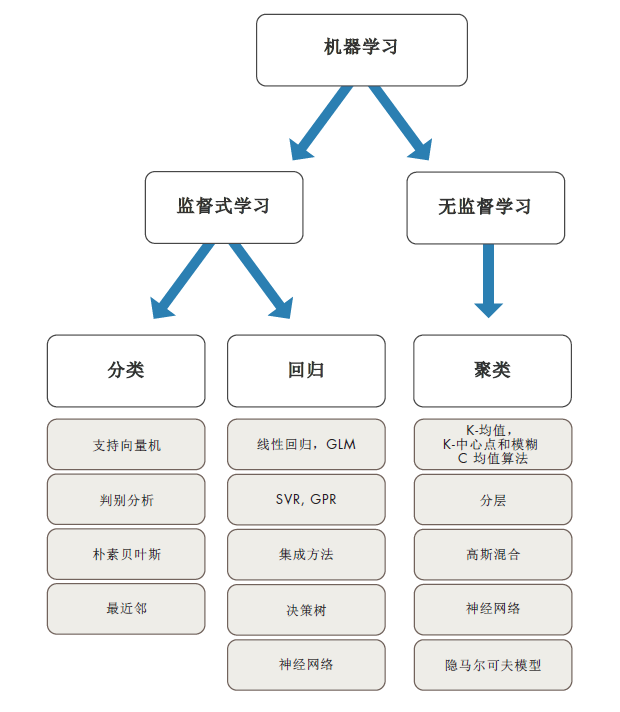
监督性学习的问题被分为两大类,第一类是回归问题,第二类是分类问题。在回归问题,我们试着预测结果在连续输出,意味着我们试图将输入变量映射到某个连续函数。在分类问题中,相反,我们试图预测离散输出的结果。换句话说,我们试图将输入变量映射到离散类别中。
监督性学习目的是在构建能够根据存在不确定性的证据做出预测的模型。监督性学习算法接受已知的输入数据集和对数据的已知响应输出,然后训练模型,让模型能够未新输入数据的响应生成合理的预测。
监督性学习采用分类(classification)和(regression)技术开发预测模型。
1.分类技术可预测离散的响应(输出)--例如:
电子邮件是真正的邮件还是垃圾邮件,肿瘤是恶性还是良性。分类模型可将输入数据划分不同类别。典型应用包括:医学成像,语音识别,信用评估。
2,回归技术可预测连续的响应--例如,电力需求中温度或波动的变化。
典型的应用包括:电力系统负荷预测和算法交易。
应用:
使用监督性学习预测心脏病发作
假设临床医生希望预测某位患者在一年内是否会心脏病发作,他们有一千就医患者的患者相关数据,包括年龄,体重,身高以及血压。他们呢hi到一千的患者在一年内是否出现过心脏病发作,因此,问题在于如何将现有数据合并到模型中,并让该模型能够预测新患者在一年内是否出现心脏病发作。
2. 什么是非监督性学习?UnSupervised Machine Learning.
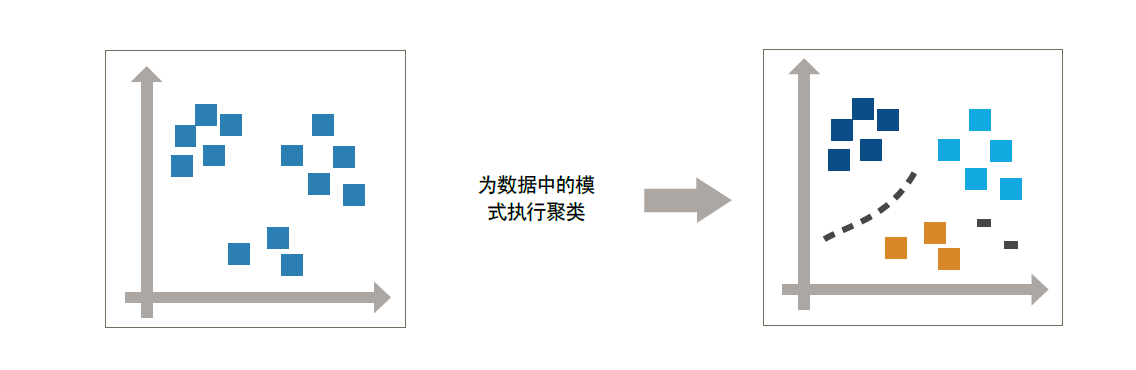
非监督性学习可发现数据中隐藏的模式或内在结构,这种技术可包含未标记响应的输入数据的数据集执行推理。
聚类是一种最常用的无监督性学习技术,这种技术可通过探索性数据分析发现数据中隐藏的模式或分组。
聚类的应用包括基因序列分析,市场调查和对象识别。
总结:
监督性机器学习就是根据已知的输入和输出训练模型,让模型能够预测未来输出。
非监督性机器学习就是从输入数据中找出隐藏模式或内在结构。

那么如何确定使用哪种算法?
选择正确的算法看似难以驾驭,需要从几十种监督性学习和非监督性学习算法中选择,每种算法又包含不同的学习方法。
没有最佳方法和完全之策。找到正确的算法知识是错过程的一部分,即使经验丰富的数据科学家,也无法说出某种算法是否无需试错即可使用,但是算法的选择还却决我们要处理数据的大小以及类型,要从数据中获取洞察力以及如何使用这些洞察力。这才是机器学习的开始。。
PS:
知识引用
吴恩达的机器学习
matlab的机器学习
Machine Learning 之二,什么监督性学习,非监督性学习。的更多相关文章
- 斯坦福大学公开课机器学习:machine learning system design | data for machine learning(数据量很大时,学习算法表现比较好的原理)
下图为四种不同算法应用在不同大小数据量时的表现,可以看出,随着数据量的增大,算法的表现趋于接近.即不管多么糟糕的算法,数据量非常大的时候,算法表现也可以很好. 数据量很大时,学习算法表现比较好的原理: ...
- 学习笔记之机器学习(Machine Learning)
机器学习 - 维基百科,自由的百科全书 https://zh.wikipedia.org/wiki/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0 机器学习是人工智能的一个分 ...
- 我的Machine Learning学习之路
从2016年年初,开始用python写一个简单的爬虫,帮我收集一些数据. 6月份,开始学习Machine Learning的相关知识. 9月开始学习Spark和Scala. 现在想,整理一下思路. 先 ...
- 【转载】 我的Machine Learning学习之路
原文地址: https://www.cnblogs.com/steven-yang/p/5857964.html ------------------------------------------- ...
- 【原】Coursera—Andrew Ng机器学习—课程笔记 Lecture 17—Large Scale Machine Learning 大规模机器学习
Lecture17 Large Scale Machine Learning大规模机器学习 17.1 大型数据集的学习 Learning With Large Datasets 如果有一个低方差的模型 ...
- data mining,machine learning,AI,data science,data science,business analytics
数据挖掘(data mining),机器学习(machine learning),和人工智能(AI)的区别是什么? 数据科学(data science)和商业分析(business analytics ...
- 数据挖掘(data mining),机器学习(machine learning),和人工智能(AI)的区别是什么? 数据科学(data science)和商业分析(business analytics)之间有什么关系?
本来我以为不需要解释这个问题的,到底数据挖掘(data mining),机器学习(machine learning),和人工智能(AI)有什么区别,但是前几天因为有个学弟问我,我想了想发现我竟然也回答 ...
- 【Machine Learning】监督学习、非监督学习及强化学习对比
Supervised Learning Unsupervised Learning Reinforced Learning Goal: How to apply these methods How t ...
- 机器学习(Machine Learning)&深度学习(Deep Learning)资料【转】
转自:机器学习(Machine Learning)&深度学习(Deep Learning)资料 <Brief History of Machine Learning> 介绍:这是一 ...
随机推荐
- k8s pod,pvc,pv无法删除问题
注意步骤: 一般删除步骤为:先删pod再删pvc最后删pv 但是遇到pv始终处于“Terminating”状态,而且delete不掉 pod一直删不掉 [root@hadoop01 nacos-k8s ...
- 集训队8月1日(拓扑排序+DFS+主席树入门)
上午看书总结 今天上午我看了拓扑排序,DFS+剪枝,相当于回顾了一下,写了三个比较好的例题.算法竞赛指南93~109页. 1.状态压缩+拓扑排序 https://www.cnblogs.com/246 ...
- Django2.0中得url路由path得用法
Django2.0中,url得匹配规则更新了,在django1.0中,url是用正则表达式书写得,相对来说比较繁琐一些,在django2.0中进行了升级优化,改为了path from django.u ...
- idea 使用github
[Toc] #一.首先下载github for window 客户端,或者git客户端 这里只演示gitHub客户端,安装git客户端的话,git.exe很容易找得到. 附上网址:https://de ...
- jq动画效果慢慢滚动到固定位置
function contentTop(top){ $('body,html').animate({ scrollTop: top }, 500 ); } 获取元素top传入即可 contentTop ...
- Tomcat负载均衡、调优核心应用进阶学习笔记(四):JVM调优
文章目录 概述 **JVM管理的内存段可分为两大类:线程共享内存和线程私有内存** Java Heap SIze Options The memory structure of a JVM proce ...
- docker内的服务无法获取用户真实IP
原文:blog.baohaipeng.top 背景:MySQL数据库和Redis运行在宿主机上(Linux),server运行在docker内,web运行在Nginx内(Nginx运行在docker内 ...
- Eureka 系列(03)Spring Cloud 自动装配原理
Eureka 系列(03)Spring Cloud 自动装配原理 [TOC] 0. Spring Cloud 系列目录 - Eureka 篇 本文主要是分析 Spring Cloud 是如何整合 Eu ...
- Linux NIO 系列(02) 阻塞式 IO
目录 一.环境准备 1.1 代码演示 二.Socket 是什么 2.1 socket 套接字 2.2 套接字描述符 2.3 文件描述符和文件指针的区别 三.基本的 SOCKET 接口函数 3.1 so ...
- 分布式ID生成器的解决方案总结
在互联网的业务系统中,涉及到各种各样的ID,如在支付系统中就会有支付ID.退款ID等.那一般生成ID都有哪些解决方案呢?特别是在复杂的分布式系统业务场景中,我们应该采用哪种适合自己的解决方案是十分重要 ...