
Are Loss Functions All the Same?
@article{rosasco2004are,
title={Are loss functions all the same},
author={Rosasco, Lorenzo and De Vito, Ernesto and Caponnetto, Andrea and Piana, Michele and Verri, Alessandro},
journal={Neural Computation},
volume={16},
number={5},
pages={1063--1076},
year={2004}}
概
作者给出了不同的损失函数, 在样本数量增多情况下的极限情况. 假设\(p(x,y)\)为\((x,y)\)的密度函数,其中\(x\in \mathbb{R}^d\)为输入样本, \(y\in \mathbb{R}\)为值(回归问题) 或 类别信息(分类问题). 设\(V(w,y),\)为损失函数, 则期望风险为:
I[f]=\int_Z V(f(x),y)p(x,y)\mathrm{d} x \mathrm{d}y,
\]
其中\(f\)为预测函数, 不妨设\(f_0\)最小化期望风险. 在实际中, 我们只有有限的样本\(D=\{(x_1,y_1),\ldots, (x_l,y_l)\}\), 在此情况下, 我们采取近似
I_{emp}[f]=\frac{1}{l}\sum_{i=1}^lV(f(x_i),y_i),
\]
同时
f_D=\arg\min_{f \in \mathcal{H}} I_{emp}[f].
\]
其中\(\mathcal{H}\)为hypothesis space.
\(f_D\)与\(f_0\)之间的差距如何, 是本文的核心.
主要内容
一些假设
首先\(f_D\)的在空间\(\mathcal{H}\)中寻找, Reproducing Kernel Hilbert Space(RKHS)一文中(没看)给出了这种空间的构造方式. 给定对称正定函数\(K(x,s)\)(Mercer核):
\]
同时\(K(\cdot, x)\)是连续函数.
函数\(f\)通过下述方式构造:
f(x) = \langle f, K(\cdot, x)\rangle_{\mathcal{H}}.
\]
给定常数\(R>0\), 构造hypothesis space \(\mathcal{H}_{R}\):
\]
则在\(\|\cdot\|_{\infty}\)下, \(\mathcal{H}_R\)是连续函数\(C(X)\)上的一个紧集,其中\(X\subset \mathbb{R}^d\)是紧的(这个证明要用到经典的Arela-Ascoli定理, 只需证明\(\mathcal{H}_R\)中的元素是等度连续即可).
另外:
\]
故
\]
其中\(C_K=\sup_{x \in X} \sqrt{K(x,x)}\).
损失函数\(V\)为凸函数且满足:
- \(V\)是Lipschitz函数, 即对于任意的\(M>0\), 存在常数\(L_M>0\)使得
\]
对于任意的\(w_1,w_2\in[-M,M],y\in Y\)成立.
2. 存在常数\(C_0\), \(\forall y\in Y\)
\]
成立.
注: 这里的凸函数, 因为一般的损失函数实际上是以\(w-y\)(回归), \(wy\)(分类)为变元, 所以要求\(V(t)\)关于\(t=w-y\)或者\(t=wy\)为凸函数.
损失函数
回归问题:

分类问题:
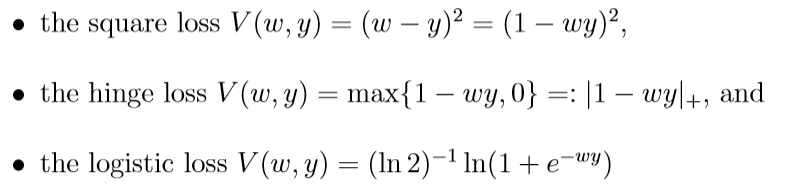
这些损失函数都是满足假设的, 所对应的\(L_M, C_0\), 当\(Y=[a, b], \delta=\max \{|a|, |b|\}\)时为

\(I[f_D]-I[f_R]\)
假设\(f_R=\arg\min_{f \in \mathcal{H}_R}I[f]\), 一般的误差
\]
第一项是我们所关注的, 称为估计误差, 第二项为逼近误差.
这里引入\(\mathcal{H}_R\)的covering number, \(N(\epsilon)\), 文中所指的应该是wiki中的external covering number.
下面是理论结果, 引理的证明用了Hoeffding不等式, 这个不了解, 感兴趣请回看原文.
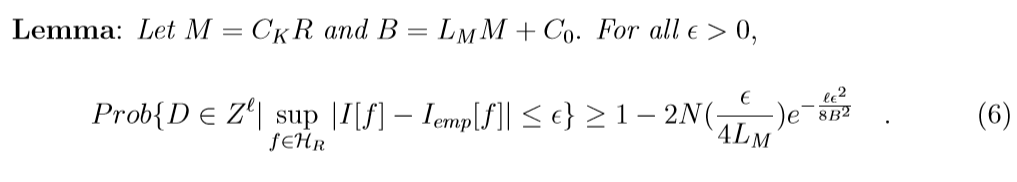

这里\(\epsilon(\eta, \ell, R)\)实际上(6)不等式右端第二项, 令其为\(\eta\), 反解\(\epsilon\)的意思.
第一个不等式实际上就是引理的推论, 第二个不等式注意到:
又\(I[f_D]\ge I[f_R]\)(这个说是根据定义, 但我没弄清楚), 故不等式成立.
损失函数的统计性质
收敛速度
考察不同损失的函数的\(\eta\):
回归问题:
\(abs / \epsilon-insensitive\):
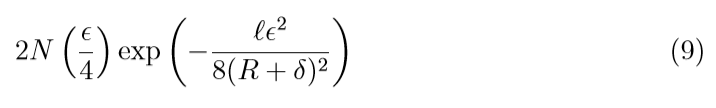
\(square\):
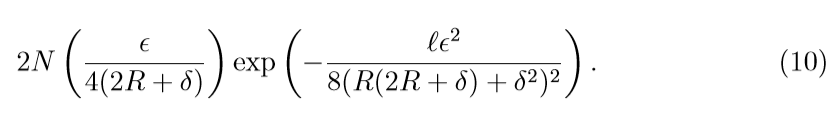
注意到, 因为square loss 的covering number 随着\(R, \delta\)的增加会变大, 所以\(\eta\)会变大,所以在收敛速度上, square比不上上面俩个.

分类问题:
hinge:
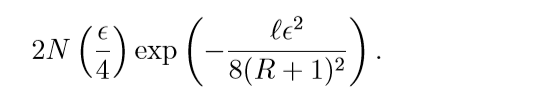
logistic:
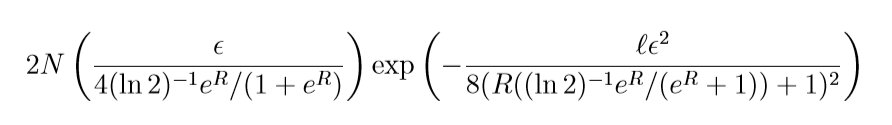
二者的收敛表现是类似的, 而square是类似的(\(\delta=1\)).
分类的界
关注分类问题中的hinge损失, 因为它会逼近概率推断.
在二元分类问题中, 其最佳函数\(f_b\)为:
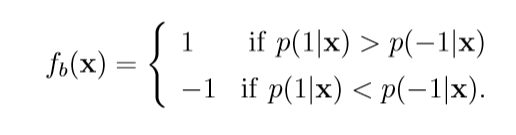
当\(p(1|x)\not= p(-1|x)\).
有如下事实:

证明蛮有趣的, 这里贴一下

\(p(1|x)<1/2\)的证明是类似的.
另外(证明在别的论文中):
\]
又(至少有\(1-\eta\)的概率)
\]
并注意到(感觉怪怪的):
\]
故至少有\(1-\eta\)的概率
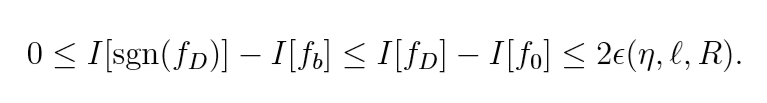
成立. 也就是说当样本个数\(\ell\)足够大的时候, \(sgn(f_D)\)的效用是等价于统计判别的, 这是hinge loss独有的优势.
Are Loss Functions All the Same?的更多相关文章
- 目标检测复习之Loss Functions 总结
Loss Functions 总结 损失函数分类: 回归损失函数(Regression loss), 分类损失函数(Classification loss) Regression loss funct ...
- cs231n spring 2017 lecture3 Loss Functions and Optimization 听课笔记
1. Loss function是用来量化评估当前预测的好坏,loss function越小表明预测越好. 几种典型的loss function: 1)Multiclass SVM loss:一般的S ...
- Basic Classifiers and Loss Functions
Linear Classifier and Hing Loss (or Multiclass SVM Loss) Linear Mapping (Score function) Linear Clas ...
- CS231n笔记 Lecture 3 Loss Functions and Optimization
这一讲总体上就是引入Loss Function的概念,以及让大家对优化有一个初步的认识,和其他课程里面说的内容大同小异. Loss function Multiclass svm loss multi ...
- cs231n spring 2017 lecture3 Loss Functions and Optimization
1. Loss function是用来量化评估当前预测的好坏,loss function越小表明预测越好. 几种典型的loss function: 1)Multiclass SVM loss:一般的S ...
- 惩罚因子(penalty term)与损失函数(loss function)
penalty term 和 loss function 看起来很相似,但其实二者完全不同. 惩罚因子: penalty term的作用是把受限优化问题转化为非受限优化问题. 比如我们要优化: min ...
- 损失函数(loss function) 转
原文:http://luowei828.blog.163.com/blog/static/310312042013101401524824 通常而言,损失函数由损失项(loss term)和正则项(r ...
- [machine learning] Loss Function view
[machine learning] Loss Function view 有关Loss Function(LF),只想说,终于写了 一.Loss Function 什么是Loss Function? ...
- 损失函数(loss function)
通常而言,损失函数由损失项(loss term)和正则项(regularization term)组成.发现一份不错的介绍资料: http://www.ics.uci.edu/~dramanan/te ...
随机推荐
- Linux学习 - 文件特殊权限
一.SUID权限(只针对文件) 只有可执行的二进制程序才能设定SUID权限 命令执行者要对该程序拥有x(执行)权限 1 拥有SUID的文件 /usr/bin/passwd 2 功能: 命令执行者(其他 ...
- 【Linux】【Services】【Cache】使用Sentinel搭建高可用Redis
1. 简介 1.1. 一些基础概念请参考 http://www.cnblogs.com/demonzk/p/7453494.html 1.2. 几种常用的集群方式. -- Redis Sentinel ...
- 30个类手写Spring核心原理之Ioc顶层架构设计(2)
本文节选自<Spring 5核心原理> 1 Annotation(自定义配置)模块 Annotation的代码实现我们还是沿用Mini版本的,保持不变,复制过来便可. 1.1 @GPSer ...
- vue cli3.0 首次加载优化
项目经理要求做首页加载优化,打包后从十几兆优化到两兆多,记下来怕下次忘记 运行report脚本 可看到都加载了那些内容,在从dist文件中index.html 查看首次加载都加载了那些东西,如下图:然 ...
- [笔记] encoder-decoder NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE
原文地址 :[1409.0473] Neural Machine Translation by Jointly Learning to Align and Translate (arxiv.org) ...
- CF275A Lights Out 题解
Content 有一个 \(3\times 3\) 的矩阵.一开始每个元素都为 \(1\). 你可以对任意的位置进行操作,每次操作将在这个位置上的元素及其上下左右的元素全部由 \(1\) 改为 \(0 ...
- CF977B Two-gram 题解
Content 给定一个字符串 \(s\),请求出出现次数最多的长度为 \(2\) 的子串. 数据范围:\(2\leqslant |s|\leqslant 100\). Solution 直接求出所有 ...
- 当PowerDesigner的工具栏不见时候该怎么调出来
当PowerDesigner的工具栏不见时候该怎么调出来,如下所示:选中[Palette]便可
- JuiceFS 数据加密原理
JuiceFS 作为分布文件系统,每天与海量的数据打着交道,因此数据的安全性尤为关键,今天就来介绍一下 JuiceFS 在数据加密方面所做的努力. 传输中数据加密 JuiceFS 在网络上传输时会对数 ...
- ☕【Java实战系列】「技术盲区」Double与Float的坑与解决办法以及BigDecimal的取而代之!
探究背景 涉及诸如float或者double这两种浮点型数据的处理时,偶尔总会有一些怪怪的现象,不知道大家注意过没,举几个常见的栗子: 条件判断超预期 System.out.println( 1f = ...