
Hive入门(三)分桶
1 什么是分桶
上一篇说到了分区,分区中的数据可以被进一步拆分成桶,bucket。不同于分区对列直接进行拆分,桶往往使用列的哈希值进行数据采样。在分区数量过于庞大以至于可能导致文件系统崩溃时,建议使用桶。
hive使用对分桶所用的值进行hash,并用hash结果除以桶的个数做取余运算的方式来分桶,保证了每个桶中都有数据,但每个桶中的数据条数不一定相等。
2 如何分桶
首先,在建立桶之前,需要设置hive.enforce.bucketing属性为true,使得hive能识别桶。
然后,创建带有桶的表:
CREATE TABLE bucketed_user(

id INT,

name String

)

CLUSTERED BY (id) INTO 5 BUCKETS;
向桶中插入数据,这里按照用户id分成了5个桶
此时查看文件系统中的目录结构如下:
/usr/hive/warehouse/bucketed_user/000000_0
/usr/hive/warehouse/bucketed_user/000001_0
/usr/hive/warehouse/bucketed_user/000002_0
/usr/hive/warehouse/bucketed_user/000003_0
/usr/hive/warehouse/bucketed_user/000004_0
5个桶就是将数据表存储分为5个文件存储
注:cluster by不会影响数据的导入,这意味着,用户必须自己负责数据如何导入,包括数据的分桶和排序。
3 分区与分桶比较
- 桶的数量是固定的;
- 分区可以再分子区,桶不行;
- 分区或表组织成桶,Hive在处理有些查询时能利用桶的结构,获得更高的查询处理效率
- 分桶使取样(sampling)更高效
- 物理存储方式不同
如下图,分区又分桶和只分桶的图:
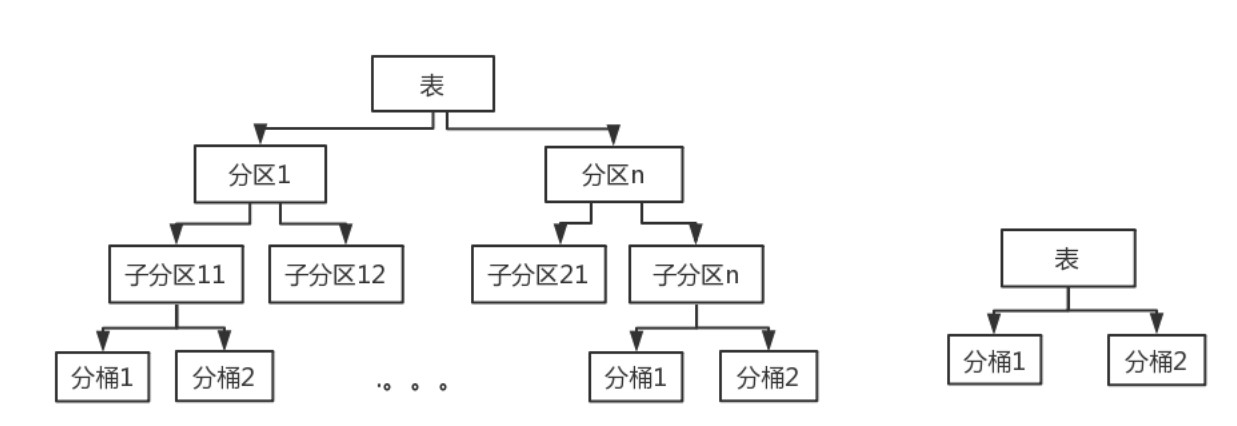
注:
抽样语法:TABLESAMPLE(BUCKET x OUT OF y)
y必须是table总bucket数的倍数或者因子。hive根据y的大小,决定抽样的比例。例如,table总共分了64份,当y=32时,抽取(64/32=)2个bucket的数据,当y=128时,抽取(64/128=)1/2个bucket的数据。x表示从哪个bucket开始抽取。例如,table总bucket数为32,tablesample(bucket 3 out of 16),表示总共抽取(32/16=)2个bucket的数据,分别为第3个bucket和第(3+16=)19个bucket的数据。
Hive入门(三)分桶的更多相关文章
- 入门大数据---Hive分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- Hive 学习之路(五)—— Hive 分区表和分桶表
一.分区表 1.1 概念 Hive中的表对应为HDFS上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为HDFS上表目录的子目录,数据按照分区存储在子目录中.如 ...
- Hive 系列(五)—— Hive 分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- hive -- 分区,分桶(创建,修改,删除)
hive -- 分区,分桶(创建,修改,删除) 分区: 静态创建分区: 1. 数据: john doe 10000.0 mary smith 8000.0 todd jones 7000.0 boss ...
- Hive为什么要分桶
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分.Hive也是针对某一列进行桶的组织.Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记 ...
- hive 分区表和分桶表
1.创建分区表 hive> create table weather_list(year int,data int) partitioned by (createtime string,area ...
- Hive学习笔记——Hive中的分桶
对于每一个表(table)或者分区, Hive可以进一步组织成桶,也就是说桶是更为细粒度的数据范围划分.Hive也是针对某一列进行桶的组织.Hive采用对列值哈希,然后除以桶的个数求余的方式决定该条记 ...
- Hive分区表与分桶
分区表 在Hive Select查询中.通常会扫描整个表内容,会消耗非常多时间做不是必需的工作. 分区表指的是在创建表时,指定partition的分区空间. 分区语法 create table tab ...
- hive中的分桶表
桶表也是一种用于优化查询而设计的表类型.创建通表时,指定桶的个数.分桶的依据字段,hive就可以自动将数据分桶存储.查询时只需要遍历一个桶里的数据,或者遍历部分桶,这样就提高了查询效率 ------创 ...
- 第2节 hive基本操作:11、hive当中的分桶表以及修改表删除表数据加载数据导出等
分桶表 将数据按照指定的字段进行分成多个桶中去,说白了就是将数据按照字段进行划分,可以将数据按照字段划分到多个文件当中去 开启hive的桶表功能 set hive.enforce.bucketing= ...
随机推荐
- python短信轰炸机版本smsbomb----------部分(post)
用一些用手机号注冊且须要发送验证码的站点的漏洞.能够向不论什么人的手机号发送短信,当然短信内容,我们无法控制.所以主要工作还是寻找这种站点.然后利用Fiddler或者HttpWatch分析请求.使用p ...
- ListView、TreeView和DataGrid。
原文:ListView.TreeView和DataGrid. 1.ListView. ListView继承自简单的没有特色的ListBox,并使用View属性进行扩展.增加了对基于列显示的支持,并增加 ...
- Windows PowerShell 集成脚本环境 (ISE)
应用场景 有时会遇到一些这样的报错 Exception calling "SetData" with "2" argument(s): "Type ' ...
- Stream转Byte数组
//获得当前文件目录 string rootPath = Directory.GetCurrentDirectory(); string path = rootPath + "Your Fi ...
- XF 导航页面
using System; using Xamarin.Forms; using Xamarin.Forms.Xaml; [assembly: XamlCompilation (XamlCompila ...
- 从PRISM开始学WPF(八)导航Navigation?
原文:从PRISM开始学WPF(八)导航Navigation? 0x6Navigation Basic Navigation Prism中的Navigation提供了一种类似导航的功能,他可以根据用户 ...
- C# Excel导入Access
/// <summary> /// 导入 /// </summary> private void btn_In_Click(object sender, EventArgs e ...
- 利用ZoomPipeline迅速实现基于线程池的全异步TCP点对点代理
在博文<一种基于Qt的可伸缩的全异步C/S架构服务器实现>中提到的高度模块化的类可以进行任意拆解,实现非常灵活的功能.今天,我们来看一看一个公司局域网访问英特网云服务器的点对点代理例子.代 ...
- Attention is all you need及其在TTS中的应用Close to Human Quality TTS with Transformer和BERT
论文地址:Attention is you need 序列编码 深度学习做NLP的方法,基本都是先将句子分词,然后每个词转化为对应的的词向量序列,每个句子都对应的是一个矩阵\(X=(x_1,x_2,. ...
- Bigtable:结构化数据的分布式存储系统
Bigtable最初是谷歌设计用来存储大规模结构化数据的分布式系统,其可以在数以千计的商用服务器上存储高达PB级别的数据量.开源社区根据Bigtable的设计思路开发了HBase.其优势在于提供了高效 ...