
scrapy爬虫案例:问政平台
问政平台
http://wz.sun0769.com/index.php/question/questionType?type=4
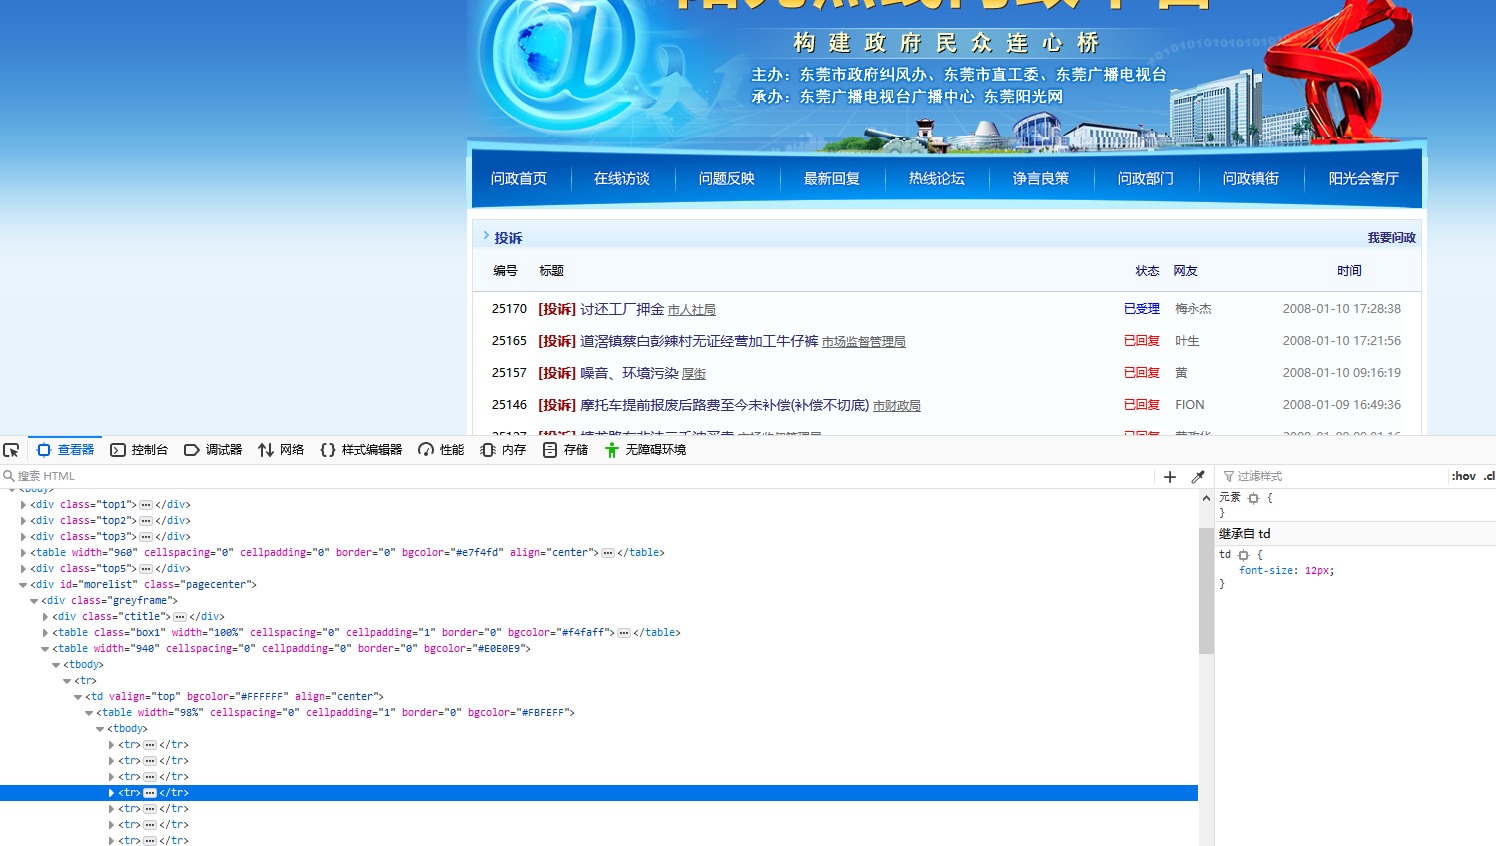
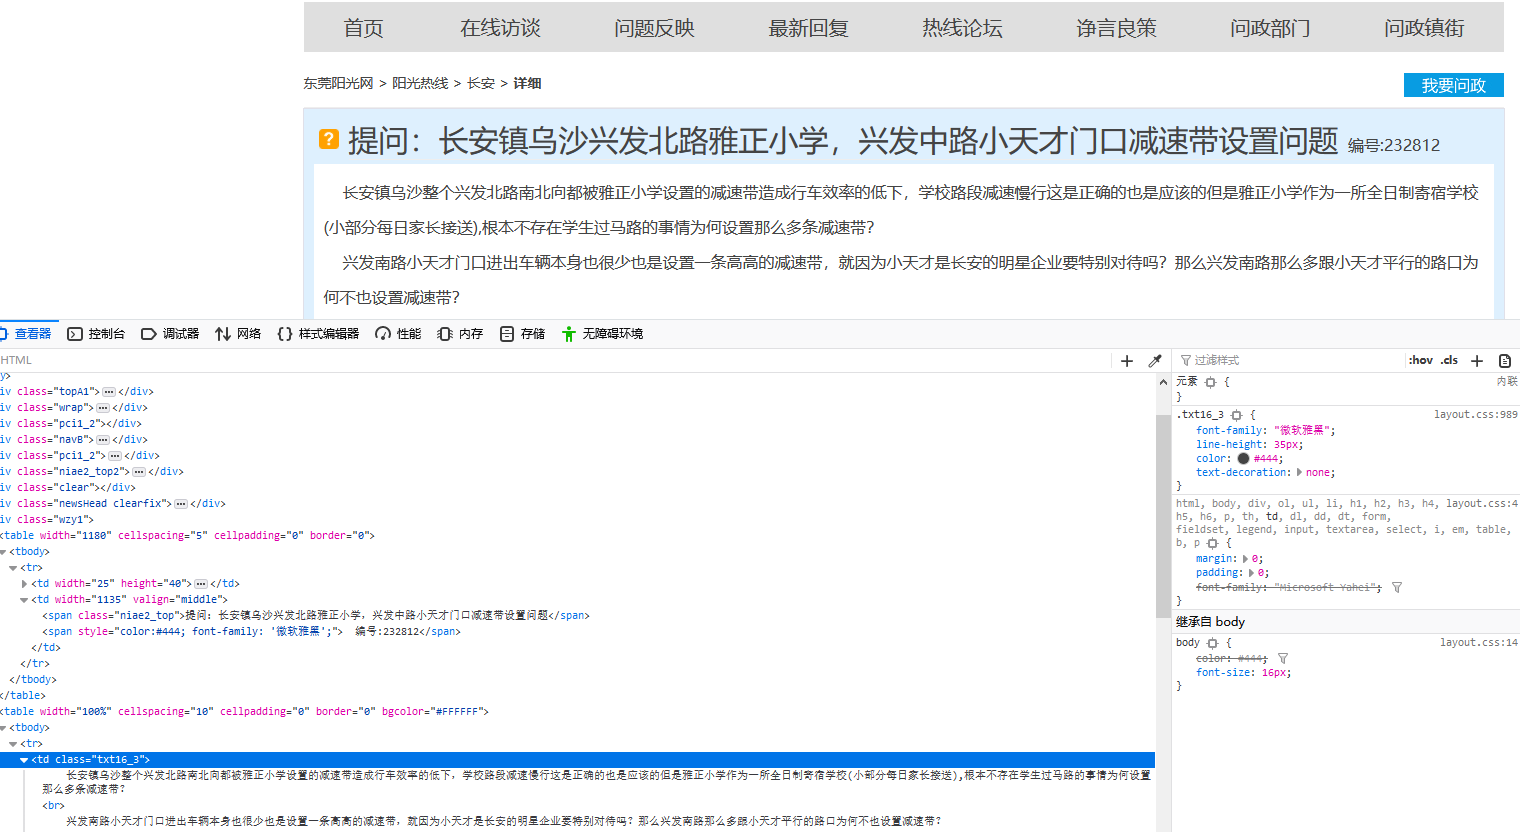
爬取投诉帖子的编号、帖子的url、帖子的标题,和帖子里的内容。
items.py
import scrapy

class DongguanItem(scrapy.Item):

    # 每个帖子的标题

    title = scrapy.Field()

    # 每个帖子的编号

    number = scrapy.Field()

    # 每个帖子的文字内容

    content = scrapy.Field()

    # 每个帖子的url

    url = scrapy.Field()
spiders/sunwz.py
# -*- coding: utf-8 -*-

import scrapy

from scrapy.spiders import CrawlSpider

from scrapyDemo.items import DongguanItem

class SunSpider(CrawlSpider):

    name = 'sun'

    allowed_domains = ['wz.sun0769.com']

    url = 'http://wz.sun0769.com/index.php/question/questionType?type=4&page='

    offset = 0

    start_urls = [url + str(offset)]

    def parse(self, response):

        # 取出每个页面里帖子链接列表

        links = response.xpath("//div[@class='greyframe']/table//td/a[@class='news14']/@href").extract()

        # 迭代发送每个帖子的请求,调用parse_item方法处理

        for link in links:

            yield scrapy.Request(link, callback=self.parse_item)

        # 设置页码终止条件,并且每次发送新的页面请求调用parse方法处理

        if self.offset <= 3876:

            self.offset += 30

            yield scrapy.Request(self.url + str(self.offset), callback=self.parse)

    # 处理每个帖子里

    def parse_item(self, response):

        item = DongguanItem()

        # 标题

        item['title'] = response.xpath('//span[contains(@class, "niae2_top")]/text()').extract()[0]
     # 编号

        item['number'] = response.xpath('//div[contains(@class, "wzy1")]//td//span/text()').extract()[1]

        # 文字内容,默认先取出有图片情况下的文字内容列表

        content = response.xpath('//td[@class="txt16_3"]/text()').extract()

        # 如果没有内容,则取出没有图片情况下的文字内容列表

        if len(content) == 0:

            content = response.xpath('//div[@class="c1 text14_2"]/text()').extract()

            # content为列表,通过join方法拼接为字符串,并去除首尾空格

            item['content'] = "".join(content).strip()

        else:

            item['content'] = "".join(content).strip()

        # 链接

        item['url'] = response.url

        yield item
pipelines.py
# -*- coding: utf-8 -*-

# 文件处理类库,可以指定编码格式

import codecs

import json

class DongguanPipeline(object):

    def __init__(self):

        # 创建一个只写文件,指定文本编码格式为utf-8

        self.filename = codecs.open('sunwz.json', 'w', encoding='utf-8')

    def process_item(self, item, spider):

        content = json.dumps(dict(item), ensure_ascii=False) + "\n"

        self.filename.write(content)

        return item

    def spider_closed(self, spider):

        self.file.close()
settings.py
ITEM_PIPELINES = {

    'dongguan.pipelines.DongguanPipeline': 300,

}

# 日志文件名和处理等级

LOG_FILE = "dg.log"

LOG_LEVEL = "DEBUG"
在项目根目录下新建main.py文件,用于调试
from scrapy import cmdline

cmdline.execute('scrapy crawl sunwz'.split())
执行程序
py2 main.py
效果:

scrapy爬虫案例:问政平台的更多相关文章
- scrapy爬虫案例--爬取阳关热线问政平台
阳光热线问政平台:http://wz.sun0769.com/political/index/politicsNewest?id=1&page=1 爬取最新问政帖子的编号.投诉标题.投诉内容以 ...
- Scrapy爬虫案例 | 数据存储至MySQL
首先,MySQL创建好数据库和表 然后编写各个模块 item.py import scrapy class JianliItem(scrapy.Item): name = scrapy.Field() ...
- Scrapy爬虫案例 | 数据存储至MongoDB
豆瓣电影TOP 250网址 要求: 1.爬取豆瓣top 250电影名字.演员列表.评分和简介 2.设置随机UserAgent和Proxy 3.爬取到的数据保存到MongoDB数据库 items.py ...
- scrapy爬虫案例:用MongoDB保存数据
用Pymongo保存数据 爬取豆瓣电影top250movie.douban.com/top250的电影数据,并保存在MongoDB中. items.py class DoubanspiderItem( ...
- 爬虫——Scrapy框架案例二:阳光问政平台
阳光热线问政平台 URL地址:http://wz.sun0769.com/index.php/question/questionType?type=4&page= 爬取字段:帖子的编号.投诉类 ...
- Scrapy项目_阳光热线问政平台
目的: 爬取阳光热线问政平台问题中每个帖子的标题.详情URL.详情内容.图片以及发布时间 步骤: 1.创建爬虫项目 1 scrapy startproject yangguang 2 cd yangg ...
- 如何让你的scrapy爬虫不再被ban之二(利用第三方平台crawlera做scrapy爬虫防屏蔽)
我们在做scrapy爬虫的时候,爬虫经常被ban是常态.然而前面的文章如何让你的scrapy爬虫不再被ban,介绍了scrapy爬虫防屏蔽的各种策略组合.前面采用的是禁用cookies.动态设置use ...
- 爬虫框架Scrapy之案例一
阳光热线问政平台 http://wz.sun0769.com/index.php/question/questionType?type=4 爬取投诉帖子的编号.帖子的url.帖子的标题,和帖子里的内容 ...
- Scrapy爬虫及案例剖析
由于互联网的极速发展,所有现在的信息处于大量堆积的状态,我们既要向外界获取大量数据,又要在大量数据中过滤无用的数据.针对我们有益的数据需要我们进行指定抓取,从而出现了现在的爬虫技术,通过爬虫技术我们可 ...
随机推荐
- LINUX基础学习之基础命令(2)--2019-11-18
1.ls :命令(list):列出指定目录下的内容 用法:ls [选项] [文件名...] [root@Redhat-7-43 ~]# which ls alias ls='ls --color=a ...
- Linux(Redhat)传送门汇总
Linux(Redhat)传送门汇总 linux 环境布置 常用命令与shell 常用命令 shell 环境布置 Linux虚拟机安装(rhel 7.4) 虚拟机网络设置 VMware虚拟机开机启动 ...
- Linux的sz和rz命令
工作中需要在Linux和Windows之间传输文件时,一般使用winscp或者ftp工具来完成,最近才知道有sz和rz这两个命令,方便好用. sz 下载 从Linux下载文件到本机 , 在Linux ...
- 项目Beta冲刺随笔集合
班级:软件工程1916|W 作业:项目Beta冲刺 团队名称:SkyReach 目标:完成项目Beta版本 项目Github地址 评审表 团队博客汇总 队员学号 队员姓名 个人博客地址 备注 2216 ...
- 关于background-image设置背景图片
每天进步一小步,一年进步一大步. 本篇主要介绍背景图片设置,平铺,x y方向上的平铺,是否重复显示no repeat 显示的初始位置 background-image:url(images/inde ...
- 32、MySQL简介
一.MySQL简介 1.数据库管理软件分类 主要分为关系型和非关系型. 可以简单的理解为,关系型数据库需要有表结构,非关系型数据库是key-value存储的,没有表结构. 关系型:如sqllite,d ...
- web前端如何性能优化提高加载速度
前端优化有以下几种途径: 一.减少HTTP请求数量和次数: 二.使用CDN: 三.添加Expires头: 四.压缩组件: 五.将样式表放在头部: 六.将脚本放在底部: 七.避免CSS表达式: 八.使用 ...
- springcloud_Hystrix(熔断器)
为什么需要 Hystrix? 在微服务架构中,我们将业务拆分成一个个的服务,服务与服务之间可以相互调用(RPC).为了保证其高可用,单个服务又必须集群部署.由于网络原因或者自身的原因,服务并不能保证服 ...
- 第09组 Alpha冲刺(1/6)
队名:观光队 组长博客 作业博客 组员实践情况 王耀鑫 过去两天完成了哪些任务 文字/口头描述 完成服务器连接数据库部分代码 展示GitHub当日代码/文档签入记录 接下来的计划 与服务器连接,配合前 ...
- shell中脚本参数传递getopts
while getopts ":a:b:c:" opt do case $opt in a) echo "参数a的值$OPTARG" ;; b) echo &q ...