
实现logstash6.4.3 同步mysql数据到Elasticsearch6.4.3
本文旨在实践把mysql已有的数据同步到elasticsearch中,使用的版本是6.4.3,对于其它6.x版本理应是一样的处理方式。
本文目录:
本文3.2节所用到的jdbc连接mysql数据库相关的配置文件、jar包打包下载地址:点我去下载
用到的mysql-jdbc版本是:mysql-connector-java-8.0.13
mysql-server数据库版本是5.7
1.初始化Elasticsearch 6.4.3
1.1 下载Elasticsearch 6.4.3
这里使用最新的6.4.3版本,只是做一个实践,稳定性还不清楚,不建议在生产环境直接使用最新版。
下载地址:https://www.elastic.co/downloads/elasticsearch
1.2 配置Elasticsearch 6.4.3
这里用单机搭建三个节点模拟集群(生产环境还是一机一节点,不要省,数据安全最重要):
解压elasticsearch-6.4.3.zip,并额外拷贝两份,三个目录分别命名为elasticsearch-6.4.3-node1、elasticsearch-6.4.3-node2、elasticsearch-6.4.3-node3模拟三个节点。然后分别修改解压目录里面config/elasticsearch.yml配置如下:
node1配置:
# ---------------------------------- Cluster -----------------------------------

#

# Use a descriptive name for your cluster:

#

cluster.name: es

#

# ------------------------------------ Node ------------------------------------

#

# Use a descriptive name for the node:

#

node.name: node-1

#

# ---------------------------------- Network -----------------------------------

#

# Set the bind address to a specific IP (IPv4 or IPv6):

#

network.host: 192.168.1.222

#

# Set a custom port for HTTP:

#

http.port: 9210

transport.tcp.port: 9310

#

# For more information, consult the network module documentation.

#

# --------------------------------- Discovery ----------------------------------

#

# Pass an initial list of hosts to perform discovery when new node is started:

# The default list of hosts is ["127.0.0.1", "[::1]"]

#

discovery.zen.ping.unicast.hosts: ["192.168.1.222:9310", "192.168.1.222:9311", "192.168.1.222:9312"]

#

# Prevent the "split brain" by configuring the majority of nodes (total number of master-eligible nodes / 2 + 1):

discovery.zen.minimum_master_nodes: 2

# ---------------------------------- Various -----------------------------------

#

# Require explicit names when deleting indices:

#

action.destructive_requires_name: true
node2配置跟上面差不多,不一样的是node节点名、http端口以及transport.tcp的端口
node2配置:
# ---------------------------------- Cluster -----------------------------------

#

# Use a descriptive name for your cluster:

#

cluster.name: es

#

# ------------------------------------ Node ------------------------------------

#

# Use a descriptive name for the node:

#

node.name: node-2

# ---------------------------------- Network -----------------------------------

#

# Set the bind address to a specific IP (IPv4 or IPv6):

#

network.host: 192.168.1.222

#

# Set a custom port for HTTP:

#

http.port: 9211

transport.tcp.port: 9311

#

# For more information, consult the network module documentation.

#

# --------------------------------- Discovery ----------------------------------

#

# Pass an initial list of hosts to perform discovery when new node is started:

# The default list of hosts is ["127.0.0.1", "[::1]"]

#

discovery.zen.ping.unicast.hosts: ["192.168.1.222:9310", "192.168.1.222:9311", "192.168.1.222:9312"]

#

# Prevent the "split brain" by configuring the majority of nodes (total number of master-eligible nodes / 2 + 1):

discovery.zen.minimum_master_nodes: 2

# ---------------------------------- Various -----------------------------------

#

# Require explicit names when deleting indices:

#

action.destructive_requires_name: true
node3配置:
# ---------------------------------- Cluster -----------------------------------

#

# Use a descriptive name for your cluster:

#

cluster.name: es

#

# ------------------------------------ Node ------------------------------------

#

# Use a descriptive name for the node:

#

node.name: node-3

# ---------------------------------- Network -----------------------------------

#

# Set the bind address to a specific IP (IPv4 or IPv6):

#

network.host: 192.168.1.222

#

# Set a custom port for HTTP:

#

http.port: 9212

transport.tcp.port: 9312

#

# For more information, consult the network module documentation.

#

# --------------------------------- Discovery ----------------------------------

#

# Pass an initial list of hosts to perform discovery when new node is started:

# The default list of hosts is ["127.0.0.1", "[::1]"]

#

discovery.zen.ping.unicast.hosts: ["192.168.1.222:9310", "192.168.1.222:9311", "192.168.1.222:9312"]

#

# Prevent the "split brain" by configuring the majority of nodes (total number of master-eligible nodes / 2 + 1):

discovery.zen.minimum_master_nodes: 2

# ---------------------------------- Various -----------------------------------

#

# Require explicit names when deleting indices:

#

action.destructive_requires_name: true
然后分别进入bin目录执行elasticsearch.bat启动相应的节点服务。
2.初始化kibana-6.4.3
2.1. 下载
kibana 6.4.3版本下载地址:https://www.elastic.co/downloads/kibana
下载zip版后解压
2.2. 配置
修改解压目录的config文件夹里面的kibana.yml配置文件,配置elasticsearch的url地址(其它的配置项根据需要自行修改):
# Kibana is served by a back end server. This setting specifies the port to use.

server.port: 5601

# 配置elasticsearch的地址

elasticsearch.url: "http://192.168.1.222:9210"
2.3. 启动
进入bin目录,执行kibana.bat 批处理文件启动kibana,
我们在左侧的Dev Tools开发工具输入查询集群状态的命令:GET /_cluster/state
可以看到集群的三个节点都正常运行中。

3.初始化logstash 6.4.3
3.1 下载logstash 6.4.3
logstash 6.4.3下载地址:https://www.elastic.co/downloads/logstash
解压下载后的zip文件
3.2 配置logstash
- 1.解压logstash-6.4.3
- 2.修改logstash-6.4.3目录下的Gemfile文件,将source由默认的
"https://rubygems.org"改为:"https://gems.ruby-china.com"- 3.进入logstash-6.4.3的bin目录,执行
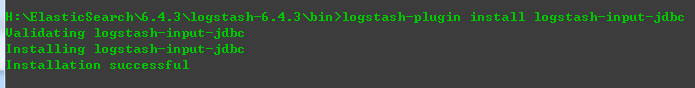
logstash-plugin install logstash-input-jdbc
出现如下信息表示安装成功。
- 4.在
bin目录新建mysql文件夹,把mysql-connector-java-8.0.13.jar放到此文件夹- 5.在
mysql文件夹新建文件:jdbc.sql,输入以下内容并保存:select * from news
要注意:这里的内容就是logstash依赖执行的sql命令,所以这里的表名要跟你实际的数据库表名一致,否则会失败- 6.修改
logstash文件夹下config\logstash.conf文件,*(如果不存在,创建一个文件,文件编码为UTF-8)*改成如下配置(jdbc的url需要带时区信息,否则同步会出错,无法读取数据):
注意:以下配置内容,数据库连接相关的内容如数据库名字、用户名密码等需要修改为你当前环境相应的内容
input {

    stdin {

    }

    jdbc {

      # mysql jdbc connection 连接地址

      jdbc_connection_string => "jdbc:mysql://192.168.1.212:3306/my_db?serverTimezone=Asia/Shanghai&useSSL=true&useUnicode=true&characterEncoding=UTF-8"

      # 登录数据库的用户名、密码

      jdbc_user => "root"

      jdbc_password => "123456"

      # jdbc 驱动包路径(我们在步骤4处理的内容)

      jdbc_driver_library => "mysql\mysql-connector-java-8.0.13.jar"

      # 连接驱动类名

      jdbc_driver_class => "com.mysql.cj.jdbc.Driver"

      jdbc_paging_enabled => "true"

      jdbc_page_size => "50000"

      statement_filepath => "mysql\jdbc.sql"

      # 以下表示定时执行任务,使用cron表达式,本文只全量同步一次,所以不配置定时器,如果要实现增量更新,需要配合定时器以及上次查询的最后一个值,具体要根据你的业务来定。

      #schedule => "* * * * *"

      type => "jdbc"

    }

}

filter {

    json {

        source => "message"

        remove_field => ["message"]

    }

}

output {

    elasticsearch {

        hosts => ["192.168.1.212:9210"]

        index => "mynews"

        document_id => "%{id}"

    }

    stdout {

        codec => json_lines

    }

}
- 7.进入bin目录,执行如下命令
logstash.bat -f ../config/logstash.conf
出现如下界面表示成功在同步数据了:
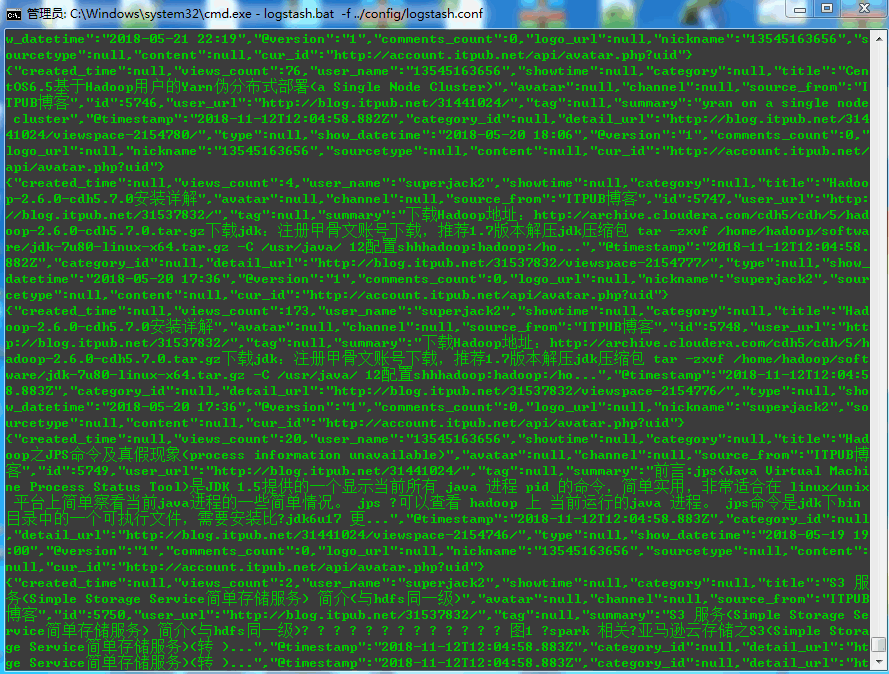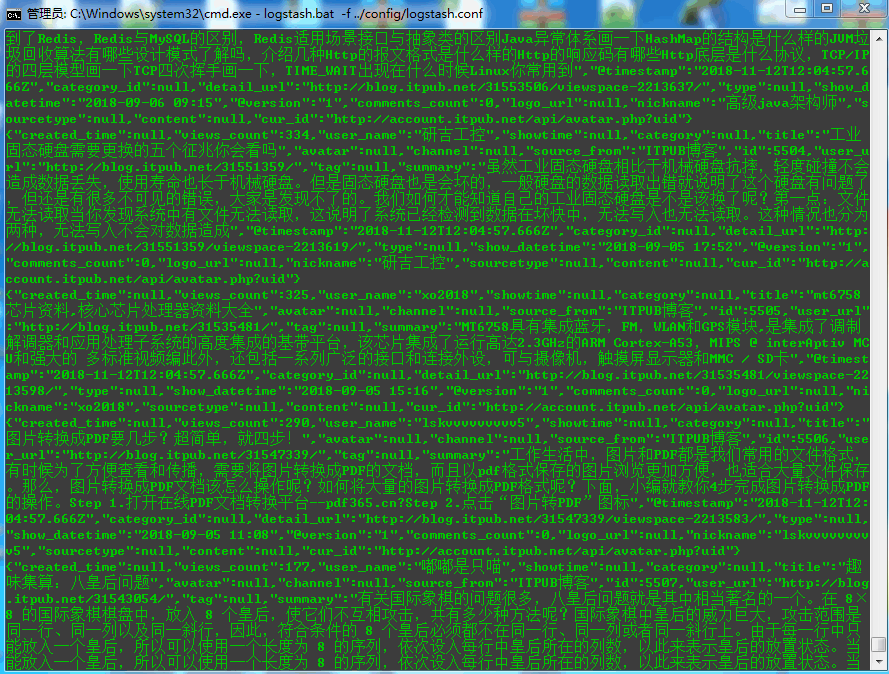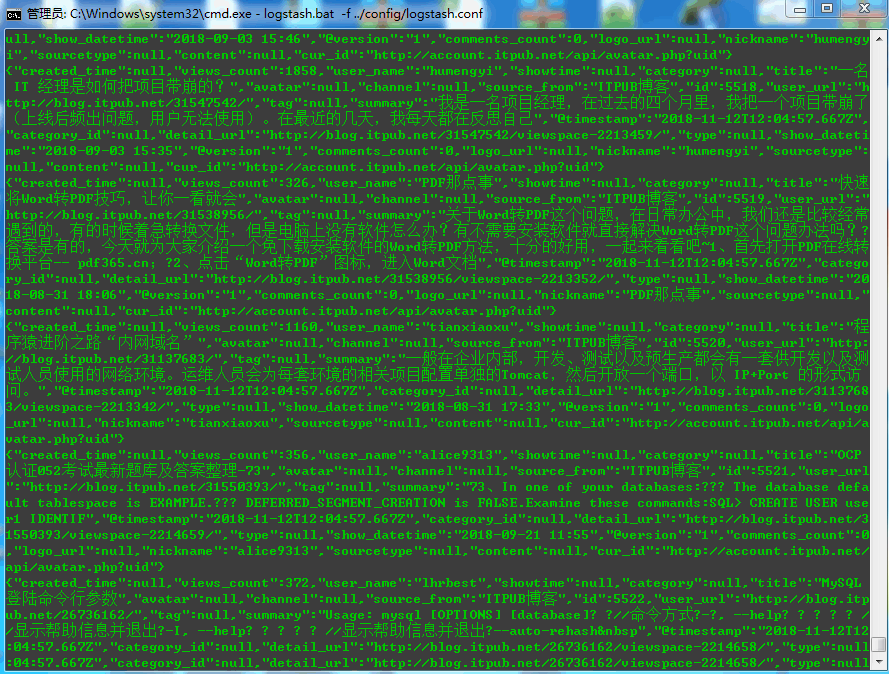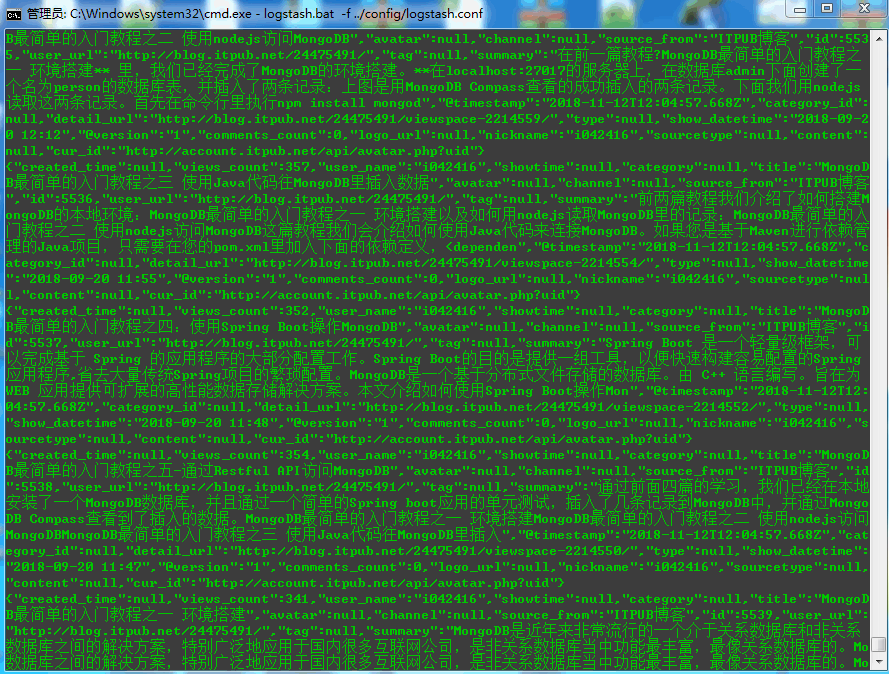
通过kibana查看下数据:OK,同步过来39W+ 记录数据了。

实现logstash6.4.3 同步mysql数据到Elasticsearch6.4.3的更多相关文章
- logstash6.5.4同步mysql数据到elasticsearch 6.4.1
下载logstash-6.5.4 ZIP解压和es 放到es根目录下 下载mysql jdbc的驱动 mysql-connector-java-8.0.12 放在任意目录下 以下方式采用动态模板,还有 ...
- 使用logstash同步MySQL数据到ES
使用logstash同步MySQL数据到ES 版权声明:[分享也是一种提高]个人转载请在正文开头明显位置注明出处,未经作者同意禁止企业/组织转载,禁止私自更改原文,禁止用于商业目的. https:// ...
- 使用Logstash来实时同步MySQL数据到ES
上篇讲到了ES和Head插件的环境搭建和配置,也简单模拟了数据作测试 本篇我们来实战从MYSQL里直接同步数据 一.首先下载和你的ES对应的logstash版本,本篇我们使用的都是6.1.1 下载后使 ...
- Logstash使用jdbc_input同步Mysql数据时遇到的空时间SQLException问题
今天在使用Logstash的jdbc_input插件同步Mysql数据时,本来应该能搜索出10条数据,结果在Elasticsearch中只看到了4条,终端中只给出了如下信息 [2017-08-25T1 ...
- 推荐一个同步Mysql数据到Elasticsearch的工具
把Mysql的数据同步到Elasticsearch是个很常见的需求,但在Github里找到的同步工具用起来或多或少都有些别扭. 例如:某记录内容为"aaa|bbb|ccc",将其按 ...
- centos7配置Logstash同步Mysql数据到Elasticsearch
Logstash 是开源的服务器端数据处理管道,能够同时从多个来源采集数据,转换数据,然后将数据发送到您最喜欢的“存储库”中.个人认为这款插件是比较稳定,容易配置的使用Logstash之前,我们得明确 ...
- Elasticsearch--Logstash定时同步MySQL数据到Elasticsearch
新地址体验:http://www.zhouhong.icu/post/139 一.Logstash介绍 Logstash是elastic技术栈中的一个技术.它是一个数据采集引擎,可以从数据库采集数据到 ...
- 快速同步mysql数据到redis中
MYSQL快速同步数据到Redis 举例场景:存储游戏玩家的任务数据,游戏服务器启动时将mysql中玩家的数据同步到redis中. 从MySQL中将数据导入到Redis的Hash结构中.当然,最直接的 ...
- logstash同步mysql数据失败
问题描述 前提: 项目采用Elasticsearch提供搜索服务,Mysql提供存储服务,通过Logstash将Mysql中数据同步到Elasticsearch. 问题: 使用logstash-j ...
随机推荐
- 20155324王鸣宇 《网络对抗技术》Web基础
20155324王鸣宇 <网络对抗技术>Web基础 实践要求 ①Web前端HTML: 能正常安装.启停Apache.理解HTML,理解表单,理解GET与POST方法,编写一个含有表单的HT ...
- js操作ListBox列表(select)内移动
<script> function listBoxClick(obj, addName) { var $objSelected = $(obj).find("option:sel ...
- 移动端返回上一页,刚需!document.referrer 详解
返回上一页,在PC端我们可以使用:history.go(-1)或者history.back(),可以正常返回第一层.这样,我们不需要上一页的 url 具体是什么,只要使用 history 一般都没啥问 ...
- 安装hue及hadoop和hive整合
环境: centos7 jdk1.8.0_111 Hadoop 2.7.3 Hive1.2.2 hue-3.10.0 Hue安装: 1.下载hue-3.10.0.tgz: https://dl.dro ...
- 命令行神器之argparse使用笔记
示例 废话不多说直接给例子: import argparse parser = argparse.ArgumentParser(description='Imbalanced Dataset Exam ...
- Python规范
1.命名 Django文件命名 小写+下划线 类:驼峰 2.edit 执行环境 work direction 到当前项目目录 3.类要加注释 4.去数据库找数据时需要try捕获异常,防止数据库连接断掉 ...
- python日志重复输出
在学习了python的函数式编程后,又接触到了logging这样一个强大的日志模块.为了减少重复代码,应该不少同学和我一样便迫不及待的写了一个自己的日志函数,比如下面这样: # 这里为了便于理解, ...
- 删除Win10资源管理器中的3D对象/音乐/视频文件夹
Win10如何删除资源管理器中的3D对象/音乐/视频等文件夹?使用Win10系统的用户都知道,打开此电脑之后,资源管理上面会显示文档/音乐/视频等7个文件夹,一些用户认为很少使用到它们,想要除之而后快 ...
- WPF 10天修炼 第十天- WPF数据绑定
WPF数据绑定 数据绑定到元素属性是将源对象指定为一个WPF元素,并且源属性是一个依赖属性,依赖属性内置了变更通知.当改变源对象依赖属性值之后,绑定目标可以立即得到更新,开发人员不需要手动编写响应事件 ...
- 解决Windows服务无法访问网络映射盘的问题
下载工具psexec 下载地址:https://docs.microsoft.com/zh-cn/sysinternals/downloads/psexec 百度地址:https://pan.baid ...