
用python3读CSV文件,出现UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd0 in position 0: invalid con
使用pd.read_csv()读csv文件时,出现如下错误:
UnicodeDecodeError: ‘utf-8’ codec can’t decode byte 0xd0 in position 0: invalid continuation byte
出现原因:文件不是 UTF8 编码的,而系统默认采用 UTF8 解码。解决方法是改为对应的解码方式。
解决办法:
找到csv文件–》右键–》打开方式–》记事本
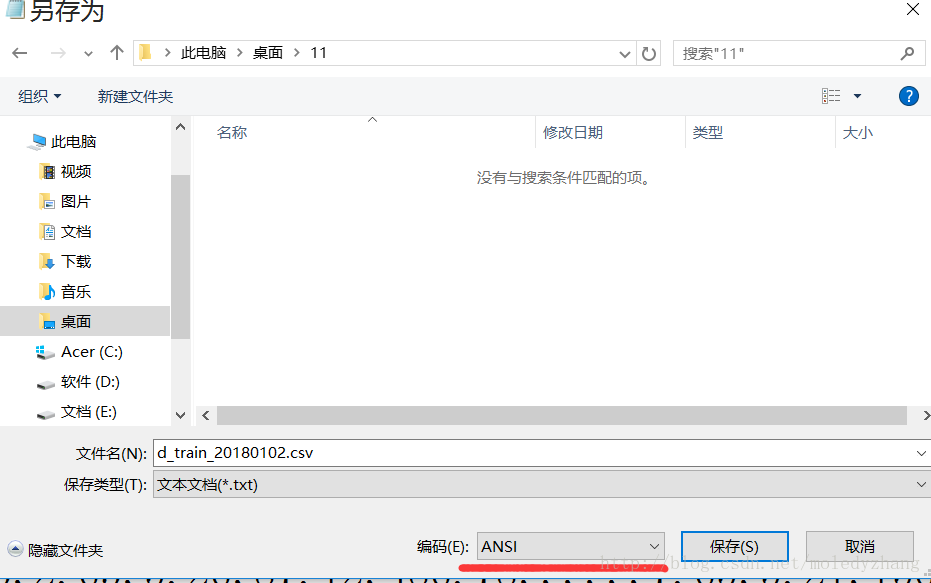
打开记事本之后,选择头部菜单的“文件–》另存为”,可以看到文件的默认编码格式为ANSI
选择编码下拉框,选择需要的编码格式UTF8,重新保存即可
最后重新运行代码,问题得到解决

用python3读CSV文件,出现UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd0 in position 0: invalid con的更多相关文章
- UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd0 in position 0: invalid continuation byte
用pandas打开csv文件可能会出现这种情况,原因可能是excel自己新建一个*.csv文件时候容易出错.进入文件另存为,然后选择csv文件即可.
- Pandas读取文件报错UnicodeDecodeError: 'utf-8' codec can't decode byte 0xb6 in position 0: invalid start byte
pandas读取文件时报UnicodeDecodeError: 'utf-8' codec can't decode byte 0xb6 in position 0: invalid start by ...
- TensorFlow学习笔记(UTF-8 问题解决 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xff in position 0: invalid start byte)
我使用VS2013 Python3.5 TensorFlow 1.3 的开发环境 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xff ...
- Python:出现UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc9 in position 0: invalid continuation byte问题
我在导入一个csv文件的时候出现了一个问题 报错的内容是这样的: UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc9 in positio ...
- tensorflow UnicodeDecodeError: 'utf-8' codec can't decode byte 0xff in position 0: invalid start byte
tensorflow读取图像出现错误:UnicodeDecodeError: 'utf-8' codec can't decode byte 0xff in position 0: invalid s ...
- binlog2sql 解析日志失败 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xba in position 0: invalid start byte
python35 ./binlog2sql.py -h... -P... -u... -p... -B --start-file="mysql-bin.091940" --star ...
- 用python3读csv文件出现UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd6 in position 0: invalid continuation byte
1.python3读取csv文件时报如下图所示的错误 2.分析原因:读取的csv文件不是 UTF8 编码的,而IDE工具默认采用 UTF8 解码.解决方法是修改源文件的解码方式. 3.使用nodepa ...
- UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd0 in position 140: invalid continuation byte
web阅片系统,遇到dicom文件在文件夹不能正常读取的问题.解决方法如下: def rep7(request): file_path = os.path.dirname(__file__) + re ...
- 第一篇:UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc3 in position 0: invalid continuation byte
需求:python如何实现普通用户登录服务器后切换到root用户再执行命令 解决参考: 代码: def verification_ssh(host,username,password,port,roo ...
随机推荐
- wireshark抓包,安装及简单使用
跟着实验室师兄尝试做流量分析,趁着离期末考试还有几天,尽快把环境搭好. 采集:自动化测试monkeyrunner,ok 抓包 charles/Wireshark,ok 限制其他应用运行App Moun ...
- SQL LAST() 函数
LAST() 函数 LAST() 函数返回指定的字段中最后一个记录的值. 提示:可使用 ORDER BY 语句对记录进行排序. SQL LAST() 语法 SELECT LAST(column_nam ...
- ASP.NET MVC 下自定义 ModelState 扩展类,响应给 AJAX
ModelStateExtensions.cs using System.Collections.Generic; using System.Linq; using System.Web.Mvc; n ...
- An internal error occurred during: Initializing Java Tooling.
详细错误信息: An internal error occurred during: "Initializing Java Tooling". java.lang.NullPoin ...
- 深蓝词库转换2.4版发布,支持最新的搜狗用户词库备份bin格式
很高兴的告诉大家,感谢GitHub上的h4x3rotab提供python版的搜狗用户词库备份bin格式的解析算法,感谢tmxkn1提供了C#版的实现,深蓝词库转换终于迎来了一个重大更新,能够支持搜狗用 ...
- 使用FreeHttp强制登出微信公众号登陆状态(实现~原理)
概述 我们使用的部分网站设计成一旦登录即不允许用户手动退出,现实场景中是没有问题的 但如果是在测试或调试过程中就会有强制登出的需求 如果当前使用的是PC浏览器,您或许可以通过调试模式清除保持登录信息的 ...
- 你不需要 jQuery,但你需要一个 DOM 库
写这篇文章的目的,一方面是介绍一下自己编写的模块化 DOM 库 domq.js,另一方面是希望大家对 jQuery 有一个正确的认识,即使 jQuery 已经逐渐退出历史舞台,但是它的 API 将会以 ...
- 大神教你如何解决Linux系统80端口被占用
有Linux在centos下面安装webmail服务遇到80端口被占用的问题,导致无法继续安装,下面详细介绍下Linux如何查看.查找.关闭监听80端口服务以更好的的解决80端口被占用的问题. 一.查 ...
- python中的线程技术
#!/user/bin/env python # @Time :2018/7/7 11:42 # @Author :PGIDYSQ #@File :DaemonTest.py import threa ...
- LODOP获取打印机状态码和状态码含义测试
由于打印机千差万别,打印机执行的标准也不一样,LODOP获取的打印状态码也可能不同,安装了个打印机驱动实际测试一下,测试的打印机驱动是Brother Color Type3 Class Driver. ...