
Google图片和NASA 网站图片的爬虫
1.根据关键字爬取NASA网站上的图片
首先针对需要爬取的网站进行分析,输入关键字查找需要的内容

通过关键字请求,网页每次会加载20张的缩略图,分析网页源码能够很容易的找到缩略图的url:

然后再点开缩略图,会链接的另一个网页,从这里可以分析出更高分辨率大图的url:
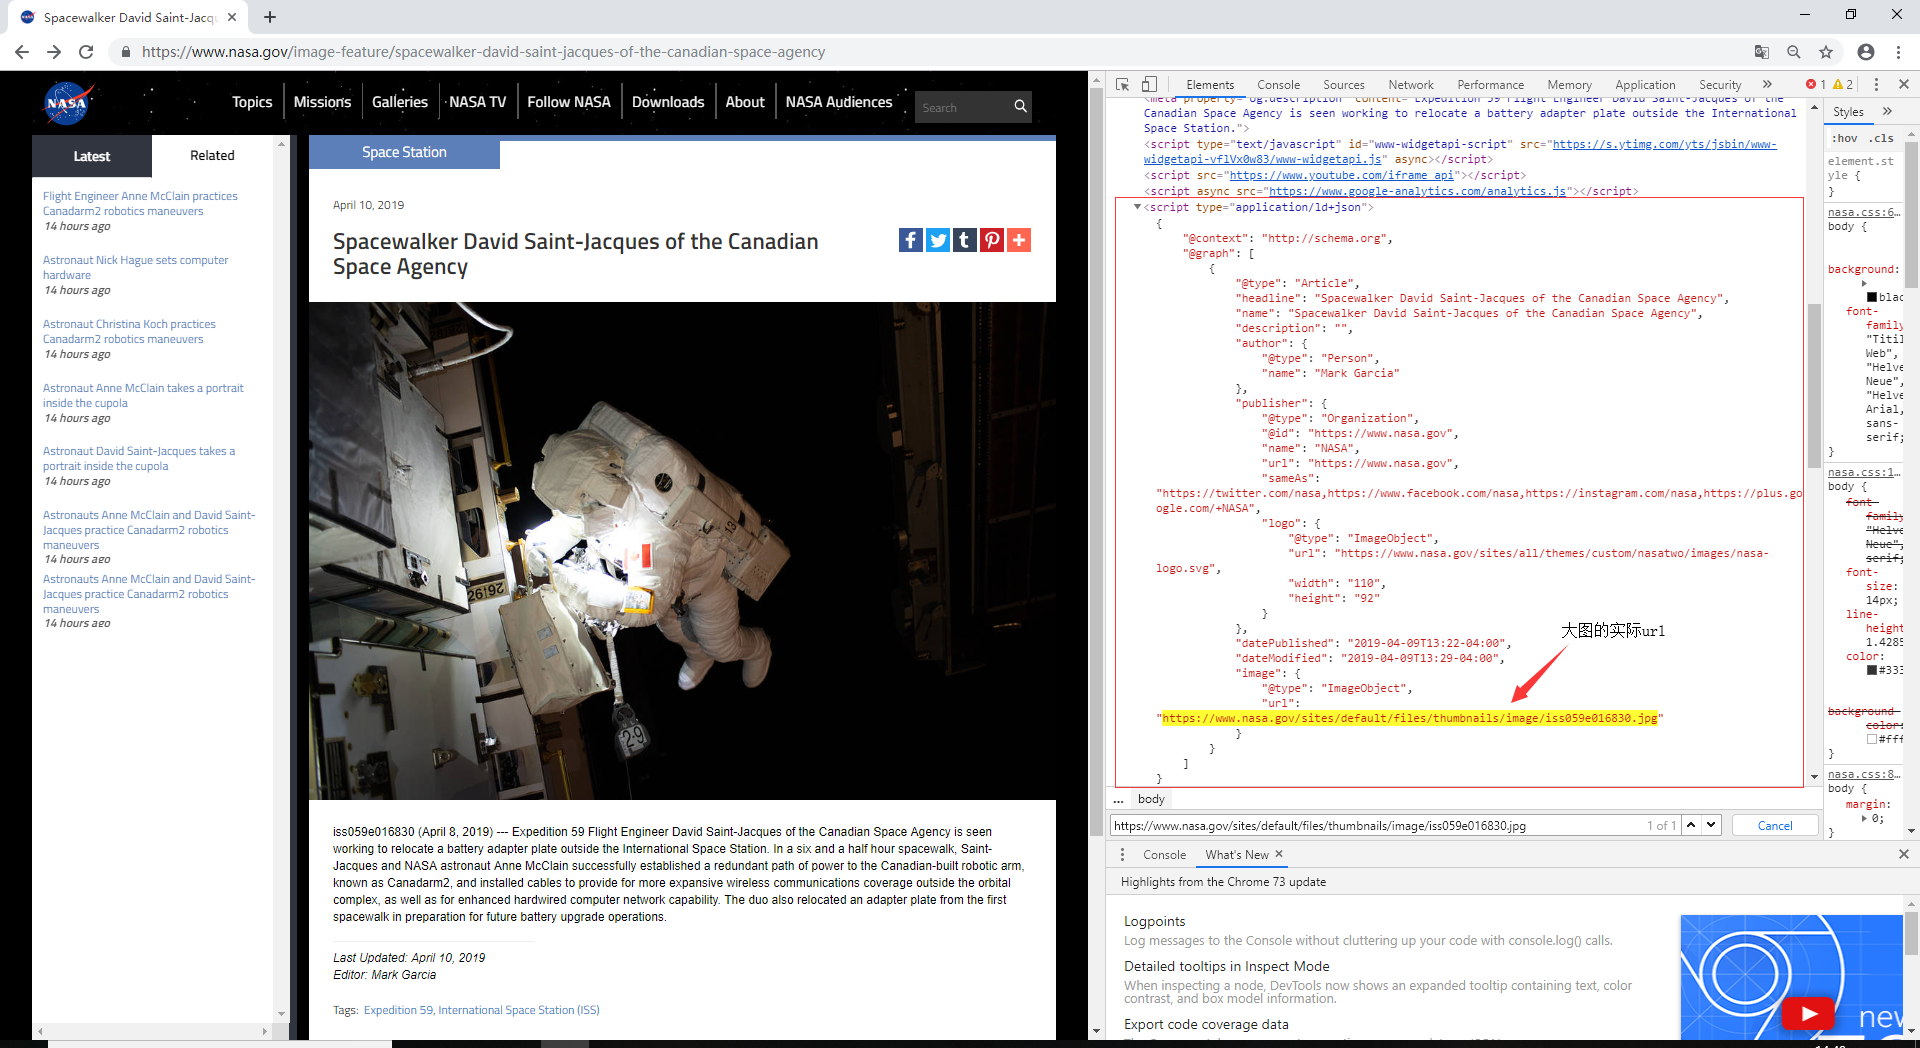
最后根据取得的url地址下载原图就可以了,下面附上源代码
# -*- coding: utf-8 -*-

import urllib

import requests

from bs4 import BeautifulSoup

import re

import json

def getUrl(keyword):

    user_agent = 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.10; rv:53.0) Gecko/20100101 Firefox/53.0'

    results = requests.get("https://nasasearch.nasa.gov/search/images",

                           params={'affiliate': 'nasa', 'query': keyword},

                           headers={'User-Agent': user_agent})

    results.encoding = 'utf-8'

    s = requests.session()

    s.keep_alive = False

    soup = BeautifulSoup(results.text, 'lxml')

    # 获取网页中的所有div ,class=url的文本

    for link in soup.find_all('div', class_='url'):

        # 拼接url

        html = requests.get('https://'+link.text)

        soup1 = BeautifulSoup(html.text, 'lxml')

        # 获取字段

        data = soup1.find('script', attrs={"type": "application/ld+json"})

        # json字符串转换为字典

        jsonobj = json.loads(data.text)

        # 从json块中获取图片地址

        imageUrl = jsonobj['@graph'][0]['image']['url']

        namelist = imageUrl.split('/')

        # 获取图片名称

        name = namelist[-1].split('.')[0]

        downloadImage(imageUrl, name)

def downloadImage(imageUrl, name):

    path = 'D:/space/'

    print(name)

    if imageUrl is not None:

        try:

            image_file = requests.get(imageUrl, stream=True, timeout=9)

        except requests.exceptions.RequestException:

            print('网络异常')

        # else:

            # if image_file.status_code is not requests.codes.ok:

            #print('{}'.format(imageUrl) + '链接为空!')

        else:

            image_file_path = '{}{}.jpg'.format(path, name)

            print('正在下载:' + '{}.jpg'.format(name))

            with open(image_file_path, 'wb') as f:

                f.write(image_file.content)

            print('下载完成!')

if __name__ == "__main__":

    keyword = input()

    getUrl(keyword)
2.爬取谷歌图片
这里主要使用了一个开源代码,爬虫作者github地址:https://github.com/YoongiKim/AutoCrawler
爬虫的效果还是很不错的,具体的使用作者在主页也详细的说明了
Google图片和NASA 网站图片的爬虫的更多相关文章
- C#获取网页的HTML码、下载网站图片、获取IP地址
1.根据URL请求获取页面HTML代码 /// <summary> /// 获取网页的HTML码 /// </summary> /// <param name=" ...
- C#获取网页的HTML码、下载网站图片
1.根据URL请求获取页面HTML代码 /// <summary> /// 获取网页的HTML码 /// </summary> /// <param name=" ...
- Python爬虫下载美女图片(不同网站不同方法)
声明:以下代码,Python版本3.6完美运行 一.思路介绍 不同的图片网站设有不同的反爬虫机制,根据具体网站采取对应的方法 1. 浏览器浏览分析地址变化规律 2. Python测试类获取网页内容,从 ...
- webmagic 二次开发爬虫 爬取网站图片
webmagic的是一个无须配置.便于二次开发的爬虫框架,它提供简单灵活的API,只需少量代码即可实现一个爬虫. webmagic介绍 编写一个简单的爬虫 webmagic的使用文档:http://w ...
- Python爬虫实战:批量下载网站图片
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: GitPython PS:如有需要Python学习资料的小伙伴可以 ...
- Scrapy爬取美女图片第四集 突破反爬虫(上)
本周又和大家见面了,首先说一下我最近正在做和将要做的一些事情.(我的新书<Python爬虫开发与项目实战>出版了,大家可以看一下样章) 技术方面的事情:本次端午假期没有休息,正在使用fl ...
- 如何:使用PicturBox实现类似淘宝网站图片的局部放大功能
转载至http://xuzhihong1987.blog.163.com/blog/static/267315872011822113131823/ 概要: 本文将讲述如何使用PictureBox控件 ...
- Web 性能优化: 图片优化让网站大小减少 62%
摘要: 压缩各种格式的图片. 原文:Web 性能优化: 图片优化让网站大小减少 62% 作者:前端小智 Fundebug经授权转载,版权归原作者所有. 这是 Web 性能优化的第二篇,上一篇在下面看点 ...
- 批量下载网站图片的Python实用小工具
定位 本文适合于熟悉Python编程且对互联网高清图片饶有兴趣的筒鞋.读完本文后,将学会如何使用Python库批量并发地抓取网页和下载图片资源.只要懂得如何安装Python库以及运行Python程序, ...
随机推荐
- HDU 3790 最短生成树 (最短路)
题目链接 Problem Description 给你n个点,m条无向边,每条边都有长度d和花费p,给你起点s终点t,要求输出起点到终点的最短距离及其花费,如果最短距离有多条路线,则输出花费最少的. ...
- 爬虫--selenium
什么是selenium? 基本使用 from selenium import webdriver from selenium.webdriver.common.by import By from se ...
- java在CMD窗口执行程序的时候输入密码(隐藏一些敏感信息)
有时候我们需要从CMD窗口执行一些命令,有时候会输入一些敏感的信息,比如密码之类的东西,所以我们可以从控制台读取但是不希望别人看见我们的密码: import java.io.Console; /** ...
- Mysql储存过程7: case
#用在储存过程中: create procedure k() begin declare number int; )); case number then select '>0'; else s ...
- java的loadrunner脚本案例
/* * LoadRunner Java script. (Build: 670) * * ״̬£º²¢·¢²âÊÔͨ¹ý * ²âÊÔÈË£ºÕÔС±ò * ÈÕÆÚ£º2013-09-2 ...
- error: expected expression before ‘struct
Linux C/C++编程时常会遇到“error: expected expression before ‘struct’”错误,此错误一般是由未定义的宏(宏里套宏)或参量引起,导致编译器判断当前语句 ...
- meta标签的使用方法(PC端)
<!DOCTYPE html> <html lang="en"> <head> <!--设定页面使用的字符集--> <meta ...
- 洛谷 P1296奶牛的耳语 题解
题目传送门 这道题很显然可以用O(n2)的方法来做(记得排序),由于数据较水...但还是在for循环中加一些优化:++i,据说这样会快一些... #include<bits/stdc++.h&g ...
- 大理石在哪儿(UVa10474)
题目具体描述见:https://uva.onlinejudge.org/index.php?option=com_onlinejudge&Itemid=8&category=835&a ...
- C#窗体内嵌外部程序(cmd.exe)的显示【转载】
[DllImport("User32.dll ", EntryPoint = "SetParent")] private static extern IntPt ...