
利用Python爬取免费代理IP
#       2019/9/8

#       思路:   1、找到一个免费的ip代理网站(如:西刺代理)

#

#                  2、爬取ip(常规爬取requests+BeautifulSoup)

#

#                  3、验证ip有效性(携带爬取到的ip,去访问指定的url,看返回的状态码是不是200)

#

#                  4、记录ip (写到文档)

# !/usr/bin/env python3

# -*- coding: utf-8 -*-

import requests, threading, datetime

from bs4 import BeautifulSoup

import random

"""

1、抓取西刺代理网站的代理ip

2、并根据指定的目标url,对抓取到ip的有效性进行验证

3、最后存到指定的path

"""

# ------------------------------------------------------文档处理--------------------------------------------------------

# 写入文档

def write(path, text):

    with open(path, 'a', encoding='utf-8') as f:

        f.writelines(text)

        f.write('\n')

        f.close()

# 清空文档

def truncatefile(path):

    with open(path, 'w', encoding='utf-8') as f:

        f.truncate()

# 读取文档

def read(path):

    with open(path, 'r', encoding='utf-8') as f:

        txt = []

        for s in f.readlines():

            txt.append(s.strip())

    return txt

# ----------------------------------------------------------------------------------------------------------------------

# 计算时间差,格式: 时分秒

def gettimediff(start, end):

    seconds = (end - start).seconds

    m, s = divmod(seconds, 60)

    h, m = divmod(m, 60)

    diff = ("%02d:%02d:%02d" % (h, m, s))

    return diff

# ----------------------------------------------------------------------------------------------------------------------

# 返回一个随机的请求头 headers

def getheaders():

    user_agent_list = [ \

        "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/22.0.1207.1 Safari/537.1" \

        "Mozilla/5.0 (X11; CrOS i686 2268.111.0) AppleWebKit/536.11 (KHTML, like Gecko) Chrome/20.0.1132.57 Safari/536.11", \

        "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1092.0 Safari/536.6", \

        "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.6 (KHTML, like Gecko) Chrome/20.0.1090.0 Safari/536.6", \

        "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/19.77.34.5 Safari/537.1", \

        "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.9 Safari/536.5", \

        "Mozilla/5.0 (Windows NT 6.0) AppleWebKit/536.5 (KHTML, like Gecko) Chrome/19.0.1084.36 Safari/536.5", \

        "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \

        "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_8_0) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1063.0 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1062.0 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 6.1) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.1 Safari/536.3", \

        "Mozilla/5.0 (Windows NT 6.2) AppleWebKit/536.3 (KHTML, like Gecko) Chrome/19.0.1061.0 Safari/536.3", \

        "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24", \

        "Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/535.24 (KHTML, like Gecko) Chrome/19.0.1055.1 Safari/535.24"

    ]

    UserAgent = random.choice(user_agent_list)

    headers = {'User-Agent': UserAgent}

    return headers

# -----------------------------------------------------检查ip是否可用----------------------------------------------------

def checkip(targeturl, ip):

    headers = getheaders()  # 定制请求头

    proxies = {"http": "http://" + ip, "https": "http://" + ip}  # 代理ip

    try:

        response = requests.get(url=targeturl, proxies=proxies, headers=headers, timeout=5).status_code

        if response == 200:

            return True

        else:

            return False

    except:

        return False

# -------------------------------------------------------获取代理方法----------------------------------------------------

# 免费代理 XiciDaili

def findip(type, pagenum, targeturl, path):  # ip类型,页码,目标url,存放ip的路径

    list = {'1': 'http://www.xicidaili.com/wn/',  # xicidaili国内https代理

    '2': 'http://www.xicidaili.com/nn/',  # xicidaili国内高匿代理

    '3': 'http://www.xicidaili.com/nt/',  # xicidaili国内普通代理

    '4': 'http://www.xicidaili.com/wt/'}  # xicidaili国外http代理

    url = list[str(type)] + str(pagenum)  # 配置url

    # print("url:",url)

    headers = getheaders()  # 定制请求头

    html = requests.get(url=url, headers=headers, timeout=5).text

    # print("html:", html)

    soup = BeautifulSoup(html, 'lxml')

    all = soup.find_all('tr', class_='odd')

    for i in all:

        t = i.find_all('td')

        ip = t[1].text + ':' + t[2].text

        is_avail = checkip(targeturl, ip)

        if is_avail == True:

            write(path=path, text=ip)

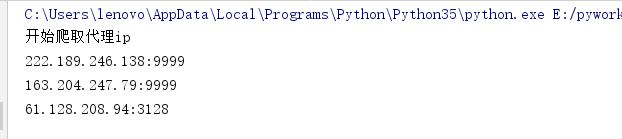
            print(ip)

# -----------------------------------------------------多线程抓取ip入口---------------------------------------------------

def getip(targeturl, path):

    truncatefile(path)  # 爬取前清空文档

    start = datetime.datetime.now()  # 开始时间

    threads = []

    for type in range(1):  # 四种类型ip,每种类型取前三页,共12条线程

        for pagenum in range(3):

            t = threading.Thread(target=findip, args=(type + 1, pagenum + 1, targeturl, path))

            threads.append(t)

    print('开始爬取代理ip')

    for s in threads:  # 开启多线程爬取

        s.start()

    for e in threads:  # 等待所有线程结束

        e.join()

    print('爬取完成')

    end = datetime.datetime.now()  # 结束时间

    diff = gettimediff(start, end)  # 计算耗时

    ips = read(path)  # 读取爬到的ip数量

    print('一共爬取代理ip: %s 个,共耗时: %s \n' % (len(ips), diff))

# -------------------------------------------------------启动-----------------------------------------------------------

if __name__ == '__main__':

    path = 'ip.txt'  # 存放爬取ip的文档path

    targeturl = 'http://www.cnblogs.com/TurboWay/'  # 验证ip有效性的指定url

    getip(targeturl, path)
利用Python爬取免费代理IP的更多相关文章
- 极简代理IP爬取代码——Python爬取免费代理IP
这两日又捡起了许久不碰的爬虫知识,原因是亲友在朋友圈拉人投票,点进去一看发现不用登陆或注册,觉得并不复杂,就一时技痒搞一搞,看看自己的知识都忘到啥样了. 分析一看,其实就是个post请求,需要的信息都 ...
- python爬取免费优质IP归属地查询接口
python爬取免费优质IP归属地查询接口 具体不表,我今天要做的工作就是: 需要将数据库中大量ip查询出起归属地 刚开始感觉好简单啊,毕竟只需要从百度找个免费接口然后来个python脚本跑一晚上就o ...
- 第二篇 - python爬取免费代理
代理的作用参考https://wenda.so.com/q/1361531401066511?src=140 免费代理很多,但也有很多不可用,所以我们可以用程序对其进行筛选.以能否访问百度为例. 1. ...
- golang爬取免费代理IP
golang爬取免费的代理IP,并验证代理IP是否可用 这里选择爬取西刺的免费代理Ip,并且只爬取了一页,爬取的时候不设置useAgent西刺不会给你数据,西刺也做反爬虫处理了,所以小心你的IP被封掉 ...
- 简单爬虫-爬取免费代理ip
环境:python3.6 主要用到模块:requests,PyQuery 代码比较简单,不做过多解释了 #!usr/bin/python # -*- coding: utf-8 -*- import ...
- PHP简单爬虫 爬取免费代理ip 一万条
目标站:http://www.xicidaili.com/ 代码: <?php require 'lib/phpQuery.php'; require 'lib/QueryList.php'; ...
- 利用python爬取58同城简历数据
利用python爬取58同城简历数据 利用python爬取58同城简历数据 最近接到一个工作,需要获取58同城上面的简历信息(http://gz.58.com/qzyewu/).最开始想到是用pyth ...
- 利用python爬取城市公交站点
利用python爬取城市公交站点 页面分析 https://guiyang.8684.cn/line1 爬虫 我们利用requests请求,利用BeautifulSoup来解析,获取我们的站点数据.得 ...
- 利用Python爬取可用的代理IP
前言 就以最近发现的一个免费代理IP网站为例:http://www.xicidaili.com/nn/.在使用的时候发现很多IP都用不了. 所以用Python写了个脚本,该脚本可以把能用的代理IP检测 ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
随机推荐
- Network Science: 巴拉巴西网络科学阅读笔记
前言: 最小生成树中Kruskal算法对应了统计物理中的著名模型invasion percolation.由此写了一篇文章:invasion percolation and global optimi ...
- Kubernetes Gateway API 深入解读和落地指南
背景 Kubernetes Gateway API 是 Kubernetes 1.18 版本引入的一种新的 API 规范,是 Kubernetes 官方正在开发的新的 API,Ingress 是 Ku ...
- AspNetCoreRateLimit应用于MVC项目求助
AspNetCoreRateLimit应用于MVC项目求助 前言 之前发过一篇文章: .NET Core WebApi接口ip限流实践 - 妙妙屋(zy) - 博客园 (cnblogs.com) 然后 ...
- 记一次某CMS代码审计(转载)
作者:ddwGeGe 本文转自先知社区:https://xz.aliyun.com/t/11774 前言 无意中浏览到某小众OA官网且可以下载到源码,随机审计一波,最后成功Getshell,大佬勿喷 ...
- percona-server-rocksdb-8.0.32 安装
MyRocks是关系型数据库Mysql 基于RocksDB 的存储引擎,一个可嵌入的.持久的键值存储.Percona MyRocks 是集于 Percona Server for MySQL的. Ro ...
- 2021-01-08:cpu和gpu有什么区别?
福哥答案2021-01-08:[答案来自此链接:](https://www.cnblogs.com/biglucky/p/4223565.html)Cache, local memory: CPU & ...
- 2021-08-03:完美洗牌问题。给定一个长度为偶数的数组arr,假设长度为N*2,左部分:arr[L1……Ln],右部分: arr[R1……Rn],请把arr调整成arr[L1,R1,L2,R2,
2021-08-03:完美洗牌问题.给定一个长度为偶数的数组arr,假设长度为N*2,左部分:arr[L1--Ln],右部分: arr[R1--Rn],请把arr调整成arr[L1,R1,L2,R2, ...
- Django4全栈进阶之路20 项目实战(在线报修):项目需求分析
为了实现一个在线报修系统,您可以按照以下步骤进行: 创建Django项目和应用 使用Django的命令行工具创建一个Django项目,并在该项目中创建一个名为"RepairApp" ...
- 这款全自动自适应工具你用过了吗?autofit.js请求加入你的战场!
前段时间做了一个自适应的小工具(autofit.js) 经过一段时间的试用,同学们发现了工具存在的一些问题,我自己也发现了一些,这篇文章是针对这些问题撰写的. autofit.js autofit.j ...
- k8s资源对象(二)
Configmap和Secret资源介绍 secret和configmap资源都是通过挂载的方式将对应数据挂载到容器内部环境中去使用,两者的使用没有太多的不同 ,configmap资源通常用于为pod ...