
B-Tree和 B+Tree的数据存储结构
B+树索引是B+树在数据库中的一种实现,是最常见也是数据库中使用最为频繁的一种索引。B+树中的B代表平衡(balance),而不是二叉(binary),因为B+树是从最早的平衡二叉树演化而来的。在讲B+树之前必须先了解二叉查找树、平衡二叉树(AVLTree)和平衡多路查找树(B-Tree),B+树即由这些树逐步优化而来。
二叉查找树
二叉查找树的性质:左子树的键值小于根的键值,右子树的键值大于根的键值。

平衡二叉树(AVL Tree)
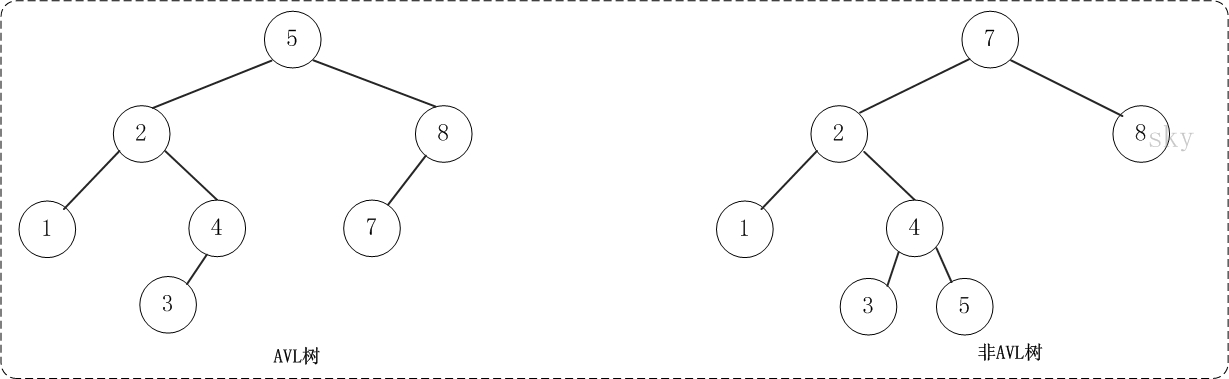
平衡二叉树(AVL树)在符合二叉查找树的条件下,还满足任何节点的两个子树的高度最大差为1。
B-Tree(平衡多路查找树)
B-Tree是为磁盘等外存储设备设计的一种平衡查找树。因此在讲B-Tree之前先了解下磁盘的相关知识。
系统从磁盘读取数据到内存时是以磁盘块(block)为基本单位的,位于同一个磁盘块中的数据会被一次性读取出来,而不是需要什么取什么。
InnoDB存储引擎中有页(Page)的概念,页是其磁盘管理的最小单位。InnoDB存储引擎中默认每个页的大小为16KB,可通过参数innodb_page_size将页的大小设置为4K、8K、16K,在MySQL中可通过如下命令查看页的大小:
mysql> show variables like 'innodb_page_size'
而系统一个磁盘块的存储空间往往没有这么大,因此InnoDB每次申请磁盘空间时都会是若干地址连续磁盘块来达到页的大小16KB。InnoDB在把磁盘数据读入到磁盘时会以页为基本单位,在查询数据时如果一个页中的每条数据都能有助于定位数据记录的位置,这将会减少磁盘I/O次数,提高查询效率。
B-Tree结构的数据可以让系统高效的找到数据所在的磁盘块。为了描述B-Tree,首先定义一条记录为一个二元组[key, data] ,key为记录的键值,对应表中的主键值,data为一行记录中除主键外的数据。对于不同的记录,key值互不相同。
一棵m阶的B-Tree有如下特性:
1. 每个节点最多有m个孩子。
2. 除了根节点和叶子节点外,其它每个节点至少有Ceil(m/2)个孩子。
3. 若根节点不是叶子节点,则至少有2个孩子
4. 所有叶子节点都在同一层,且不包含其它关键字信息
5. 每个非终端节点包含n个关键字信息(P0,P1,…Pn, k1,…kn)
6. 关键字的个数n满足:ceil(m/2)-1 <= n <= m-1
7. ki(i=1,…n)为关键字,且关键字升序排序。
8. Pi(i=1,…n)为指向子树根节点的指针。P(i-1)指向的子树的所有节点关键字均小于ki,但都大于k(i-1)
B-Tree中的每个节点根据实际情况可以包含大量的关键字信息和分支,如下图所示为一个3阶的B-Tree: 
每个节点占用一个盘块的磁盘空间,一个节点上有两个升序排序的关键字和三个指向子树根节点的指针,指针存储的是子节点所在磁盘块的地址。两个关键词划分成的三个范围域对应三个指针指向的子树的数据的范围域。以根节点为例,关键字为17和35,P1指针指向的子树的数据范围为小于17,P2指针指向的子树的数据范围为17~35,P3指针指向的子树的数据范围为大于35。
模拟查找关键字29的过程:
- 根据根节点找到磁盘块1,读入内存。【磁盘I/O操作第1次】
- 比较关键字29在区间(17,35),找到磁盘块1的指针P2。
- 根据P2指针找到磁盘块3,读入内存。【磁盘I/O操作第2次】
- 比较关键字29在区间(26,30),找到磁盘块3的指针P2。
- 根据P2指针找到磁盘块8,读入内存。【磁盘I/O操作第3次】
- 在磁盘块8中的关键字列表中找到关键字29。
分析上面过程,发现需要3次磁盘I/O操作,和3次内存查找操作。由于内存中的关键字是一个有序表结构,可以利用二分法查找提高效率。而3次磁盘I/O操作是影响整个B-Tree查找效率的决定因素。B-Tree相对于AVLTree缩减了节点个数,使每次磁盘I/O取到内存的数据都发挥了作用,从而提高了查询效率。
B+Tree
B+Tree是在B-Tree基础上的一种优化,使其更适合实现外存储索引结构,InnoDB存储引擎就是用B+Tree实现其索引结构。
从上一节中的B-Tree结构图中可以看到每个节点中不仅包含数据的key值,还有data值。而每一个页的存储空间是有限的,如果data数据较大时将会导致每个节点(即一个页)能存储的key的数量很小,当存储的数据量很大时同样会导致B-Tree的深度较大,增大查询时的磁盘I/O次数,进而影响查询效率。在B+Tree中,所有数据记录节点都是按照键值大小顺序存放在同一层的叶子节点上,而非叶子节点上只存储key值信息,这样可以大大加大每个节点存储的key值数量,降低B+Tree的高度。
B+Tree相对于B-Tree有几点不同:
- 非叶子节点只存储键值信息。
- 所有叶子节点之间都有一个链指针。
- 数据记录都存放在叶子节点中。
将上一节中的B-Tree优化,由于B+Tree的非叶子节点只存储键值信息,假设每个磁盘块能存储4个键值及指针信息,则变成B+Tree后其结构如下图所示:
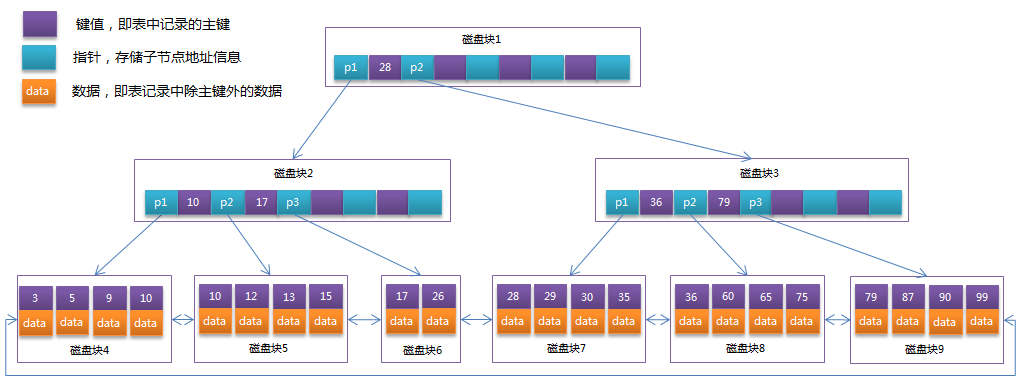
通常在B+Tree上有两个头指针,一个指向根节点,另一个指向关键字最小的叶子节点,而且所有叶子节点(即数据节点)之间是一种链式环结构。因此可以对B+Tree进行两种查找运算:一种是对于主键的范围查找和分页查找,另一种是从根节点开始,进行随机查找。
可能上面例子中只有22条数据记录,看不出B+Tree的优点,下面做一个推算:
InnoDB存储引擎中页的大小为16KB,一般表的主键类型为INT(占用4个字节)或BIGINT(占用8个字节),指针类型也一般为4或8个字节,也就是说一个页(B+Tree中的一个节点)中大概存储16KB/(8B+8B)=1K个键值(因为是估值,为方便计算,这里的K取值为〖10〗^3)。也就是说一个深度为3的B+Tree索引可以维护10^3 * 10^3 * 10^3 = 10亿 条记录。
实际情况中每个节点可能不能填充满,因此在数据库中,B+Tree的高度一般都在2~4层。mysql的InnoDB存储引擎在设计时是将根节点常驻内存的,也就是说查找某一键值的行记录时最多只需要1~3次磁盘I/O操作。
数据库中的B+Tree索引可以分为聚集索引(clustered index)和辅助索引(secondary index)。上面的B+Tree示例图在数据库中的实现即为聚集索引,聚集索引的B+Tree中的叶子节点存放的是整张表的行记录数据。辅助索引与聚集索引的区别在于辅助索引的叶子节点并不包含行记录的全部数据,而是存储相应行数据的聚集索引键,即主键。当通过辅助索引来查询数据时,InnoDB存储引擎会遍历辅助索引找到主键,然后再通过主键在聚集索引中找到完整的行记录数据。
B-Tree和 B+Tree的数据存储结构的更多相关文章
- Berkeley DB的数据存储结构——哈希表(Hash Table)、B树(BTree)、队列(Queue)、记录号(Recno)
Berkeley DB的数据存储结构 BDB支持四种数据存储结构及相应算法,官方称为访问方法(Access Method),分别是哈希表(Hash Table).B树(BTree).队列(Queue) ...
- kafka 数据存储结构+原理+基本操作命令
数据存储结构: Kafka中的Message是以topic为基本单位组织的,不同的topic之间是相互独立的.每个topic又可以分成几个不同的partition(每个topic有几个partitio ...
- Cassandra 的数据存储结构——本质是SortedMap<RowKey, SortedMap<ColumnKey, ColumnValue>>
Cassandra 的数据存储结构 Cassandra 的数据模型是基于列族(Column Family)的四维或五维模型.它借鉴了 Amazon 的 Dynamo 和 Google's BigTab ...
- 0809MySQL实战系列:大字段如何优化|数据存储结构
转自https://yq.aliyun.com/articles/59256?spm=5176.100239.blogcont59257.9.5MLR2d 摘要: 背景 线上发现一张表,1亿的数据量, ...
- mysql的innodb数据存储结构
数据库磁盘读取与系统磁盘读取 1,系统从磁盘中读取数据到内存时是以磁盘块(block)为基本单位,位于同一个磁盘块中的数据会被一次性读取出来. 2,innodb存储引擎中有页(Page)的概念,页 ...
- Hashtable数据存储结构-遍历规则,Hash类型的复杂度为啥都是O(1)-源码分析
Hashtable 是一个很常见的数据结构类型,前段时间阿里的面试官说只要搞懂了HashTable,hashMap,HashSet,treeMap,treeSet这几个数据结构,阿里的数据结构面试没问 ...
- HBase介绍(2)---数据存储结构
在本文中的HBase术语:基于列:column-oriented行:row列组:column families列:column单元:cell 理解HBase(一个开源的Google的BigTable实 ...
- Redis之数据存储结构
今天去中关村软件园面试,被问到:你做项目用到的Redis处理数据用的什么结构?顿时石化,”用到的结构,不就是key-value嘛,还有什么结构?“.面试官说:“平时除了工作,要加强学习,下面的面试我觉 ...
- mysql之innodb存储引擎---数据存储结构
一.背景 1.1文件组织架构 首先看一下mysql数据系统涉及到的文件组织架构,如下图所示: msyql文件组织架构图 从图看出: 1.日志文件:slow.log(慢日志),error.log(错误日 ...
随机推荐
- Download google drive public shared file in terminal
http://unix.stackexchange.com/questions/136371/how-to-download-a-folder-from-google-drive-using-term ...
- cannot open clipboard 解决办法
对于电脑本身或者一些应用程序操作的时候,会出现cannot open clipboard的问题,这是你系统没有剪切板程序 首先: 在开始->运行中输入clipbrd 回车, 如果系统弹出了剪切板 ...
- react 闲谈 之 JSX
jsx元素-> React.createElement -> 虚拟dom对象 -> render方法 1.在react中想将js当作变了引入到jsx中需要使用{} 2.在jsx中,相 ...
- Android 美团Robust热更新 使用入门
Android热更新方案Robust 相信很多人都认识了解过 热修复.热更新.热补丁(对于这个技术也没有特别标准的一种叫法,下面我统一叫热更新),之后的一年里,各种热更新方案如雨后春笋般出现,比较耳熟 ...
- Mac下mysql服务端密码重置及环境配置
一 停止mysql服务 关闭MySQL服务的操作: 苹果->系统偏好设置->最下边点MySQL 在弹出页面中 关闭mysql服务(点击stop mysql server) 二 进入终端,命 ...
- LC 970. Powerful Integers
Given two non-negative integers x and y, an integer is powerful if it is equal to x^i + y^j for some ...
- 大数据HIve
1. 题目说明 设计题:MySQL数据库A有1000w条数据,完成统计再输入到另外的B表中 A表 test1 0.2,3.5,1,1test1 1.2,2.3,4.56test2 2.1,0.3,9. ...
- postgres serial创建自增列
Sequence是数据库中一类特殊的对象,其用于生成唯一数字标识符.一个典型的应用场景就是手动生成一系列主键.Sequence和MySQL中的AUTO_INCREMENT的概念很像. 创建序列Sequ ...
- charles修改响应体
一.修改响应体(只要勾选了主导航Tools--rewrite之后,则请求会一直被修改) 目的:需要测试数据为空,为纯英文,纯数字等多种情况,为了不麻烦后端的技术人员一支来配置,那么咱们就可以改造数据啦 ...
- Python multiprocess模块(下)
主要内容:(参考资料) 一. 管道 二. 数据共享 数据共享是不安全的 三. 进程池 进程池的map传参 进程池的同步方法 进程池的异步方法 详解apply和apply_async apply_asy ...