
0809MySQL实战系列:大字段如何优化|数据存储结构
转自https://yq.aliyun.com/articles/59256?spm=5176.100239.blogcont59257.9.5MLR2d
摘要: 背景 线上发现一张表,1亿的数据量,物理大小尽然惊人的大,1.2T 最终发现,原来有很多字段,10个varchar,1个text 这么大的表,会给运维带来很大的痛苦:DDL咋办?恢复咋办?备份咋办? 基本知识:InnoDB Storage Architecture for InnoDB On
背景
线上发现一张表,1亿的数据量,物理大小尽然惊人的大,1.2T
最终发现,原来有很多字段,10个varchar,1个text
这么大的表,会给运维带来很大的痛苦:DDL咋办?恢复咋办?备份咋办?
基本知识:InnoDB Storage Architecture for InnoDB On Disk Format
蓝图: database --> tablespaces --> pages --> rows --> columns
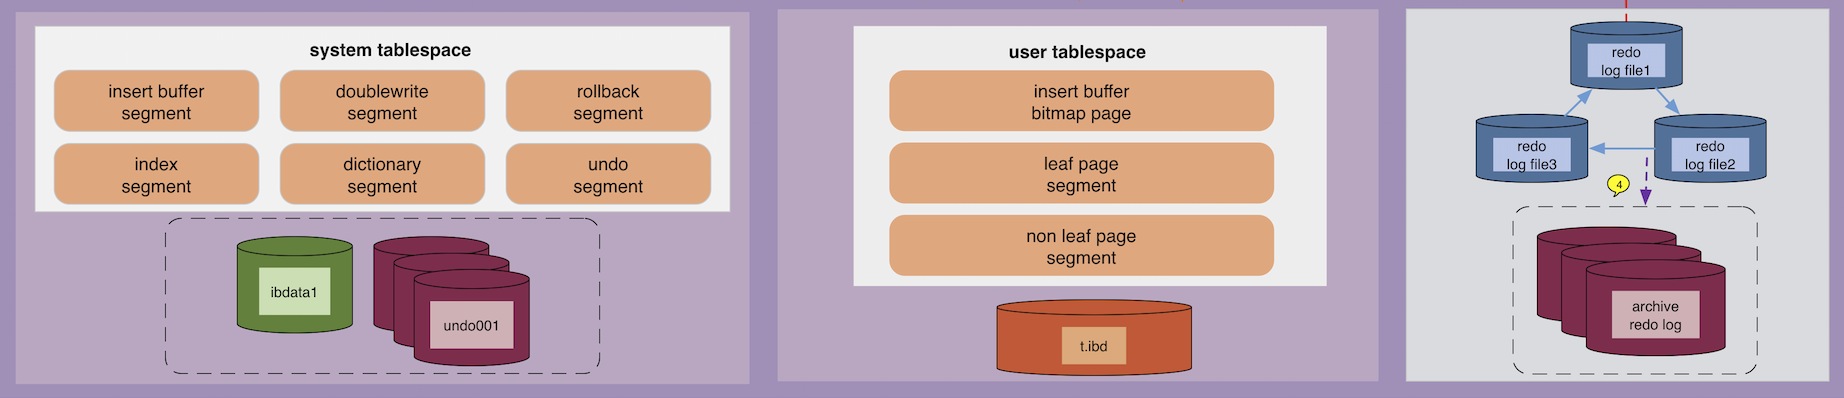
InnoDB 物理结构存储结构
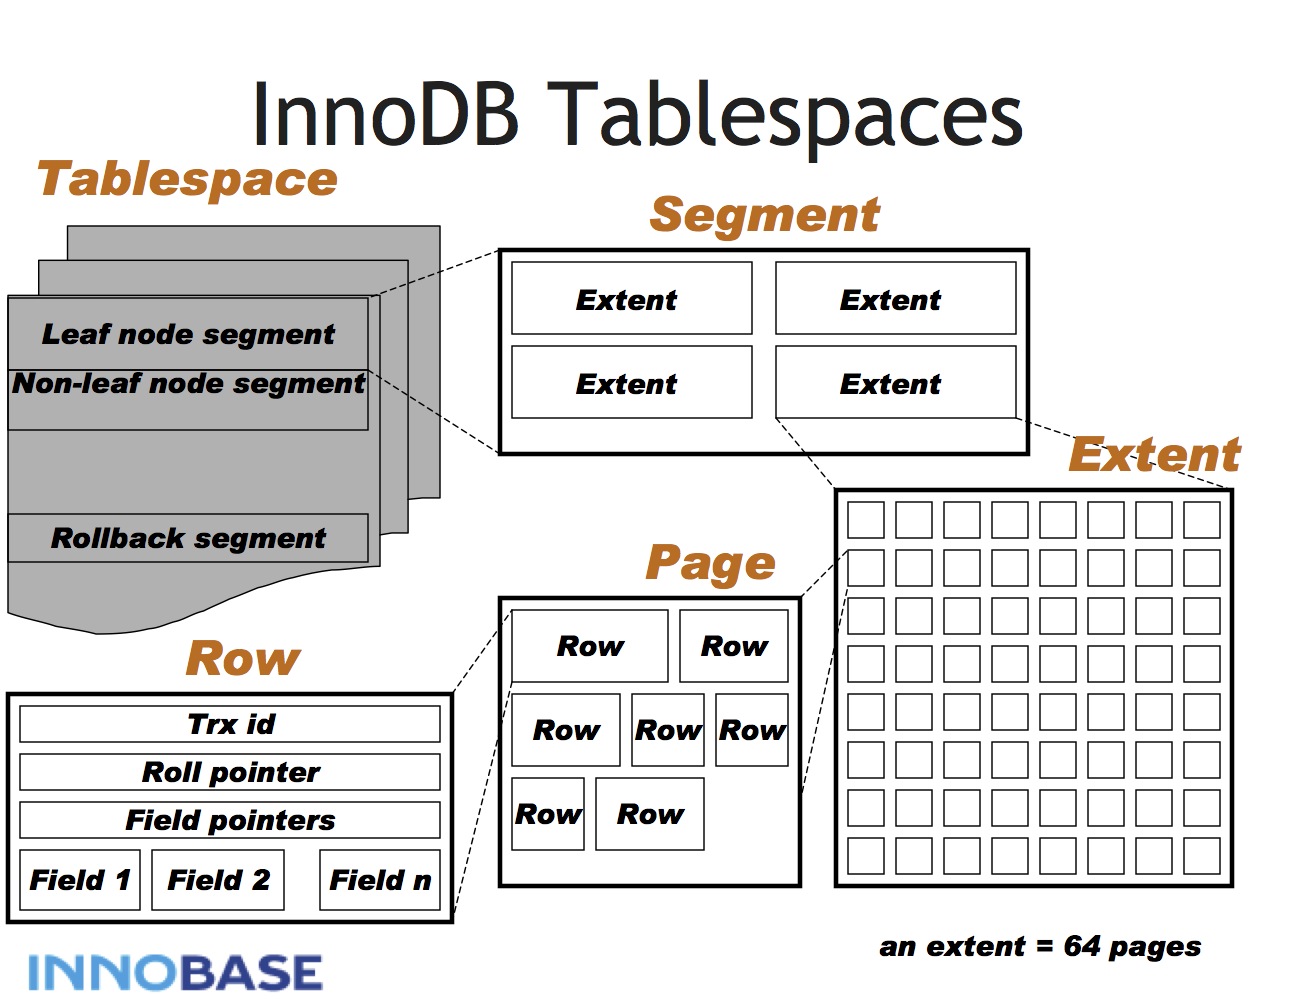
InnoDB 逻辑存储结构
InnoDB page 存储结构
页类型
数据页(B-tree Node)
undo页(undo Log Page)
系统页(System Page)
事务数据页(Transaction system Page)
插入缓冲位图页(Insert Buffer Page)
未压缩的二进制大对象页(Uncompressd BLOB Page)
压缩的二进制大对象页(compressd BLOB Page)
页大小
默认16k(若果没有特殊情况,下面介绍的都是默认16k大小为准)
一个页内必须存储2行记录,否则就不是B+tree,而是链表了
结构图

InnoDB row 存储结构
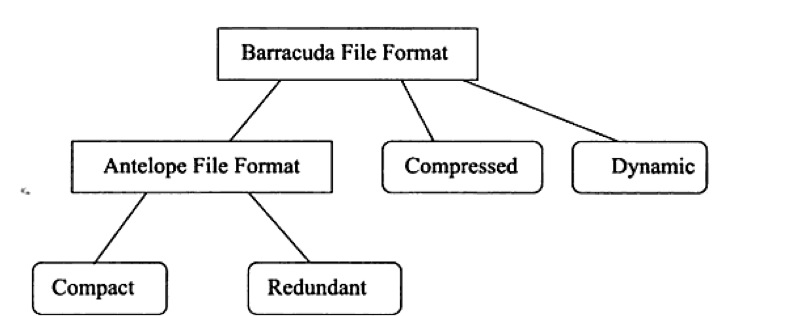
rows 文件格式总体规划图
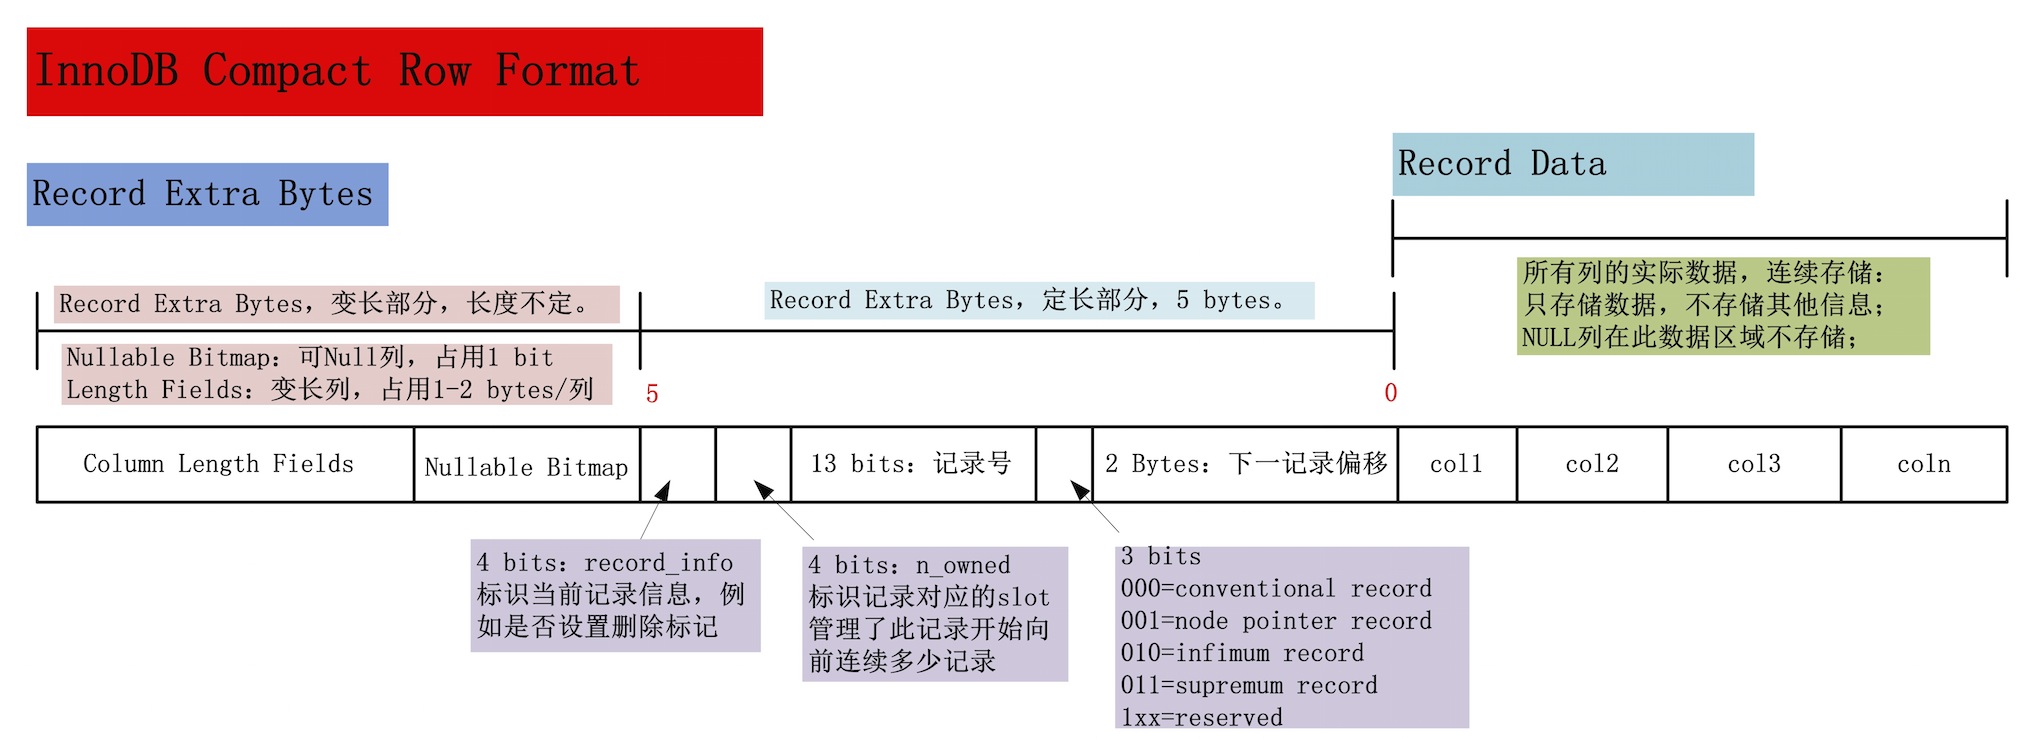
row-fomat为Compact的结构图
row-fomat为Redundant的结构图
不常用
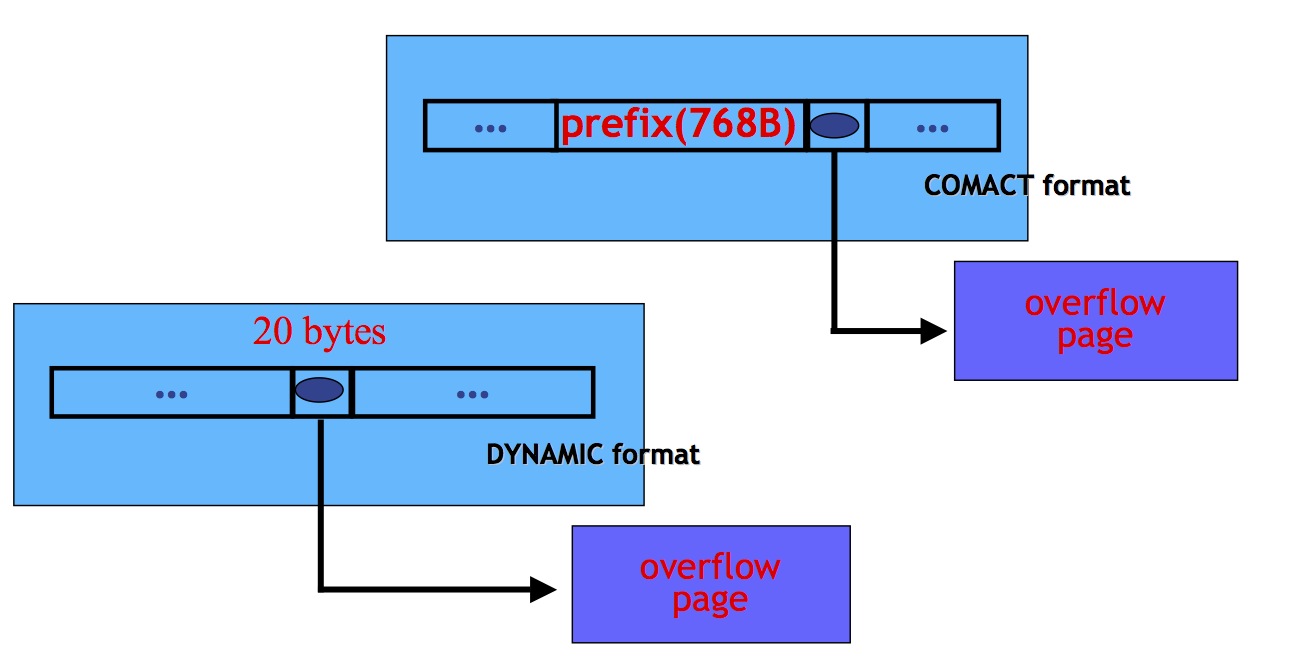
compress & dynamic 与 Compact 的区别之处
字段之字符串类型
char(N) vs varchar(N)
不管是char,还是varchar,在compact row-format格式下,NULL都不占用任何存储空间
在多字节字符集的情况下,CHAR vs VARCHAR 的实际行存储基本没区别
CHAR不管是否是多字符集,对未能占满长度的字符还是会填充0x20
规范中:对char和varchar可以不做要求
varchar(N) : 255 vs 256
当实际长度大于255的时候,变长字段长度列表需要用两个字节存储,也就意味着每一行数据都会增加1个字节
实测下来存储空间增长并不算大,且性能影响也不大,所以,尽量在256之内吧
varchar(N) & char(N) 的最大限制
char的最大限制是: N<=255
varchar 的最大限制是: N<=65535 , 注意官方文档说的是N是字节,并且说的是一行的所有字段的总和小于65535,而varchar(N)中的N表示的是字符。
测试后发现,65535并不是最大限制,最大的限制是65532
[MySQL 5.6.27]

* char的最大限制是: N<=255

root:test> create table test( a char(65535))charset=latin1 engine=innodb;

ERROR 1074 (42000): Column length too big for column 'a' (max = 255); use BLOB or TEXT instead

* 测试后发现,65535并不是最大限制,最大的限制是65532

root:test> create table test( a varchar(65535))charset=latin1 engine=innodb;

ERROR 1118 (42000): Row size too large. The maximum row size for the used table type, not counting BLOBs, is 65535. This includes storage overhead, check the manual. You have to change some columns to TEXT or BLOBs

root:test> create table test( a varchar(65532))charset=latin1 engine=innodb;

Query OK, 0 rows affected (0.00 sec)

* varchar 的最大限制是: N<=65535 , 注意官方文档说的是N是字节,并且说的是一行的所有字段的总和小于65535,而varchar(N)中的N表示的是字符

root:test> create table test_1( a varchar(30000),b varchar(30000),c varchar(5535))charset=latin1 engine=innodb;

ERROR 1118 (42000): Row size too large. The maximum row size for the used table type, not counting BLOBs, is 65535. This includes storage overhead, check the manual. You have to change some columns to TEXT or BLOBs

* varchar(N)中的N表示的是字符

root:test> create table test_1( a varchar(50000))charset=utf8 engine=innodb;

Query OK, 0 rows affected, 1 warning (0.00 sec)

root:test> show warnings;

+-------+------+--------------------------------------------+

| Level | Code | Message                                    |

+-------+------+--------------------------------------------+

| Note  | 1246 | Converting column 'a' from VARCHAR to TEXT |

+-------+------+--------------------------------------------+

1 row in set (0.00 sec)

root:test> show create table test_1;

+--------+-------------------------------------------------------------------------------+

| Table  | Create Table                                                                  |

+--------+-------------------------------------------------------------------------------+

| test_1 | CREATE TABLE `test_1` (

  `a` mediumtext

) ENGINE=InnoDB DEFAULT CHARSET=utf8 |

+--------+-------------------------------------------------------------------------------+

1 row in set (0.00 sec)
off-page: 行溢出
- 为什么会有行溢出off-page这个概念呢
假设创建了一张表,里面有一个字段是a varchar(30000) , innoDB的页才16384个字节,如何存储的下呢?所以行溢出就来了嘛
- 如何看出行溢出了?
可以通过姜承尧写的工具查看
其中溢出的页有 Uncompressed BLOB Page: 243453
[root()@xx script]# python py_innodb_page_info.py t.ibd

Total number of page: 537344:

Insert Buffer Bitmap: 33

Freshly Allocated Page: 74040

File Segment inode: 1

B-tree Node: 219784

File Space Header: 1

扩展描述页: 32

Uncompressed BLOB Page: 243453
- 溢出有什么危害
溢出的数据不再存储在B+tree中
溢出的数据使用的是uncompress BLOB page,并且存储独享,这就是存储越来越大的真正原因
通过下面的测试,你会发现,t_long 插入的数据仅仅比 t_short 多了几个字节,但是最终的存储却是2~3倍的差距
* 表结构

root:test> show create table t_long;

+--------+---------------------------------------------------------------------------------------------------------+

| Table  | Create Table                                                                                            |

+--------+---------------------------------------------------------------------------------------------------------+

| t_long | CREATE TABLE `t_long` (

  `id` int(11) DEFAULT NULL,

  `col1` text

) ENGINE=InnoDB DEFAULT CHARSET=utf8 |

+--------+---------------------------------------------------------------------------------------------------------+

1 row in set (0.00 sec)

root:test> show create table t_short;

+---------+----------------------------------------------------------------------------------------------------------+

| Table   | Create Table                                                                                             |

+---------+----------------------------------------------------------------------------------------------------------+

| t_short | CREATE TABLE `t_short` (

  `id` int(11) DEFAULT NULL,

  `col1` text

) ENGINE=InnoDB DEFAULT CHARSET=utf8 |

+---------+----------------------------------------------------------------------------------------------------------+

1 row in set (0.00 sec)

* 测试案例

foreach $num (1 .. 48849){

        $sql_1 = "insert into $table_short select $num,repeat('a',8090)";

        $sql_2 = "insert into $table_long select $num,repeat('a',8098)";

        `$cmd -e " $sql_1 "`;

        `$cmd -e " $sql_2 "`;

}

* 最终的记录数

root:test> select count(*) from t_short;

+----------+

| count(*) |

+----------+

|    48849 |

+----------+

1 row in set (0.03 sec)

root:test> select count(*) from t_long;

+----------+

| count(*) |

+----------+

|    48849 |

+----------+

1 row in set (0.02 sec)

* 页类型的比较

[root()@xx script]# python py_innodb_page_info.py /data/mysql_data/test/t_short.ibd

Total number of page: 25344:

Insert Buffer Bitmap: 2

Freshly Allocated Page: 887

File Segment inode: 1

B-tree Node: 24452

File Space Header: 1

扩展描述页: 1

[root()@xx script]# python py_innodb_page_info.py /data/mysql_data/test/t_long.ibd

Total number of page: 60160:

Insert Buffer Bitmap: 4

Freshly Allocated Page: 8582

File Segment inode: 1

B-tree Node: 2720

File Space Header: 1

扩展描述页: 3

Uncompressed BLOB Page: 48849

* 最终大小的对比

[root()@xx test]# du -sh * | grep 'long\|short' | grep ibd

941M    t_long.ibd

397M    t_short.ibd

* 结论

t_short 的表,在400M左右可以理解,因为 8k * 48849 = 400M

t_long 的表,由于独享48849个Uncompressed BLOB Page,严重浪费空间
- 什么情况下会溢出
原则:只要一行记录的总和超过8k,就会溢出。
所以:varchar(9000) 或者 varchar(3000) + varchar(3000) + varchar(3000),当实际长度大于8k的时候,就会溢出
所以:Blob,text,一行数据如果实际长度大于8k会溢出,如果实际长度小于8k则不会溢出,并非所有的blob,text都会溢出
- 多列总和大字段 vs 一列大字段
多个大字段会导致多次off-page
root:test> show create table t_3_col;

+---------+-------------------------------------------------------------------------------------------------------------------------------------------------------------------

---------------------------------------+

| Table   | Create Table

                                       |

+---------+-------------------------------------------------------------------------------------------------------------------------------------------------------------------

---------------------------------------+

| t_3_col | CREATE TABLE `t_3_col` (

  `id` int(11) DEFAULT NULL,

  `col1` varchar(7000) DEFAULT NULL,

  `col2` varchar(7000) DEFAULT NULL,

  `col3` varchar(7000) DEFAULT NULL

) ENGINE=InnoDB DEFAULT CHARSET=utf8 |

+---------+-------------------------------------------------------------------------------------------------------------------------------------------------------------------

---------------------------------------+

1 row in set (0.00 sec)

root:test> show create table t_1_col;

+---------+---------------------------------------------------------------------------------------------------------------------------------+

| Table   | Create Table                                                                                                                    |

+---------+---------------------------------------------------------------------------------------------------------------------------------+

| t_1_col | CREATE TABLE `t_1_col` (

  `id` int(11) DEFAULT NULL,

  `col1` varchar(21000) DEFAULT NULL

) ENGINE=InnoDB DEFAULT CHARSET=utf8 |

+---------+---------------------------------------------------------------------------------------------------------------------------------+

1 row in set (0.00 sec)

root:test>

root:test>

root:test> insert into t_1_col(col1) select repeat('a',21000);

Query OK, 1 row affected (0.00 sec)

Records: 1  Duplicates: 0  Warnings: 0

root:test>

root:test>

root:test> insert into t_3_col(col1,col2,col3) select repeat('a',7000),repeat('a',7000),repeat('a',7000);

Query OK, 1 row affected (0.00 sec)

Records: 1  Duplicates: 0  Warnings: 0

[root()@xx script]# python py_innodb_page_info.py /data/mysql_data/test/t_1_col.ibd

Total number of page: 6:

Insert Buffer Bitmap: 1

Uncompressed BLOB Page: 2

File Space Header: 1

B-tree Node: 1

File Segment inode: 1

[root()@xx script]# python py_innodb_page_info.py /data/mysql_data/test/t_3_col.ibd

Total number of page: 7:

Insert Buffer Bitmap: 1

Uncompressed BLOB Page: 3

File Space Header: 1

B-tree Node: 1

File Segment inode: 1
如何对大字段进行优化
如果有多个大字段,尽量序列化后,存储在同一列中,避免多次off-page
将text等大字段从主表中拆分出来,a)存储到key-value中 b)存储在单独的一张子表中,并且压缩
必须保证一行记录小于8k
0809MySQL实战系列:大字段如何优化|数据存储结构的更多相关文章
- memcached实战系列(六)理解Memcached的数据存储方式
Memcached的数据存储方式被称为Slab Allocator,其基本方式是: 1:先把内存分成很多个Slab,这个大小是预先规定好的,以解决内存碎片的问题.启动参数的时候配置进去的不懂得可以参考 ...
- 【mysql】关于InnoDB表text blob大字段的优化
最近在数据库优化的时候,看到一些表在设计上使用了text或者blob的字段,单表的存储空间已经达到了近100G,这种情况再去改变和优化就非常难了 一.简介 为了清楚大字段对性能的影响,我们必须要知道i ...
- ByteArrary(优化数据存储和数据流)
原地址:http://www.unity蛮牛.com/blog-1801-799.html 首页 博客 相册 主题 留言板 个人资料 ByteArrary(优化数据存储和数据流) 分类:unity ...
- Spring Boot干货系列:(八)数据存储篇-SQL关系型数据库之JdbcTemplate的使用
Spring Boot干货系列:(八)数据存储篇-SQL关系型数据库之JdbcTemplate的使用 原创 2017-04-13 嘟嘟MD 嘟爷java超神学堂 前言 前面几章介绍了一些基础,但都是静 ...
- Berkeley DB的数据存储结构——哈希表(Hash Table)、B树(BTree)、队列(Queue)、记录号(Recno)
Berkeley DB的数据存储结构 BDB支持四种数据存储结构及相应算法,官方称为访问方法(Access Method),分别是哈希表(Hash Table).B树(BTree).队列(Queue) ...
- kafka 数据存储结构+原理+基本操作命令
数据存储结构: Kafka中的Message是以topic为基本单位组织的,不同的topic之间是相互独立的.每个topic又可以分成几个不同的partition(每个topic有几个partitio ...
- Cassandra 的数据存储结构——本质是SortedMap<RowKey, SortedMap<ColumnKey, ColumnValue>>
Cassandra 的数据存储结构 Cassandra 的数据模型是基于列族(Column Family)的四维或五维模型.它借鉴了 Amazon 的 Dynamo 和 Google's BigTab ...
- memcached实战系列(七)理解Memcached的数据过期方式、新建过程、查找过程
1.1.1. 新建Item分配内存过程 1:快速定位slab classid,先计算Item长度 key键长+flag+suffix(16字节)+value值长+结构大小(32字节),如90byte ...
- Redis之数据存储结构
今天去中关村软件园面试,被问到:你做项目用到的Redis处理数据用的什么结构?顿时石化,”用到的结构,不就是key-value嘛,还有什么结构?“.面试官说:“平时除了工作,要加强学习,下面的面试我觉 ...
随机推荐
- EOJ 3194 字符串消除
给定一个由大写字母’A’.’B’.’C’构成的字符串s,按如下进行消除过程: 1.字符串s中连续相同字母组成的子串,如果子串的长度大于1,那么这些子串会被同时消除,余下的字符拼成新的字符串. 例如:” ...
- bzoj2287【POJ Challenge】消失之物(退背包)
2287: [POJ Challenge]消失之物 Time Limit: 10 Sec Memory Limit: 128 MBSubmit: 657 Solved: 382[Submit][S ...
- python大杂铺
python中continue,break,return三者之间的区别 return 会直接令函数返回,所有该函数体内的代码都不再执行了,所以该函数体内的循环也不可能再继续运行. break:跳出 ...
- 记录一下Junit测试MongoDB,获取MongoTemplate
只是自己记录一下,测试MongoDB帮助类时,没有配置文件的测试 public class HelperTest { MongoTemplate template; @Before public vo ...
- BZOJ 4332 FFT+快速幂
思路: 最裸的方程:f[i][j]=Σf[i-1][j-k]*F[k] 诶呦 这不是卷积嘛 f[i]就可以用f[i-1]卷F 求到 但是这样还是很慢 设p[i] 为Σ f[j](1<=j< ...
- 2015 多校赛 第二场 1006 (hdu 5305)
Problem Description There are n people and m pairs of friends. For every pair of friends, they can c ...
- SnackDown Online Qualifier 2017
好久没做题了,然后就想着随便做一个.无奈cf都是晚上,然后就看见这个,随便做做. 资格赛,只要做出来1题就行了,4天的时间. 1. 水题 #include <iostream> #incl ...
- 利用windbg获取dump的dll文件
根据堆栈对应的地址查找其对应的Module ID,然后将对应的Module保存. !IP2MD 命令从托管函数中获取 MethodDesc 结构地址. !dumpmodule 1caa50 下面的命令 ...
- NSLayoutConstraints加动画来改变约束
// // ViewController.m // NSLayoutAnimationDemo // // Created by ebaotong on 15/7/22. // Copyright ( ...
- linux ssh 经常断开 的解决方法
1.现象 在linux ,用ssh进行远程连接时,经常会发生长时间后断线,或者是无响应,就像卡住的感觉(键盘输入不进去). 2.解决方法 在ssh客户端的linux设置 # sudo vim /etc ...