
『TensorFlow』网络操作API_中_损失函数及分类器

一、误差值
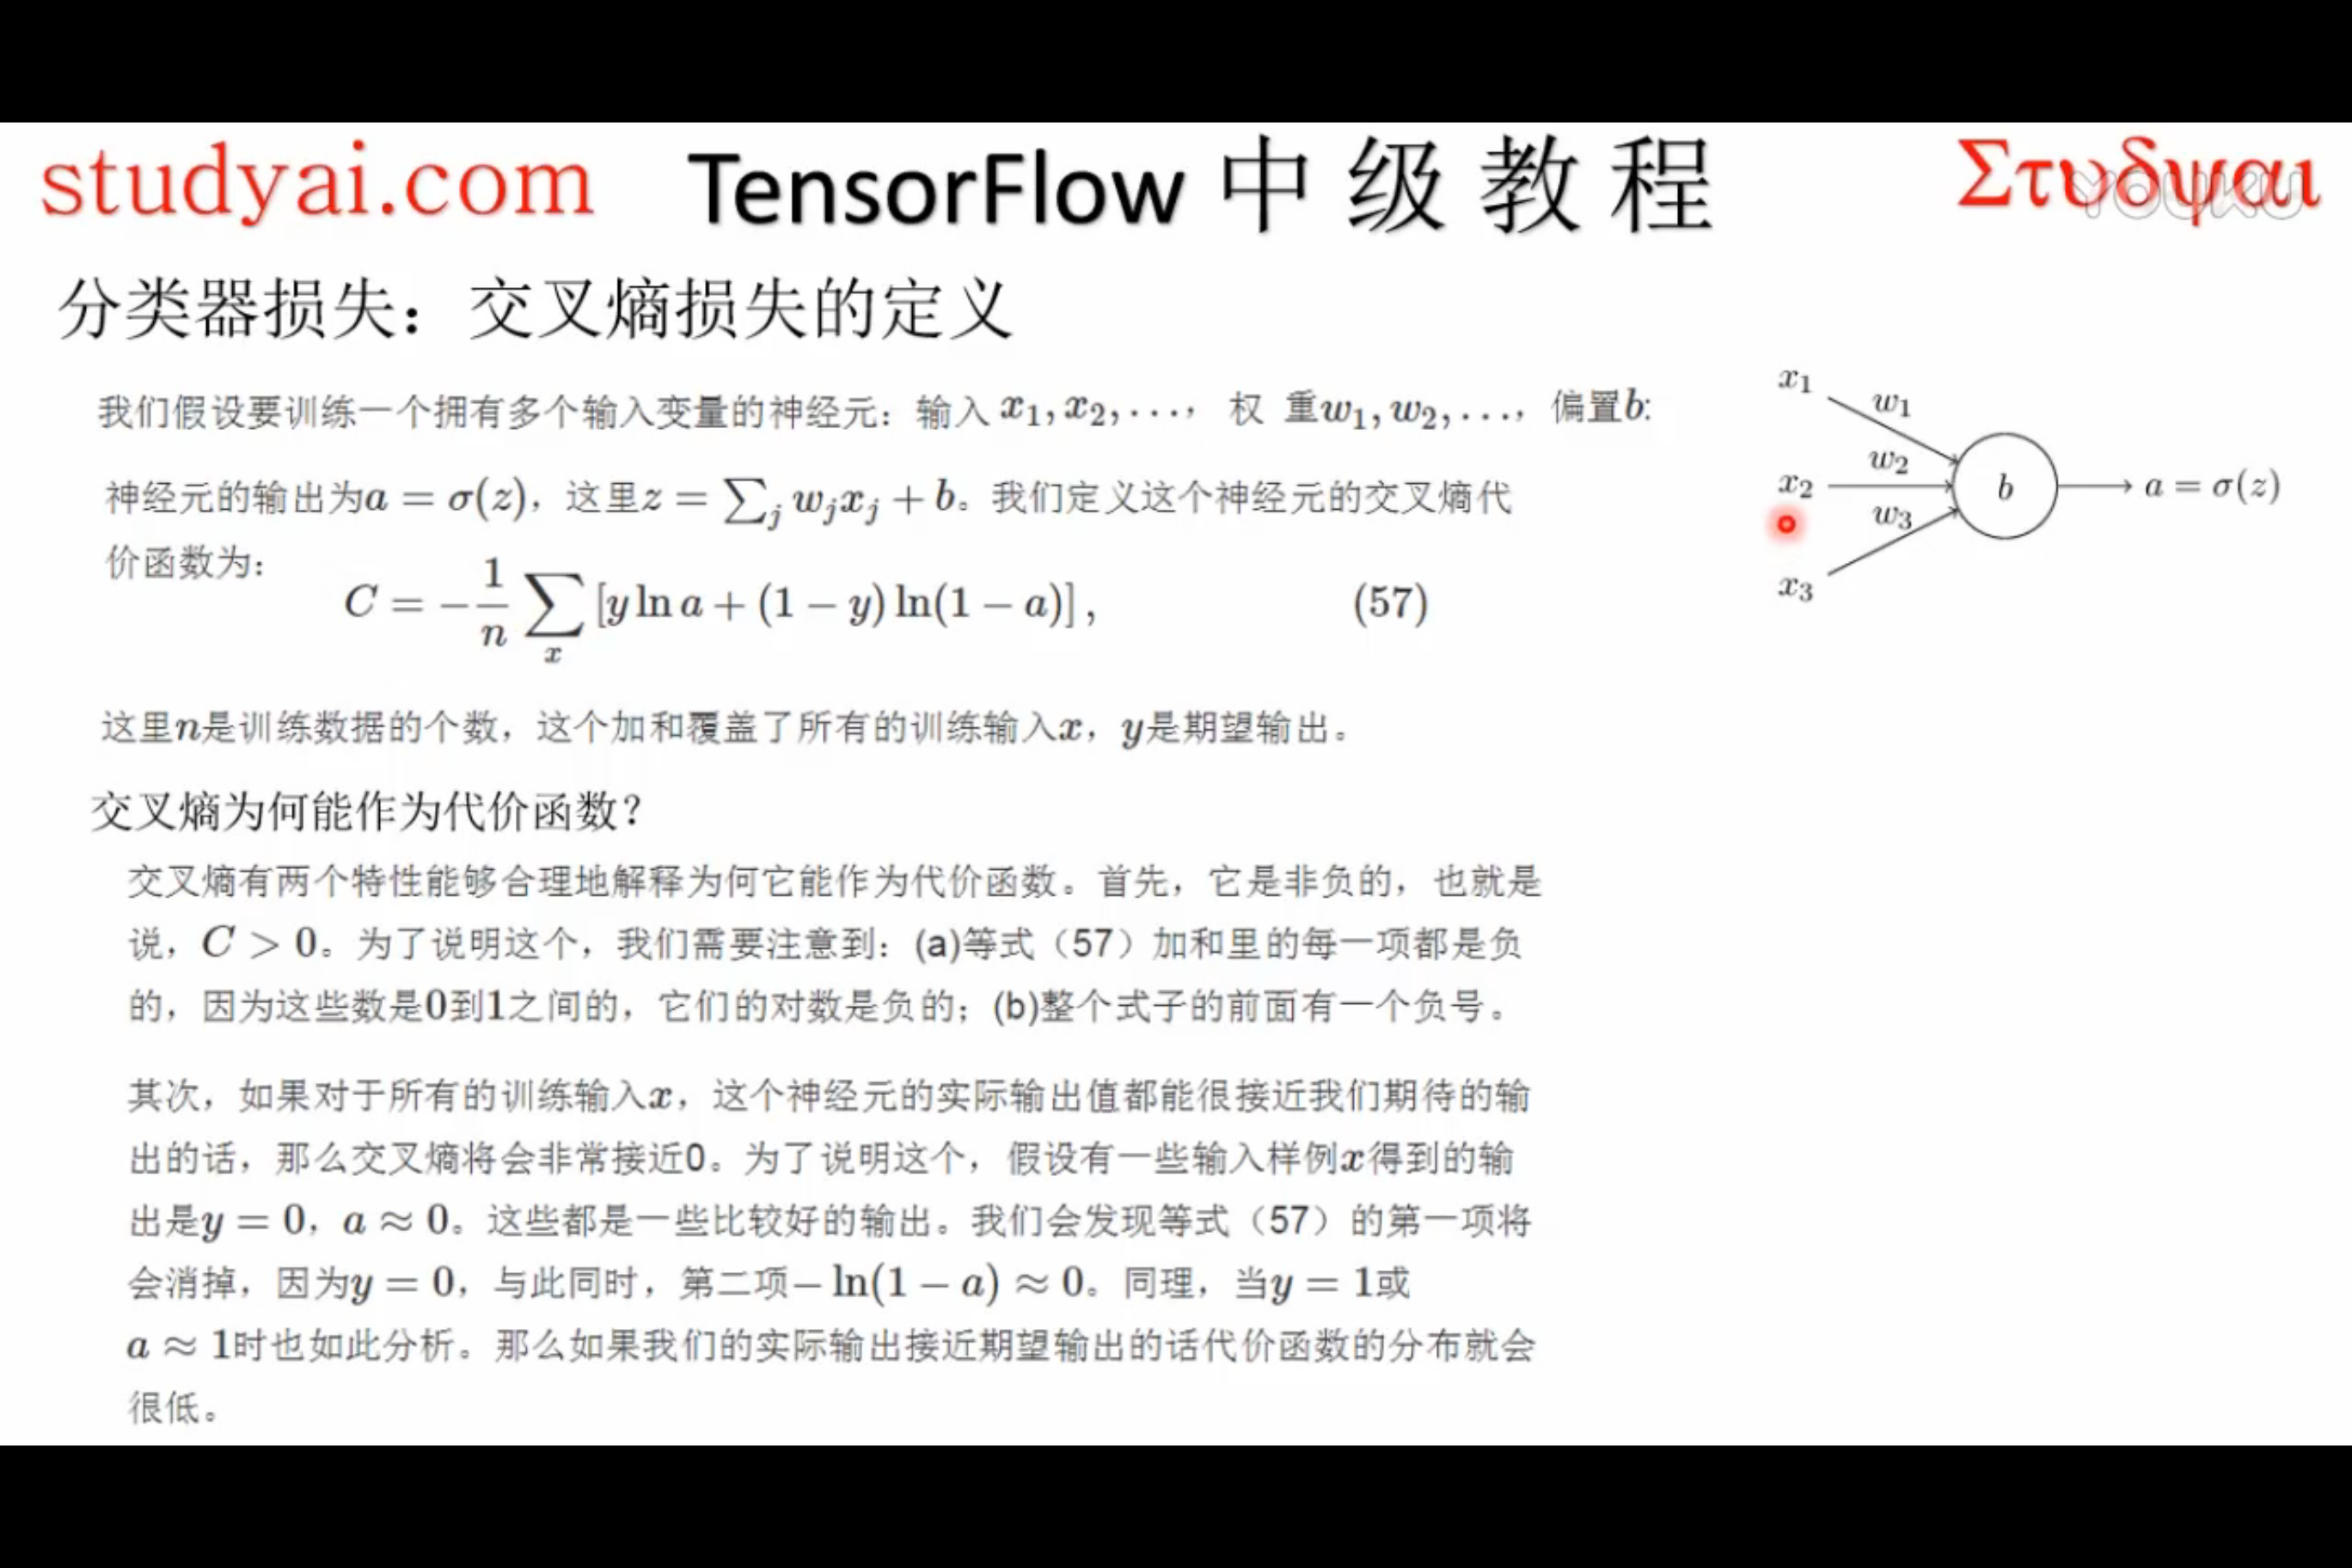
度量两个张量或者一个张量和零之间的损失误差,这个可用于在一个回归任务或者用于正则的目的(权重衰减)。
l2_loss
tf.nn.l2_loss(t, name=None)解释:这个函数的作用是利用 L2 范数来计算张量的误差值,但是没有开方并且只取 L2 范数的值的一半,具体如下:
output = sum(t ** 2) / 2输入参数:
t: 一个Tensor。数据类型必须是一下之一:float32,float64,int64,int32,uint8,int16,int8,complex64,qint8,quint8,qint32。虽然一般情况下,数据维度是二维的。但是,数据维度可以取任意维度。name: 为这个操作取个名字。输出参数:
一个
Tensor,数据类型和t相同,是一个标量。
使用例子
#!/usr/bin/env python

# -*- coding: utf-8 -*-

import numpy as np

import tensorflow as tf

input_data = tf.Variable( np.random.rand(2, 3), dtype = tf.float32 )

output = tf.nn.l2_loss(input_data)

with tf.Session() as sess:

    init = tf.initialize_all_variables()

    sess.run(init)

    print sess.run(input_data)

    print sess.run(output)

    print sess.run(tf.shape(output))
二、分类器
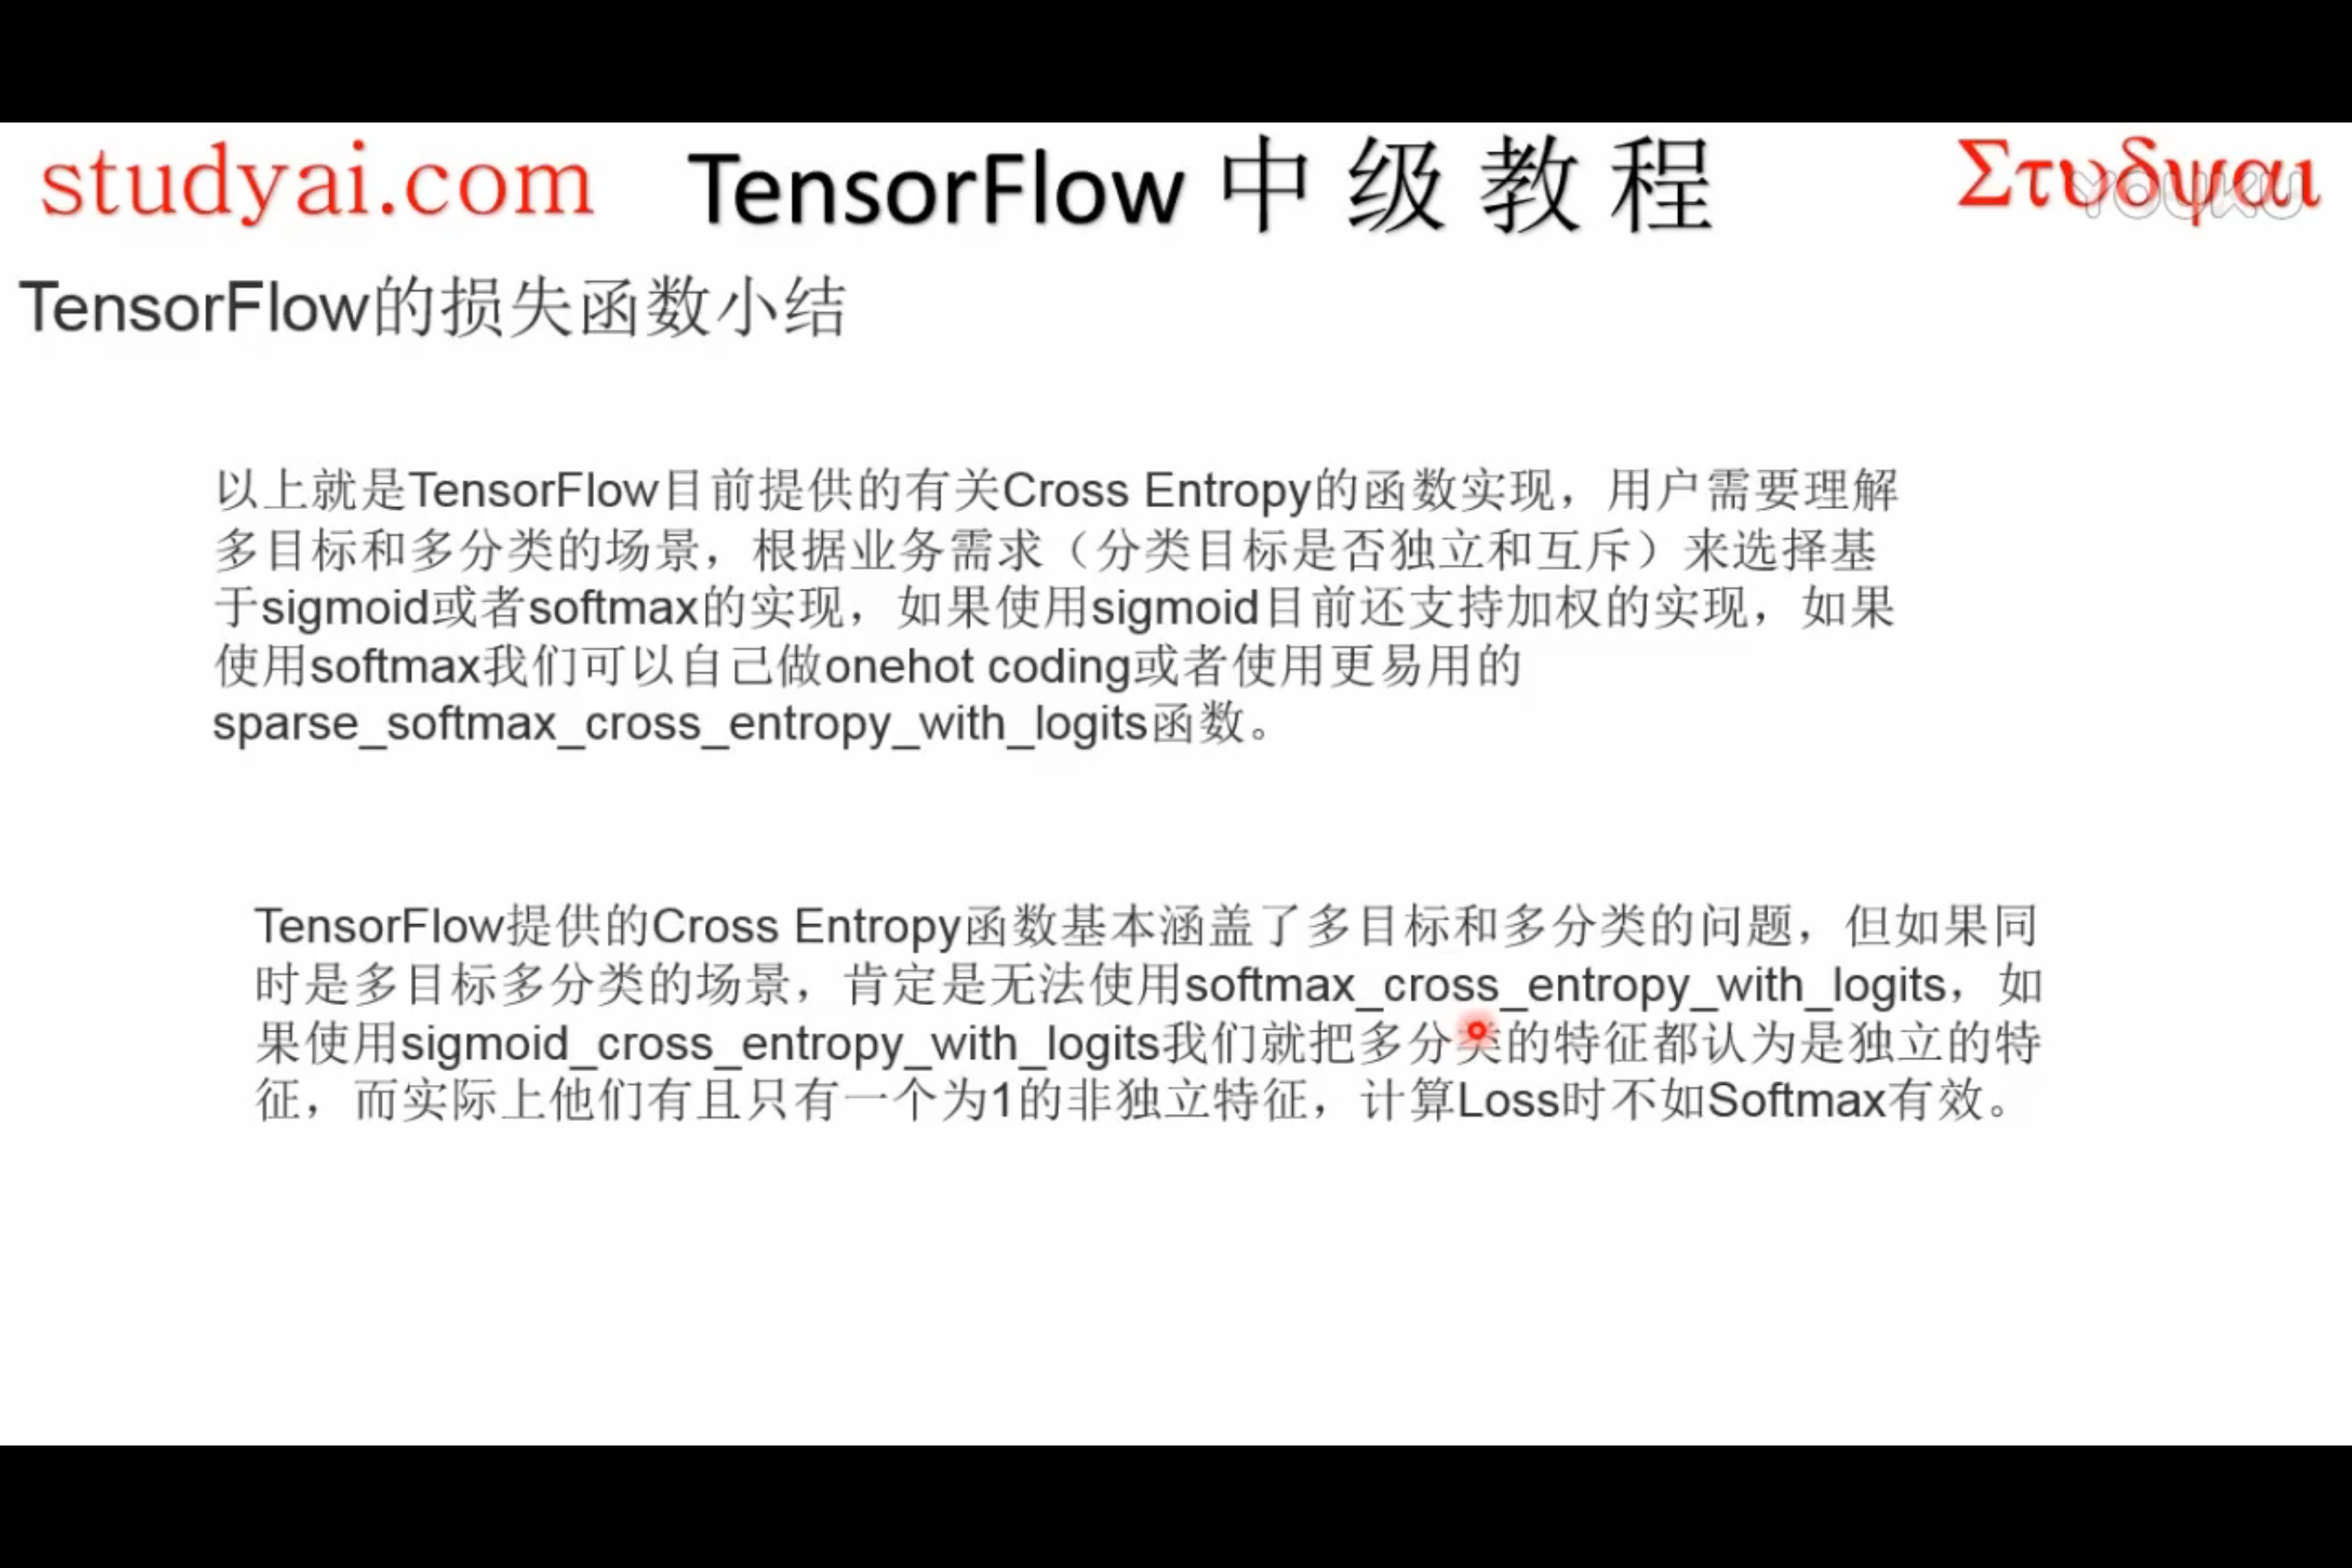
sigmoid_cross_entropy_with_logits
sigmoid_cross_entropy_with_logits
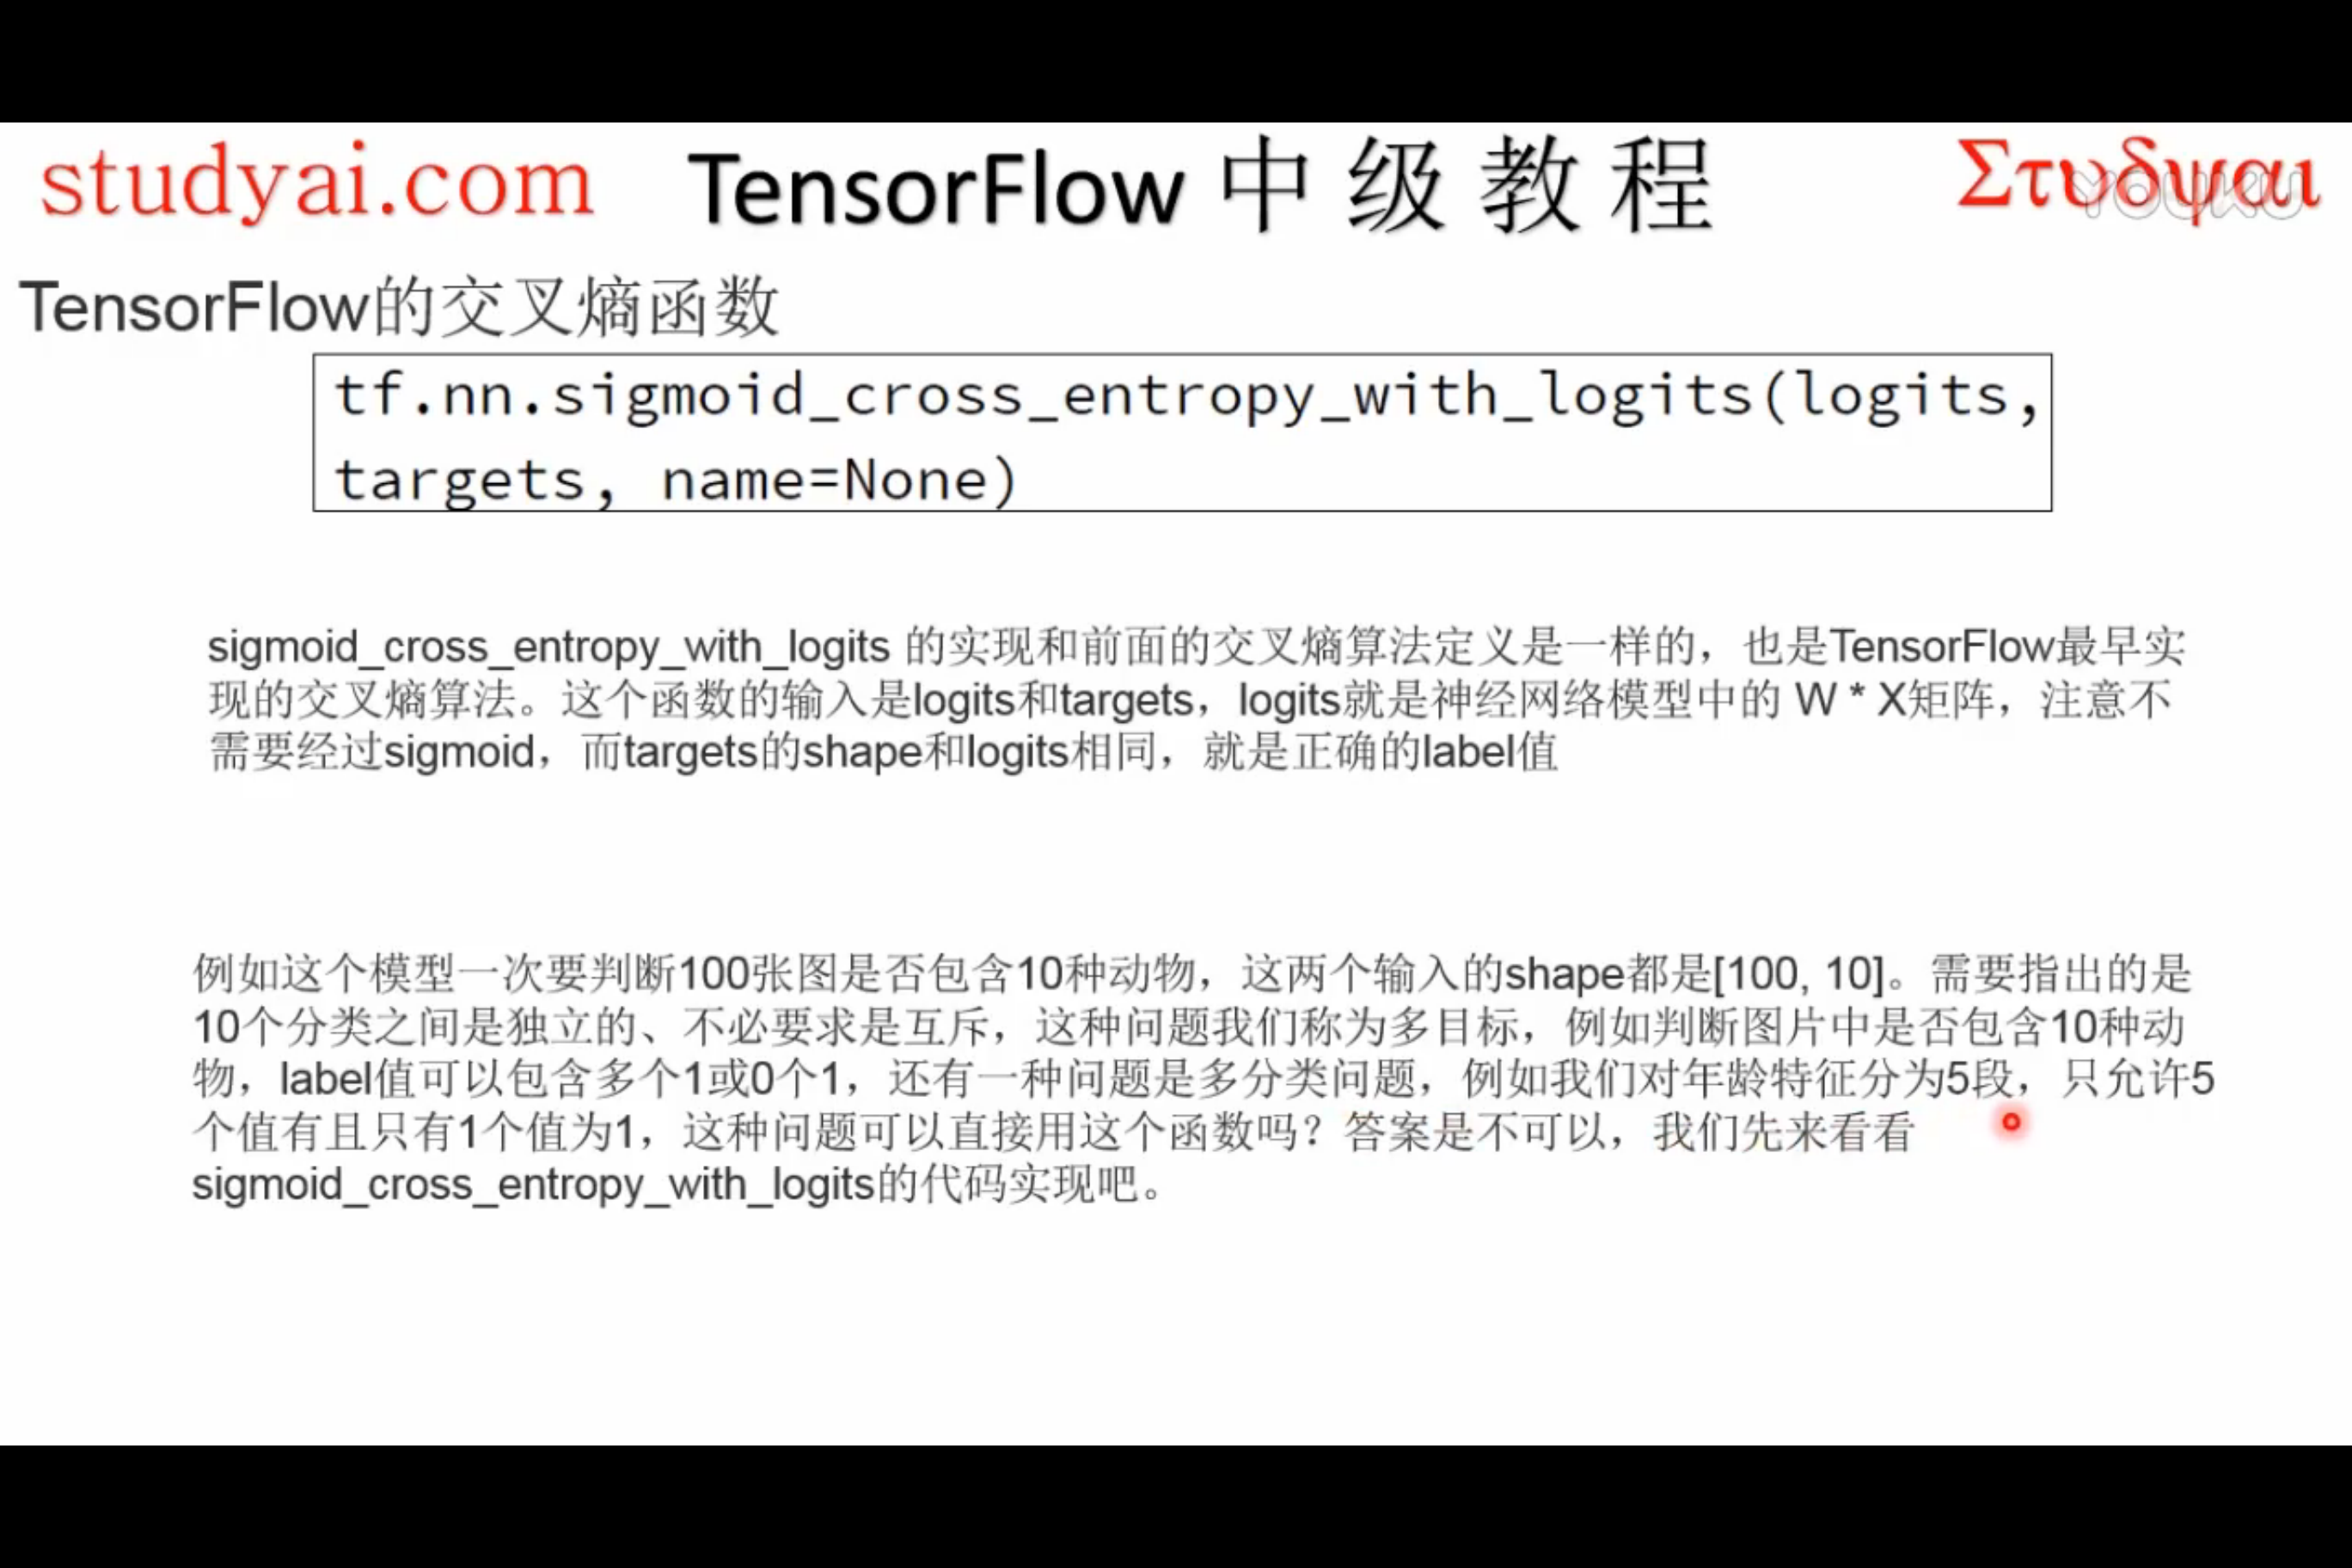
tf.nn.sigmoid_cross_entropy_with_logits(logits, targets, name=None)解释:这个函数的作用是计算
logits经 sigmoid 函数激活之后的交叉熵。对于一个不相互独立的离散分类任务,这个函数作用是去度量概率误差。比如,比如,在一张图片中,同时包含多个分类目标(大象和狗),那么就可以使用这个函数。
为了描述简洁,我们规定
x = logits,z = targets,那么 Logistic 损失值为:x - x * z + log( 1 + exp(-x) )为了确保计算稳定,避免溢出,真实的计算实现如下:
max(x, 0) - x * z + log(1 + exp(-abs(x)) )输入参数:
logits: 一个Tensor。数据类型是以下之一:float32或者float64。targets: 一个Tensor。数据类型和数据维度都和logits相同。name: 为这个操作取个名字。输出参数:
一个
Tensor,数据维度和logits相同。
使用例子:
#!/usr/bin/env python

# -*- coding: utf-8 -*-

import numpy as np

import tensorflow as tf

input_data = tf.Variable( np.random.rand(1,3), dtype = tf.float32 )

output = tf.nn.sigmoid_cross_entropy_with_logits(input_data, [[1.0,0.0,0.0]])

with tf.Session() as sess:

    init = tf.initialize_all_variables()

    sess.run(init)

    print sess.run(input_data)

    print sess.run(output)

    print sess.run(tf.shape(output))
早期使用,后来多使用softmax。
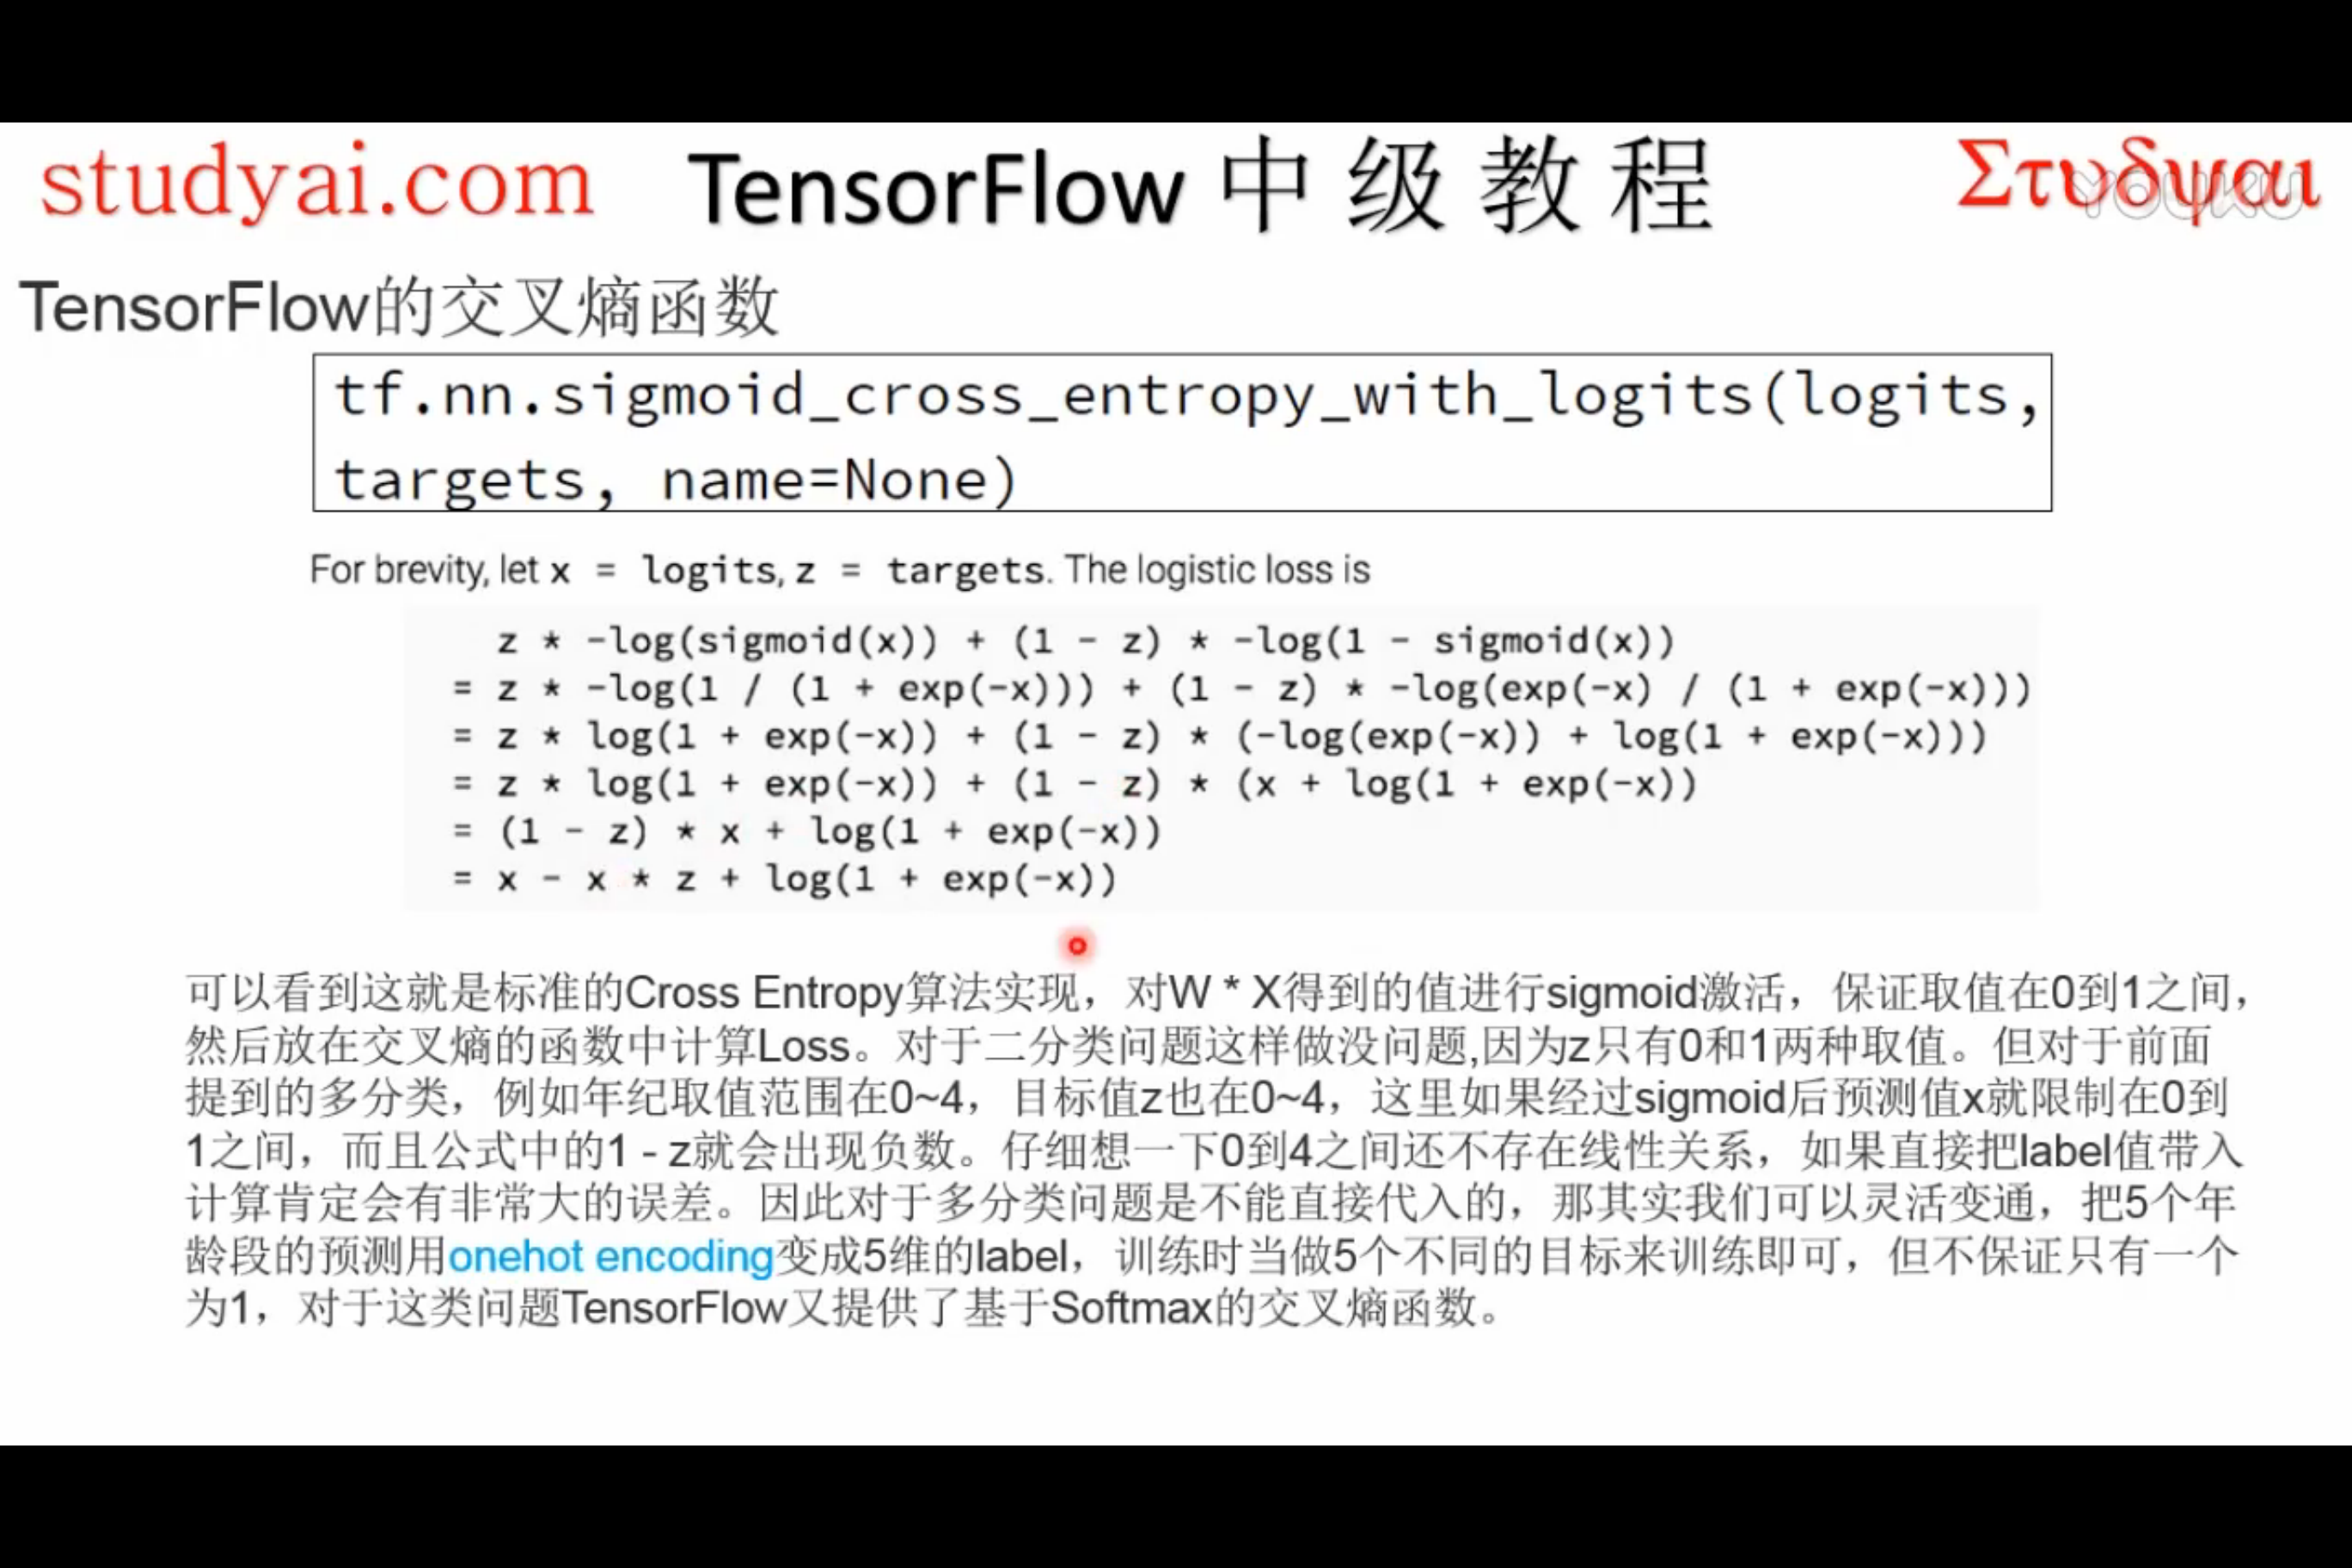
softmax
tf.nn.softmax(logits, name=None)解释:这个函数的作用是计算 softmax 激活函数。
对于每个批
i和 分类j,我们可以得到:softmax[i, j] = exp(logits[i, j]) / sum(exp(logits[i]))输入参数:
logits: 一个Tensor。数据类型是以下之一:float32或者float64。数据维度是二维[batch_size, num_classes]。name: 为这个操作取个名字。输出参数:
一个
Tensor,数据维度和数据类型都和logits相同。
使用例子:
#!/usr/bin/env python

# -*- coding: utf-8 -*-

import numpy as np

import tensorflow as tf

input_data = tf.Variable( [[0.2, 0.1, 0.9]] , dtype = tf.float32 )

output = tf.nn.softmax(input_data)

with tf.Session() as sess:

    init = tf.initialize_all_variables()

    sess.run(init)

    print sess.run(input_data)

    print sess.run(output)

    print sess.run(tf.shape(output))
log_softmax
tf.nn.log_softmax(logits, name=None)解释:这个函数的作用是计算 softmax 激活函数。
对于每个批
i和 分类j,我们可以得到:softmax[i, j] = log(exp(logits[i, j]) / sum(exp(logits[i])))输入参数:
logits: 一个Tensor。数据类型是以下之一:float32或者float64。数据维度是二维[batch_size, num_classes]。name: 为这个操作取个名字。输出参数:
一个
Tensor,数据维度和数据类型都和logits相同。
softmax_cross_entropy_with_logits
tf.nn.softmax_cross_entropy_with_logits(logits, labels, name=None)解释:这个函数的作用是计算
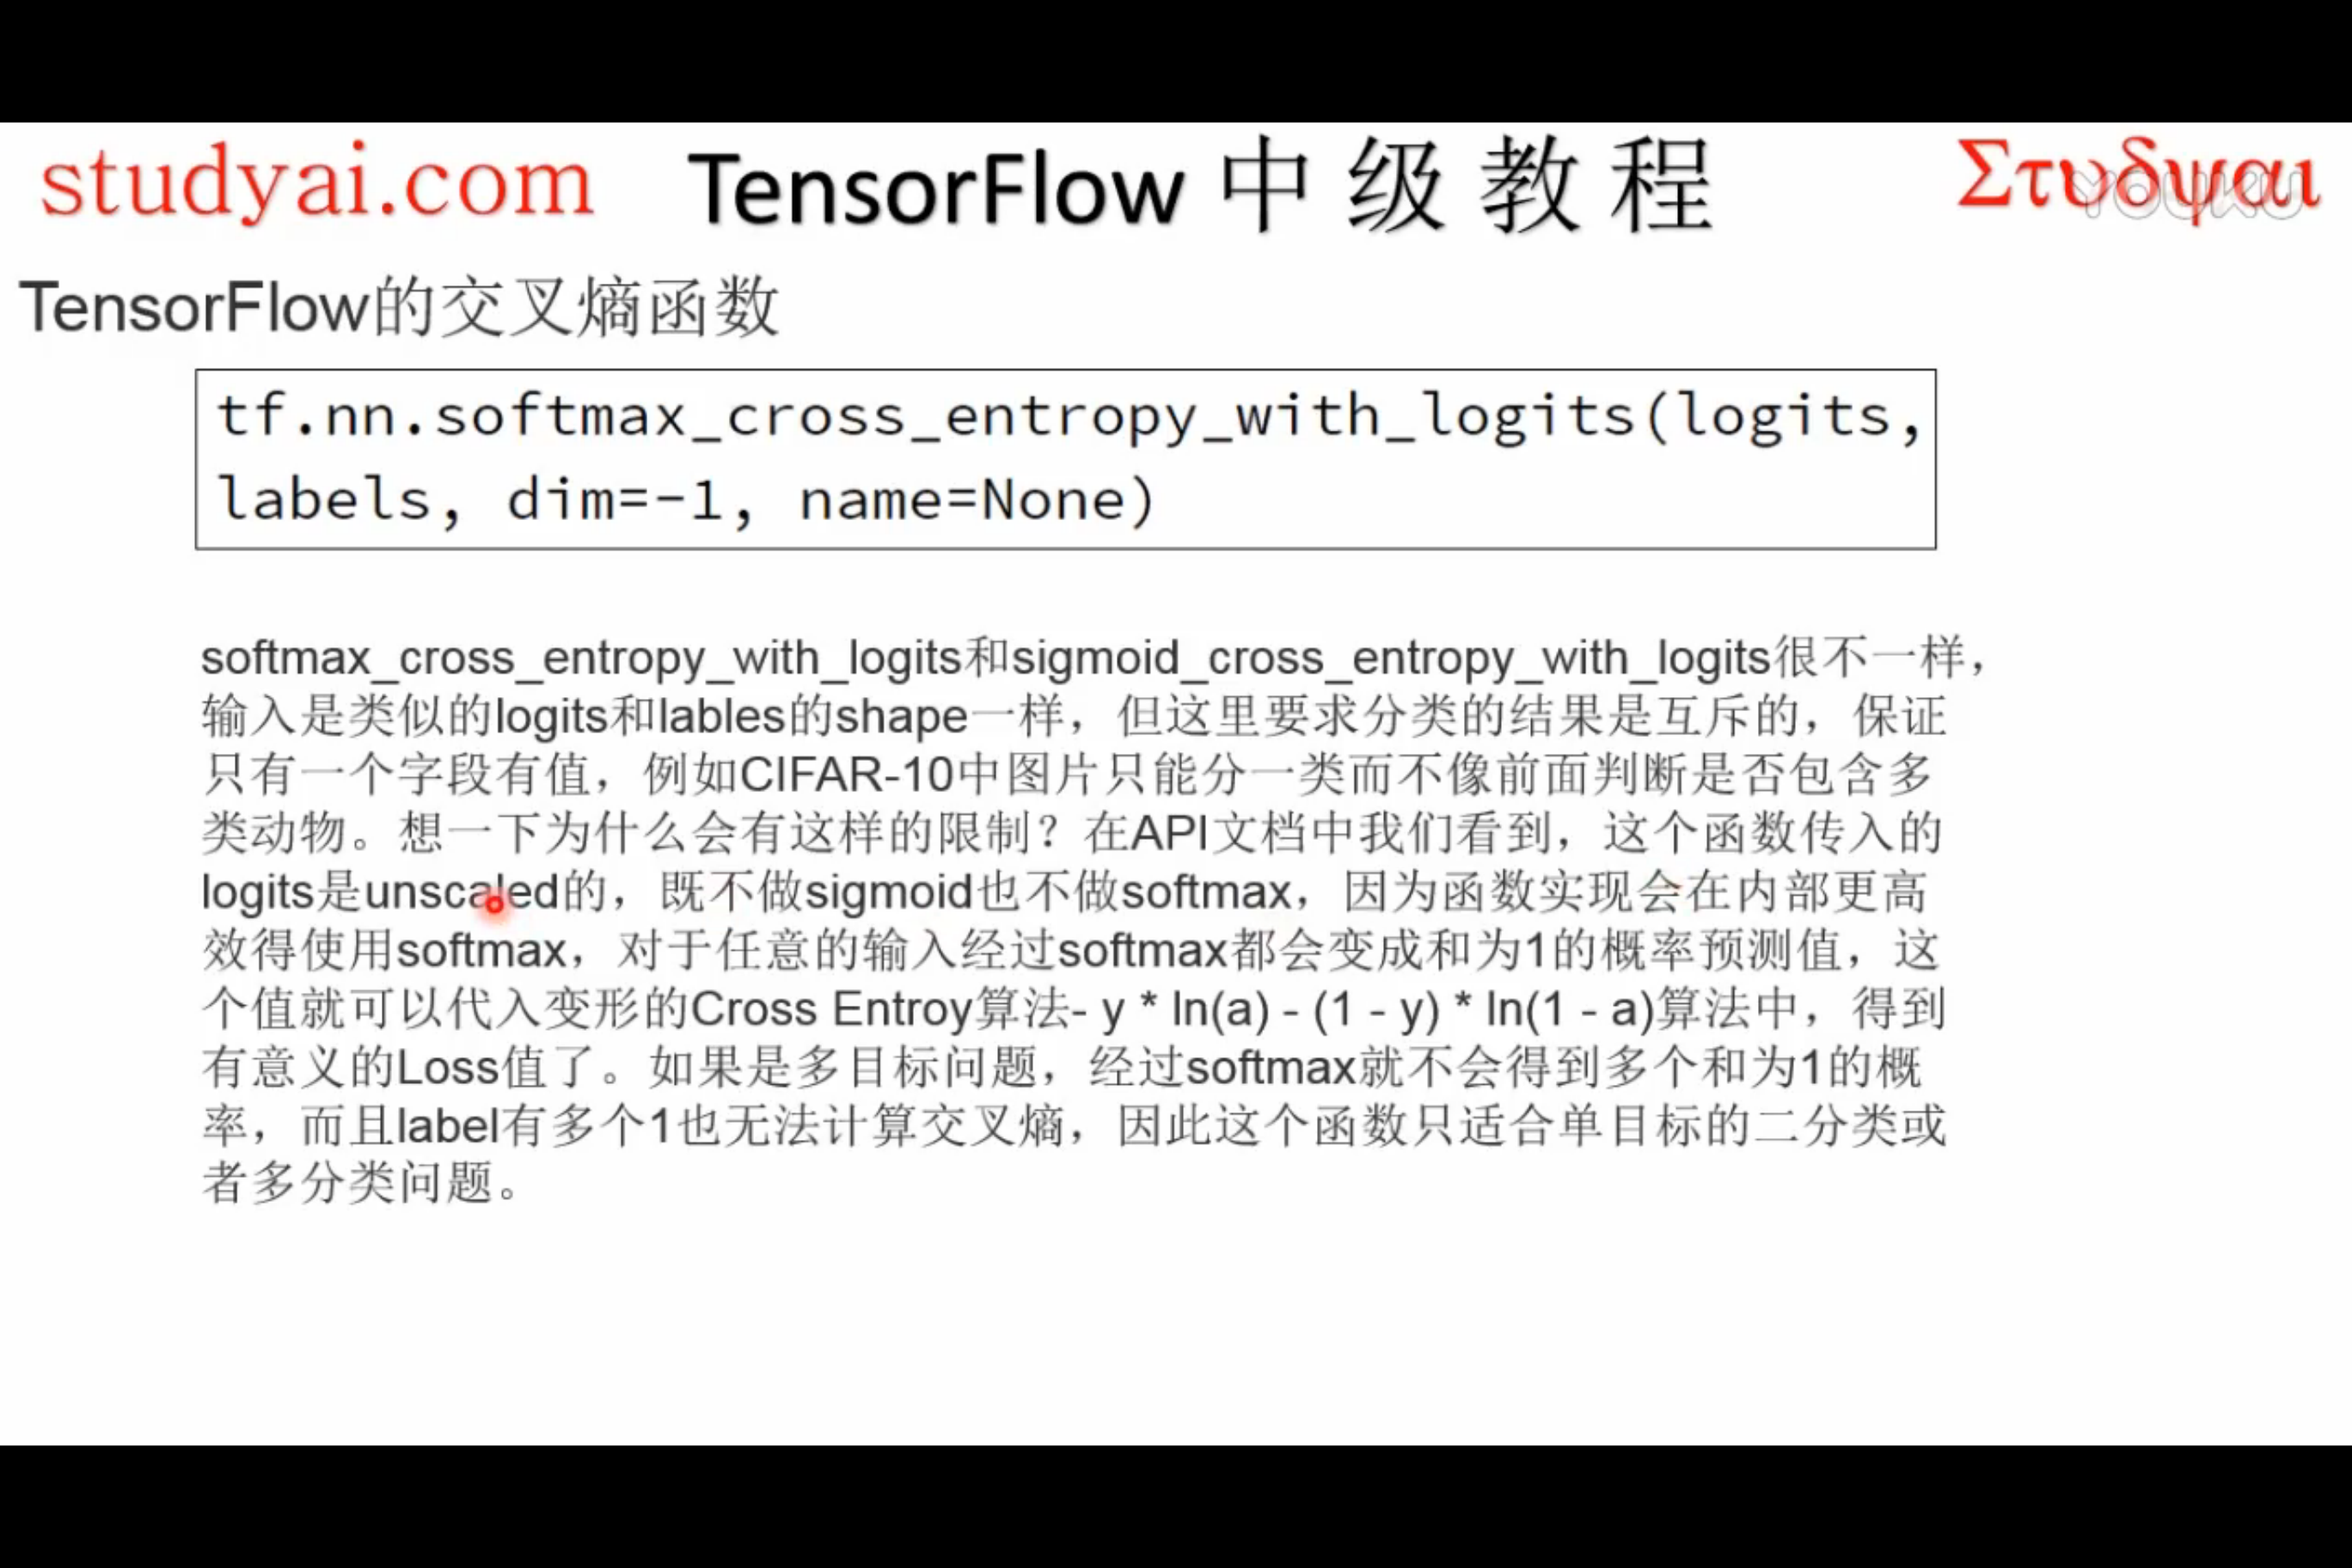
logits经 softmax 函数激活之后的交叉熵。对于每个独立的分类任务,这个函数是去度量概率误差。比如,在 CIFAR-10 数据集上面,每张图片只有唯一一个分类标签:一张图可能是一只狗或者一辆卡车,但绝对不可能两者都在一张图中。(这也是和
tf.nn.sigmoid_cross_entropy_with_logits(logits, targets, name=None)这个API的区别)警告:输入API的数据
logits不能进行缩放,因为在这个API的执行中会进行 softmax 计算,如果logits进行了缩放,那么会影响计算正确率。不要调用这个API区计算 softmax 的值,因为这个API最终输出的结果并不是经过 softmax 函数的值。
logits和labels必须有相同的数据维度[batch_size, num_classes],和相同的数据类型float32或者float64。
使用例子:
#!/usr/bin/env python

# -*- coding: utf-8 -*-

import numpy as np

import tensorflow as tf

input_data = tf.Variable( [[0.2, 0.1, 0.9]] , dtype = tf.float32 )

output = tf.nn.softmax_cross_entropy_with_logits(input_data, [[1,0,0]])

with tf.Session() as sess:

    init = tf.initialize_all_variables()

    sess.run(init)

    print sess.run(input_data)

    print sess.run(output)

    print sess.run(tf.shape(output))
sparse_softmax_cross_entropy_with_logits
tf.nn.sparse_softmax_cross_entropy_with_logits(logits, labels, name=None)解释:这个函数的作用是计算
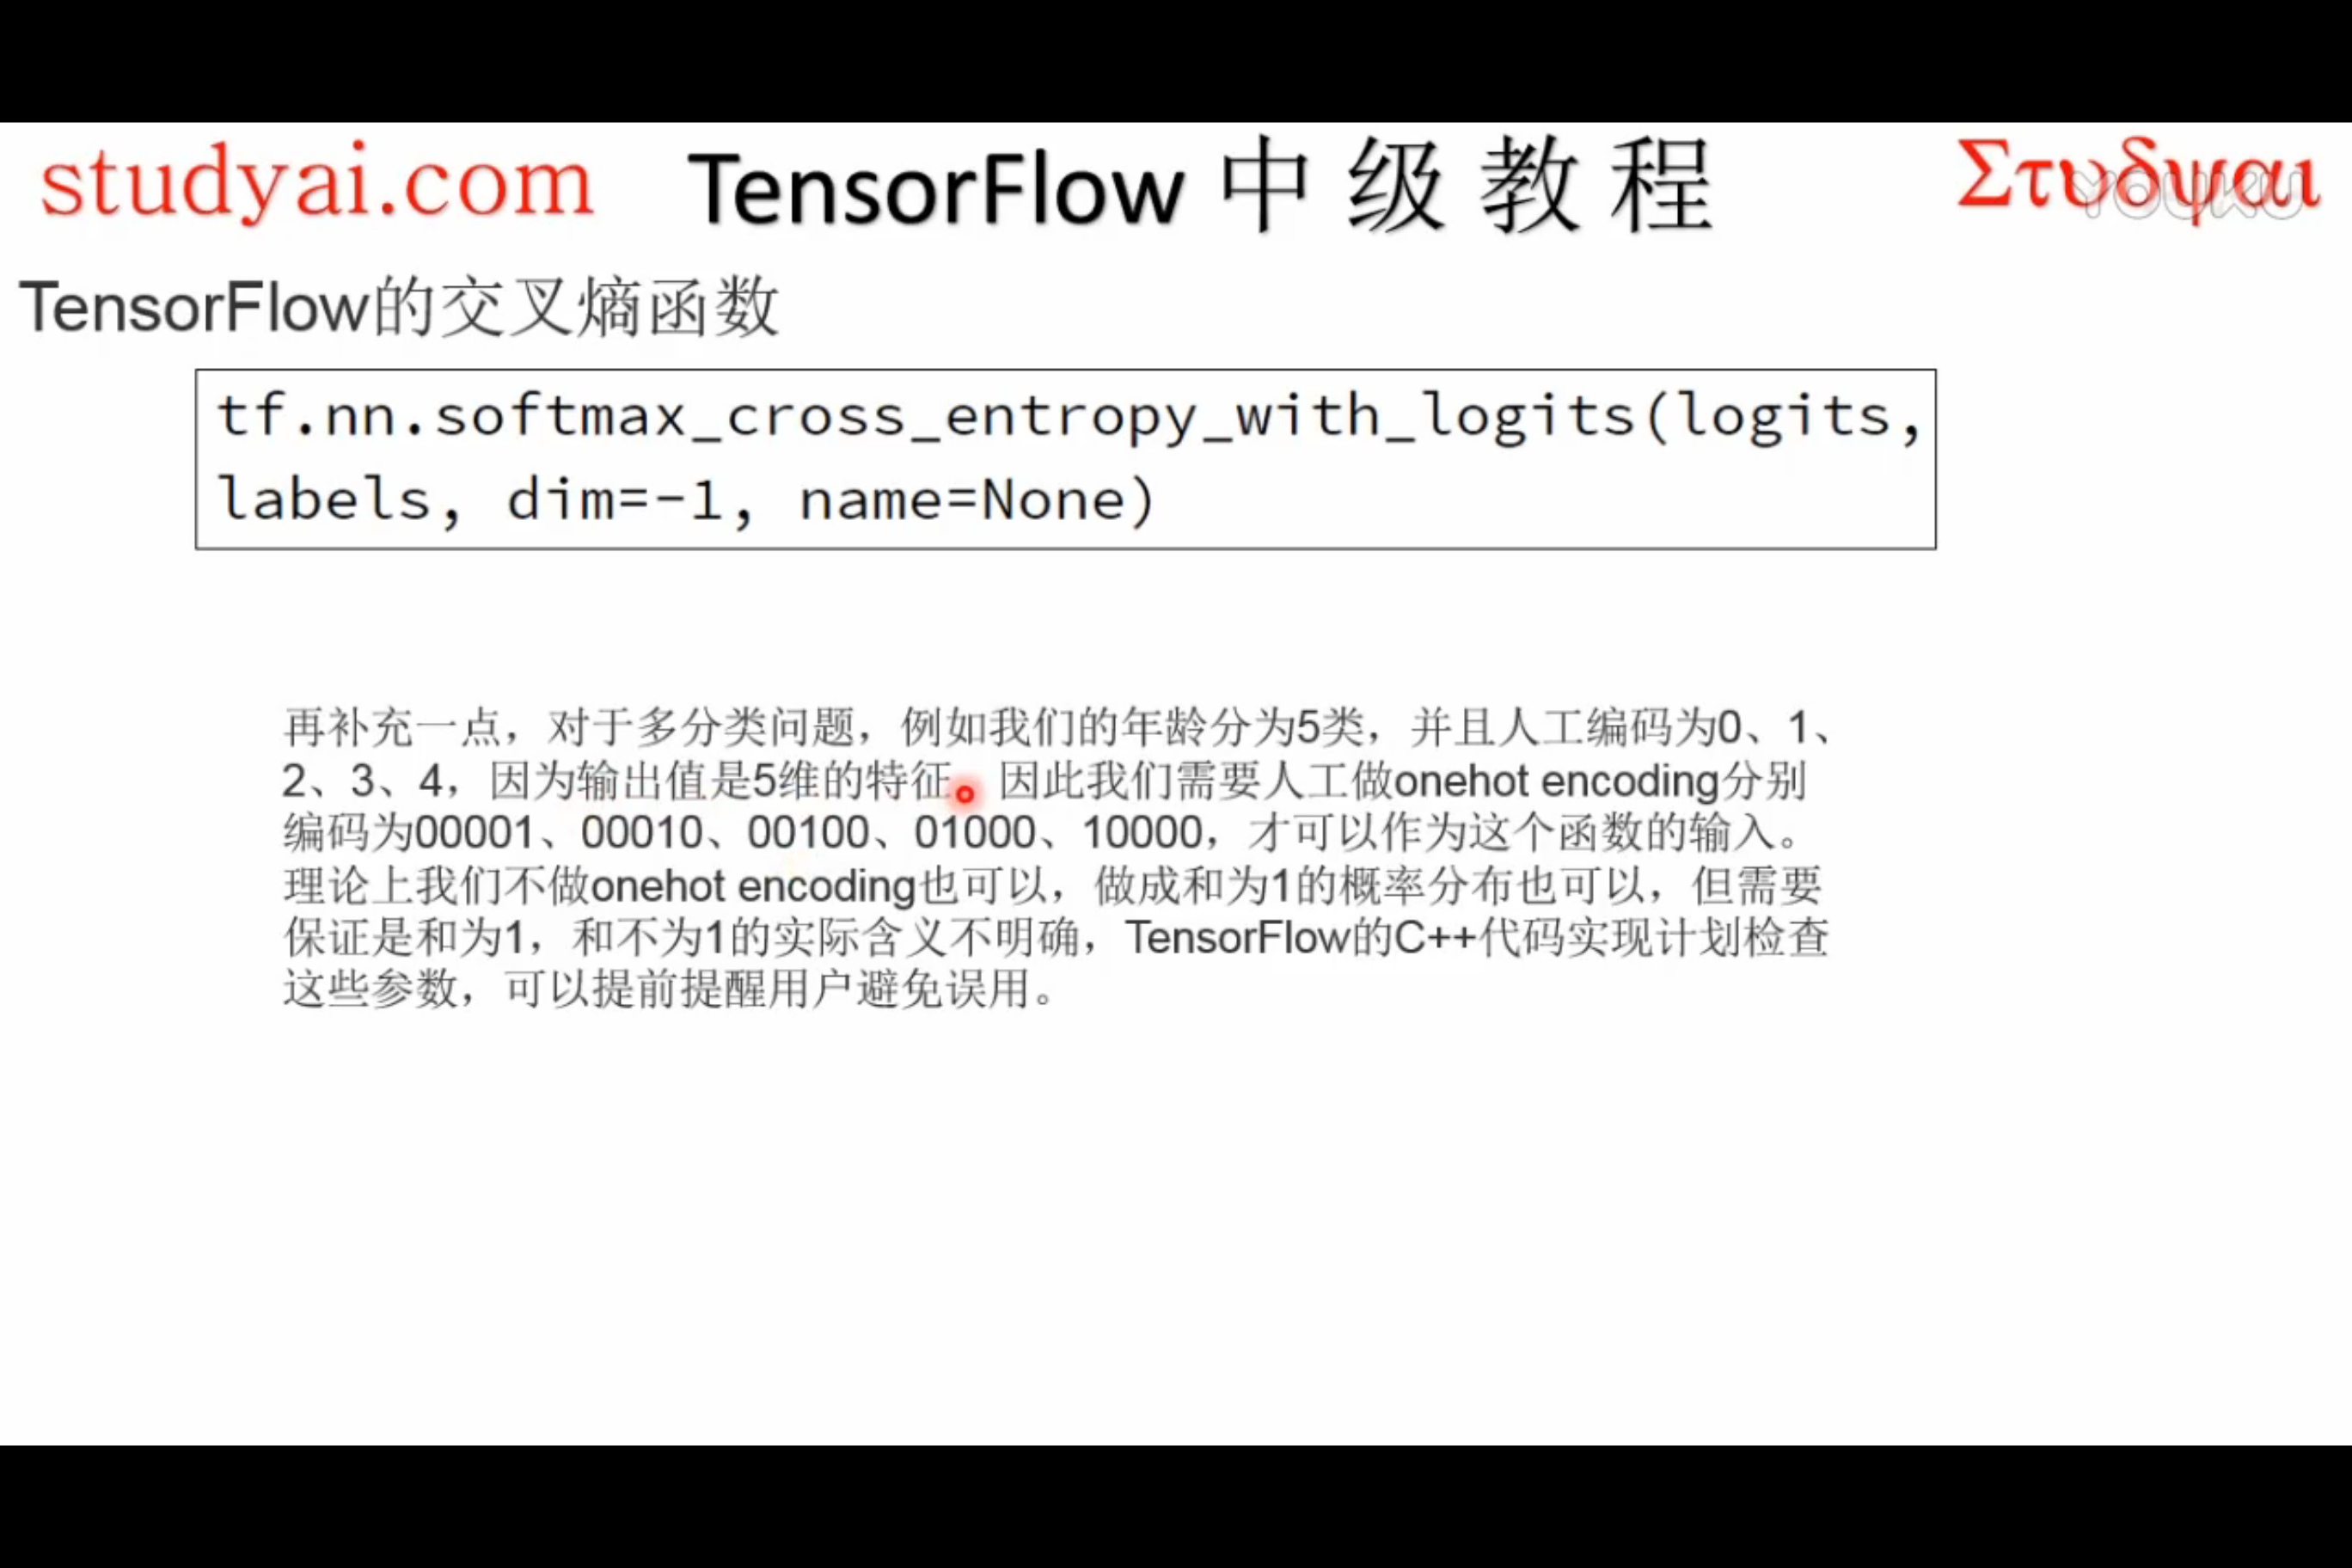
logits经 softmax 函数激活之后的交叉熵,同softmax_cross_entropy_with_logits,只是logits的shape是[batch, class], label的shape是[batch],不用人为one_hot编码。
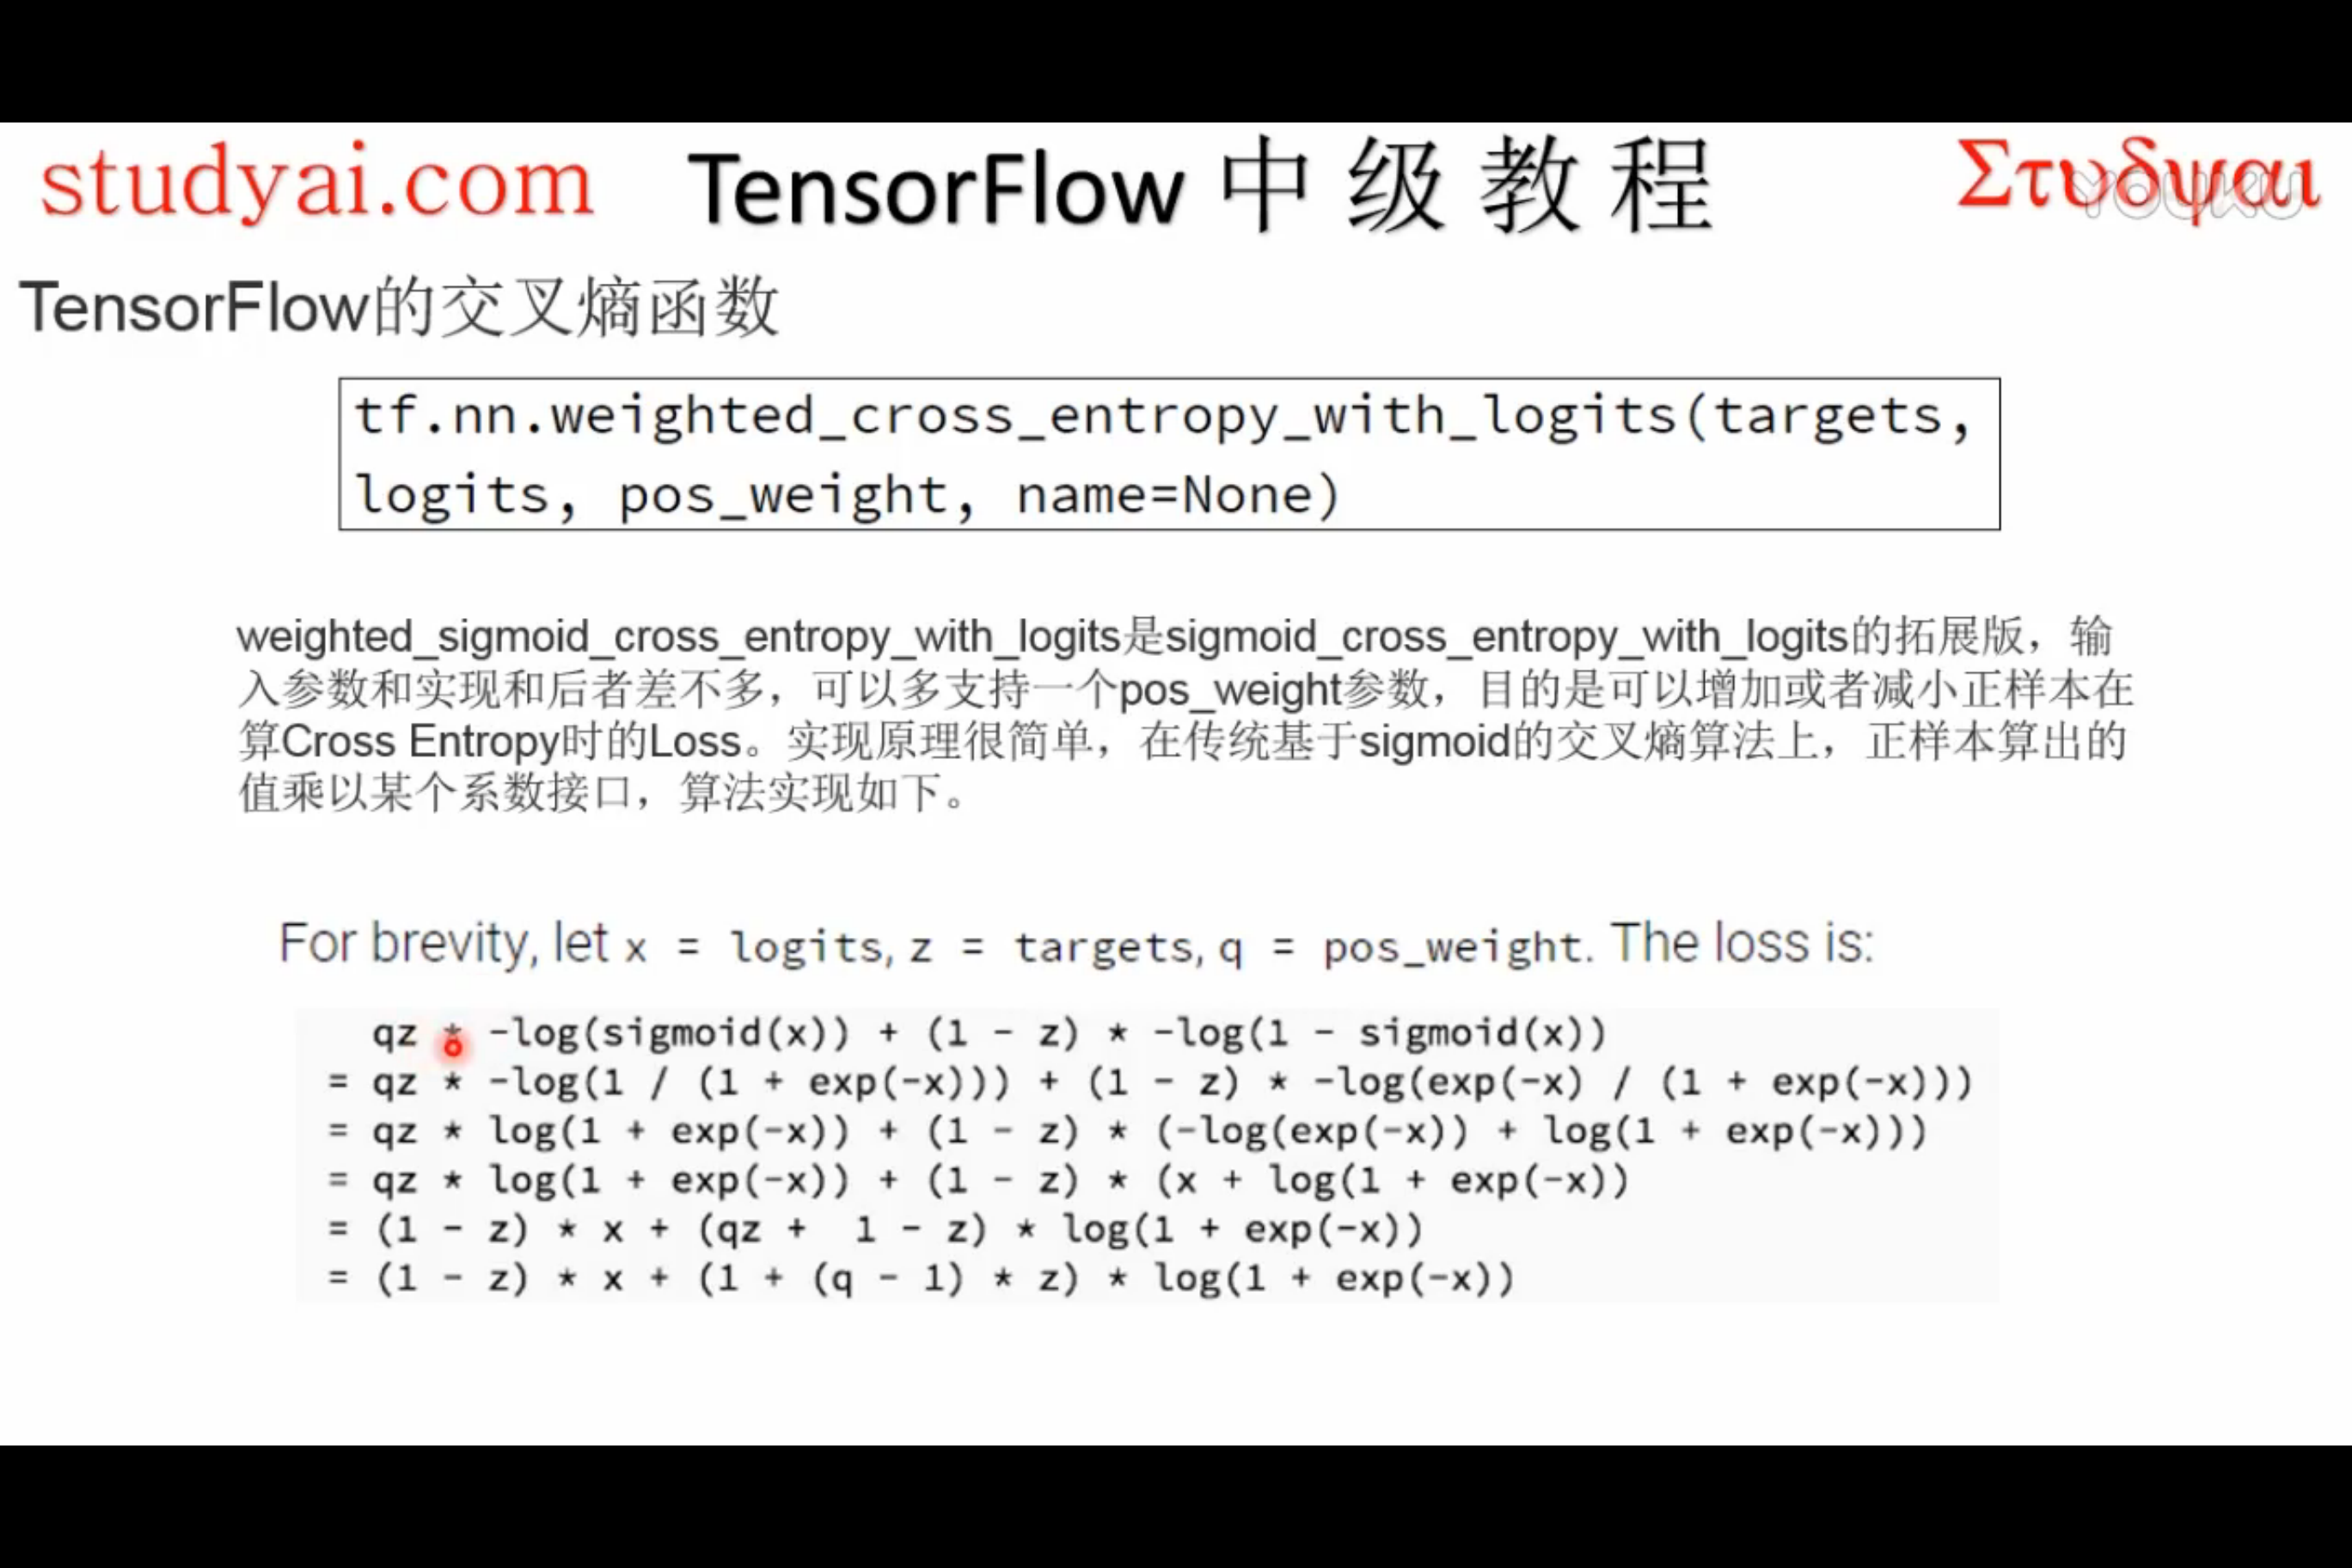
weighted_cross_entropy_with_logits
『TensorFlow』网络操作API_中_损失函数及分类器的更多相关文章
- 『TensorFlow』网络操作API_上
简书翻译原文 卷积层 卷积操作是使用一个二维的卷积核在一个批处理的图片上进行不断扫描.具体操作是将一个卷积核在每张图片上按照一个合适的尺寸在每个通道上面进行扫描.为了达到好的卷积效率,需要在不同的通道 ...
- 『TensorFlow』网络操作API_下
一.优化器基类介绍 标注一点,优化器中的学习率可以是tensor,这意味着它可以feed, learning_rate: A Tensor or a floating point value. 正常使 ...
- 『TensorFlow』SSD源码学习_其一:论文及开源项目文档介绍
一.论文介绍 读论文系列:Object Detection ECCV2016 SSD 一句话概括:SSD就是关于类别的多尺度RPN网络 基本思路: 基础网络后接多层feature map 多层feat ...
- 『TensorFlow』SSD源码学习_其五:TFR数据读取&数据预处理
Fork版本项目地址:SSD 一.TFR数据读取 创建slim.dataset.Dataset对象 在train_ssd_network.py获取数据操作如下,首先需要slim.dataset.Dat ...
- 『TensorFlow』SSD源码学习_其二:基于VGG的SSD网络前向架构
Fork版本项目地址:SSD 参考自集智专栏 一.SSD基础 在分类器基础之上想要识别物体,实质就是 用分类器扫描整张图像,定位特征位置 .这里的关键就是用什么算法扫描,比如可以将图片分成若干网格,用 ...
- 『TensorFlow』SSD源码学习_其八:网络训练
Fork版本项目地址:SSD 作者使用了分布式训练的写法,这使得训练部分代码异常臃肿,我给出了部分注释.我对于多机分布式并不很熟,而且不是重点,所以不过多介绍,简单的给出一点训练中作者的优化手段,包含 ...
- 『TensorFlow』SSD源码学习_其四:数据介绍及TFR文件生成
Fork版本项目地址:SSD 一.数据格式介绍 数据文件夹命名为VOC2012,内部有5个子文件夹,如下, 我们的检测任务中使用JPEGImages文件夹和Annotations文件夹. JPEGIm ...
- 『TensorFlow』SSD源码学习_其三:锚框生成
Fork版本项目地址:SSD 上一节中我们定义了vgg_300的网络结构,实际使用中还需要匹配SSD另一关键组件:被选取特征层的搜索网格.在项目中,vgg_300网络和网格生成都被统一进一个class ...
- 『TensorFlow』SSD源码学习_其七:损失函数
Fork版本项目地址:SSD 一.损失函数介绍 SSD损失函数分为两个部分:对应搜索框的位置loss(loc)和类别置信度loss(conf).(搜索框指网络生成的网格) 详细的说明如下: i指代搜索 ...
随机推荐
- 解决win10无法访问共享
一台win10共享的文件夹,有的电脑是可以访问的,我的win10 访问不了,说什么 遇到未知错误,用以下方法得以解决 ----------------------------------------- ...
- Linux平台 Oracle 18c RAC安装Part2:GI配置
三.GI(Grid Infrastructure)安装 3.1 解压GI的安装包 3.2 安装配置Xmanager软件 3.3 共享存储LUN的赋权 3.4 使用Xmanager图形化界面配置GI 3 ...
- nuxtjs中修改head及vuex的使用
1.在之前vue项目中,我们如果需要改变每个页面的title,是需要在路由里配置meta然后通过路由守卫将每个页面的title替换掉,但是在nuxtjs中他提供了一个方法,直接在每个.vue的文件中使 ...
- 第二章:python基础,数据类型
"""第二章:python基础,数据类型2.1 变量及身份运算补充2.2 二进制数2.3 字符编码每8位所占的空间位一个比特,这是计算机中最小的表示单位.每8个比特组成一 ...
- CentOS 7 nginx+tomcat9 session处理方案之session复制
我们的目标是所有服务器上都要保持用户的Session,那么将每个应用服务器中的Session信息复制到其它服务器节点上是不是就可以呢? 这就是Session的第二中处理办法:会话复制 192.168. ...
- Windbg程序调试系列1-常用命令说明&示例
Windbg程序调试是.Net高级开发需要掌握的必备技能,分析内存泄露.分析高CPU.分析线程阻塞.分析内存对象.分析线程堆栈.Live Dedugging.这个领域可以说一个技能+场景化应用的结合, ...
- 线上bug分析
昨天下午大神把组内几十号人召集在一起开Online bug分析大会,主要是针对近期线上事故从事故原因和解决方案两个维度来分析. 对金融软件来说,每一次的线上事故都有可能给公司带来重大的损失,少扣了用户 ...
- 深入浅出JAVA线程池使用原理2
一.Executor框架介绍 Executor框架将Java多线程程序分解成若干个任务,将这些任务分配给若干个线程来处理,并得到任务的结果 1.1.Executor框架组成 任务:被执行任务需要实现的 ...
- 创建servlet程序知识点详解---servlet-day05
jdbc.properties怎么写? 把秘密改为自己电脑设置的 password url 3306 是安装mysql时所确定的端口 后面还可以接字符集的限定 #1 jsp是什么?(java ser ...
- kubernetes1.5新特性(二):支持Photon卷插件
在Kubernetes中卷的作用在于提供给POD持久化存储,这些持久化存储可以挂载到POD中的容器上,进而给容器提供持久化存储. 从图中可以看到结构体PodSpec有个属性是Volumes,通过这个V ...