
Pandas之分组
假如我们现在有这样一组数据:星巴克在全球的咖啡店信息,如下图所示。数据来源:starbucks_store_locations。我们想要统计中国每个城市的星巴克商店的数量,那我们应该怎么做呢?
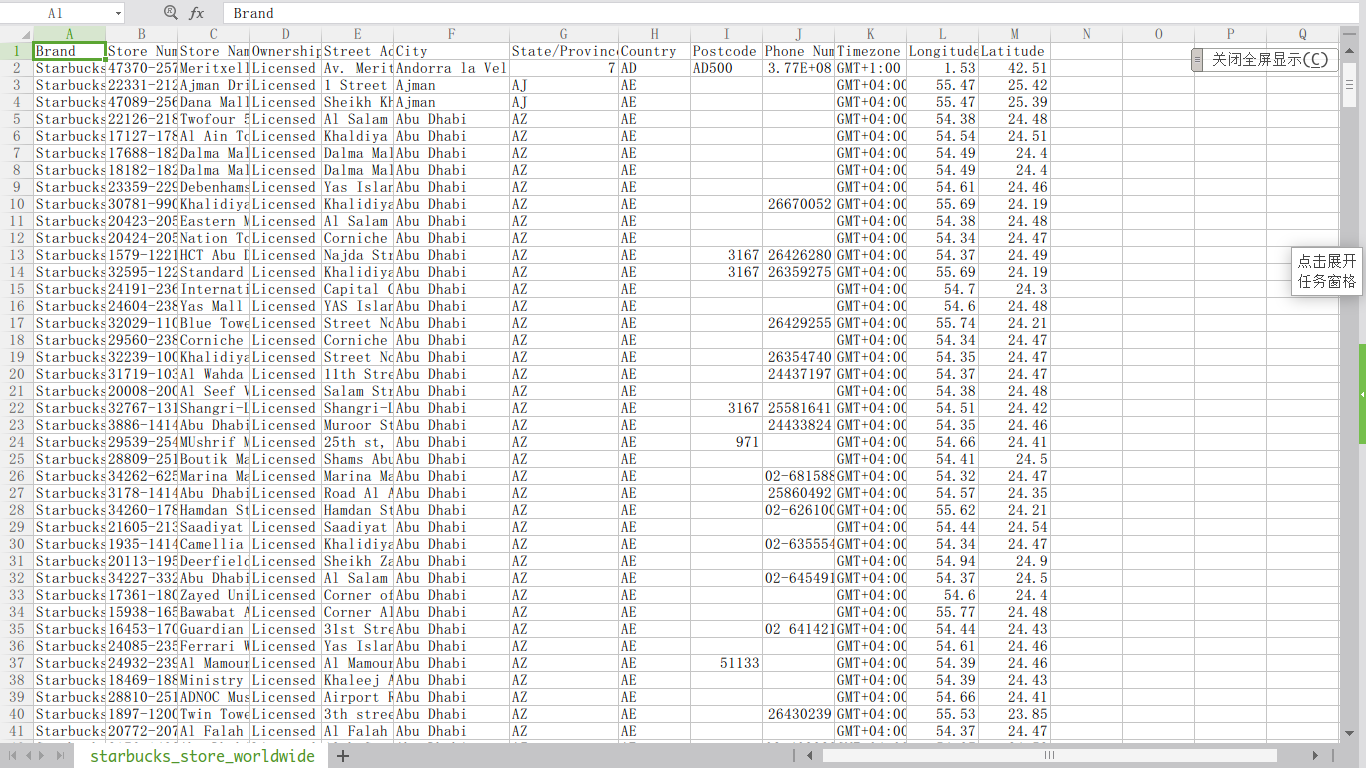
在pandas中,为我们提供了一个处理分组问题的函数groupby():
# coding=utf-8

import pandas as pd

file_path = "./starbucks_store_worldwide.csv"

# 设置最多输出20行

pd.set_option('display.max_rows',20)

df = pd.read_csv(file_path)

df_CN = df[df["Country"]=="CN"]

grouped_CN = df_CN.groupby(by="City")

print(grouped_CN["Brand"].count())
结果如下:
City

Admiralty          2

Causeway Bay       5

Central            1

Chaiwan            1

Changshu           1

Changzhou          1

Fortress Hill      1

Hangzhou           2

Hong Kong        104

Jiaxing            2

                ...

长春市               10

长沙市               26

阳江市                1

青岛市               28

靖江市                2

鞍山市                3

马鞍山                3

高邮市                1

黄石市                1

龙岩市                2

Name: Brand, Length: 197, dtype: int64

Process finished with exit code 0
假如我们不想先提取中国的数据再分组,而是想一步到位应该怎么做呢?
# coding=utf-8

import pandas as pd

file_path = "./starbucks_store_worldwide.csv"

# 设置最多输出20行

pd.set_option('display.max_rows',20)

df = pd.read_csv(file_path)

grouped = df[df["Country"] == "CN"]["Brand"].groupby(by=[df["Country"], df["City"]]).count()

print(grouped)
结果如下:
Country  City

CN       Admiralty          2

         Causeway Bay       5

         Central            1

         Chaiwan            1

         Changshu           1

         Changzhou          1

         Fortress Hill      1

         Hangzhou           2

         Hong Kong        104

         Jiaxing            2

                         ...

         长春市               10

         长沙市               26

         阳江市                1

         青岛市               28

         靖江市                2

         鞍山市                3

         马鞍山                3

         高邮市                1

         黄石市                1

         龙岩市                2

Name: Brand, Length: 197, dtype: int64
我们可以发现,与上面结果不同的是,这次的索引成了2列,不但有city,还有Country。这是因为我们再用group分组的时候传入了2个参数进去。
这里需要注意,最终的结果其实是包含双列索引的单列1维数组,类型是pandas.core.series.Series
Pandas之分组的更多相关文章
- Pandas | GroupBy 分组
任何分组(groupby)操作都涉及原始对象的以下操作之一: 分割对象 应用一个函数 结合的结果 在许多情况下,我们将数据分成多个集合,并在每个子集上应用一些函数.在应用函数中,可以执行以下操作: 聚 ...
- pandas之分组计算笔记
分组计算三部曲:拆分-->应用-->合并 分组:就是按照行或列把相同索引的部分分到一起 分组的关键词为groupby,分组后我们就可以对每组数据进行同一操作,返回的是每组数据分别计算后的结 ...
- pandas groupby 分组操作
最一般化的groupby 方法是apply. tips=pd.read_csv('tips.csv') tips[:5] 新生成一列 tips['tip_pct']=tips['tip']/tips[ ...
- pandas用法之二
1,函数应用 ①map() 将函数作用于一个Series的每一个函数(不能是DataFrame) 类似于Python的高阶函数map() 函数可以是Numpy中的通用函数,也可以是自定义函数 优点:代 ...
- Pandas模块:表计算与数据分析
目录 Pandas之Series Pandas之DataFrame 一.pandas简单介绍 1.pandas是一个强大的Python数据分析的工具包.2.pandas是基于NumPy构建的. 3.p ...
- 机器学习三剑客之Pandas
pandas Pandas是基于Numpy开发出的,专门用于数据分析的开源Python库 Pandas的两大核心数据结构 Series(一维数据) Series 创建Series的方法 ...
- Pandas:表计算与数据分析
目录 Pandas之Series Pandas之DataFrame 一.pandas简单介绍 1.pandas是一个强大的Python数据分析的工具包.2.pandas是基于NumPy构建的. 3.p ...
- (数据科学学习手札69)详解pandas中的map、apply、applymap、groupby、agg
*从本篇开始所有文章的数据和代码都已上传至我的github仓库:https://github.com/CNFeffery/DataScienceStudyNotes 一.简介 pandas提供了很多方 ...
- 利用Python进行数据分析:【Pandas】(Series+DataFrame)
一.pandas简单介绍 1.pandas是一个强大的Python数据分析的工具包.2.pandas是基于NumPy构建的.3.pandas的主要功能 --具备对其功能的数据结构DataFrame.S ...
随机推荐
- PHP删除数组中空值的方法
- Spring-Boot自动装载servlet
Spring-Boot自动装载servlet 本人spring-boot相关博客均自己手动编写,但技术均从简书 恒宇少年 处学习,该大佬一直是我的偶像,鉴于能充分理解,所以已做笔记的方式留下这些文档, ...
- eclipse中的快捷键的使用
- C#压缩图片时保留原始的Exif信息
啥是Exif信息,有啥用,百度百科有解释: Exif百科 总之,这东西对摄影爱好者来说是不可或缺的,通常使用Photoshop来压缩只要不是保存为Web格式都会保留Exif信息. 而我们写代码来压缩图 ...
- python----运行机制
Python 是一门解释型的编程语言,因此它具有解释型语言的运行机制. 计算机程序,其实就是一组计算机指令集,能真正驱动机器运行的是机器指令,但让普通开发者直接编写机器指令是不现实的,因此就出现了计算 ...
- ubuntu下设置mysql自启
- 存储开头结尾使用begin tran,rollback tran作用?
BEGIN TRAN你就把它看成一个还原点,一般用在INSERT.UPDATE.DELETE等能改变数据操作前设置,如果操作后发现执行的结果和预期的不一样,就ROLLBACK,反之就COMMIT提交
- Eclispe最常用的几个快捷键
熟练使用快捷键可以在很大程度上提高我们的工作效率,Eclipse的快捷键很多,但是常用的也就那么几个,下面说下Eclispe最常用的几个快捷键: Eclipse的快捷键组合可在Eclipse按下ctr ...
- 实现mybash
任务内容 1.使用fork,exec,wait实现mybash 查找资料: fork函数 通过fork()系统调用我们可以创建一个和当前进程印象一样的新进程.我们通常将新进程称为子进程,而当前进程称为 ...
- .net core 获取不到session 和cookies的值
在启动类的configure services()方法中,设置选项.checkconsent必需=context=false;如下: services.Configure<CookiePolic ...