
【Python接口测试】简单系统登录接口测试实例
我们可以用Jmeter做接口测试,但是呢个人觉得那个有点局限性,用python就灵活很多,
可以按自己的思路来构建比较灵活,下面给大家介绍一个简单的接口测试实例。
一、我们的思路如下:
首先我们要弄清楚我们的整个思路:
1.先把我们的测试数据准备好,即post的数据(当然get方法也可以发送请求数据)
2.然后我们向指定的URL发送请求(post方法)
3获取repones的结果数据,
4.判断repones结果是否有符合预期的数据
二、我这里举一个注册vpn账号的例子:
下面是我们要通过post方法请求的数据

Headers要先申明类型,然后通过requests.post方法向url发送数据请求。
三、请求数据后我们等待服务器响应,并且获取repones的数据
我们通过text方法获取到响应报文的内容,通过stauts_code获取响应的状态码

四、我们对获取到的报文做判断,是否含有预期的数据在里面
对code进行判断,是否为200,有则表示和服务器会话是正常的
对报文的内容进行判断,验证是否含有预期的数据

五、运行看结果

结果是ok的,可以注册成功
好,到这里我们一个简单的接口测试实例就讲完了。
——————————————————————————————————————————————————————————
一个网站登录接口测试环境的练习
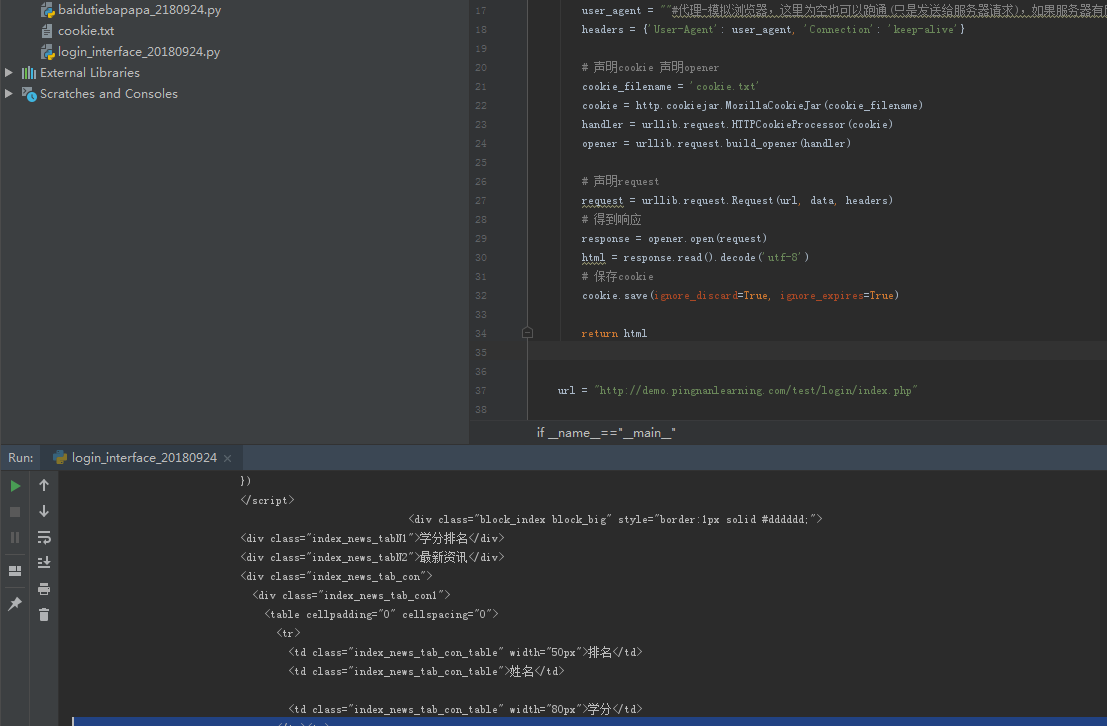
1.登录demo环境,爬取登录后画面的代码。
# coding=utf-8

import csv

import random

import io

from urllib import request,parse,error

import http.cookiejar

import urllib

import re

from bs4 import BeautifulSoup

if __name__=="__main__":

    def GetWebPageSource(url,values):

        # url = "https://www.incnjp.com/thread-4578658-1-1.html"

        data = parse.urlencode(values).encode('utf-8')

        # header

        user_agent = ""#代理-模拟浏览器,这里为空也可以跑通(只是发送给服务器请求),如果服务器有反爬虫,那么这里需要写浏览器相关的代理信息模拟浏览器(即反反爬虫机制)

        headers = {'User-Agent': user_agent, 'Connection': 'keep-alive'}

        # 声明cookie 声明opener

        cookie_filename = 'cookie.txt'

        cookie = http.cookiejar.MozillaCookieJar(cookie_filename)

        handler = urllib.request.HTTPCookieProcessor(cookie)

        opener = urllib.request.build_opener(handler)

        # 声明request

        request = urllib.request.Request(url, data, headers)

        # 得到响应

        response = opener.open(request)

        html = response.read().decode('utf-8')

        # 保存cookie

        cookie.save(ignore_discard=True, ignore_expires=True)

        return html

    url = "http://demo.pingnanlearning.com/test/login/index.php"

    values = {"username": "sasa",

            "password": "",

            "phone2": ""

            }

    html = GetWebPageSource(url,values)

    print(html)
运行结果:
1.判断用户是否登录demo环境成功
# coding=utf-8

import csv

import random

import io

from urllib import request,parse,error

import http.cookiejar

import urllib

import re

from bs4 import BeautifulSoup

if __name__=="__main__":

    def GetWebPageSource(url,values):

        # url = "https://www.incnjp.com/thread-4578658-1-1.html"

        data = parse.urlencode(values).encode('utf-8')

        # header

        user_agent = ""#这里可以为空(但只是发送给服务器请求-服务器没有反爬虫机智前提下可以跑通);如果服务器有反爬虫,那么我们这里需要写浏览器相关的代理信息(即反反爬虫机制)

        headers = {'User-Agent': user_agent, 'Connection': 'keep-alive'}

        # 声明cookie 声明opener

        cookie_filename = 'cookie.txt'

        cookie = http.cookiejar.MozillaCookieJar(cookie_filename)

        handler = urllib.request.HTTPCookieProcessor(cookie)

        opener = urllib.request.build_opener(handler)

        # 声明request

        request = urllib.request.Request(url, data, headers)

        # 得到响应

        response = opener.open(request)

        html = response.read().decode('utf-8')

        # 保存cookie

        cookie.save(ignore_discard=True, ignore_expires=True)

        return html

    url = "http://demo.pingnanlearning.com/test/login/index.php"

    values = {"username": "sasa",

            "password": "",

            "phone2": ""

            }

    html = GetWebPageSource(url,values)

    # 判断登陆成功与否

    isLogin = False

    soup = BeautifulSoup(html, "lxml")

    hrefList = soup.select('a[target="_blank"]')

    for m in hrefList:

        if m.text == "个人中心":

            isLogin = True

    if isLogin:

        print("小sasa登陆成功!")

    else:

        print("小sasa登陆失败!")

    # print(html)
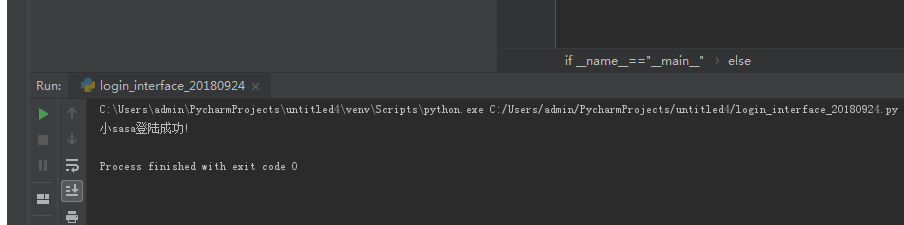
运行效果图:
3.2-面向对象代码优化
# coding=utf-8

import csv

import random

import io

from urllib import request,parse,error

import http.cookiejar

import urllib

import re

from bs4 import BeautifulSoup

# 发送请求获得响应

def GetWebPageSource(url, values):

    data = parse.urlencode(values).encode('utf-8')

    # header

    user_agent = "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.92 Safari/537.36"#这里可以为空(但只是发送给服务器请求-服务器没有反爬虫机智前提下可以跑通);如果服务器有反爬虫,那么我们这里需要写浏览器相关的代理信息(即反反爬虫机制)

    headers = {'User-Agent': user_agent, 'Connection': 'keep-alive'}

    # 声明cookie 声明opener

    cookie_filename = 'cookie.txt'

    cookie = http.cookiejar.MozillaCookieJar(cookie_filename)

    handler = urllib.request.HTTPCookieProcessor(cookie)

    opener = urllib.request.build_opener(handler)

    # 声明request

    request = urllib.request.Request(url, data, headers)

    # 得到响应

    response = opener.open(request)

    html = response.read().decode('utf-8')

    # 保存cookie

    cookie.save(ignore_discard=True, ignore_expires=True)

    return html

# 判断登陆成功与否

def IsResSuccess(html):

    isLogin = False

    soup = BeautifulSoup(html, "lxml")

    hrefList = soup.select('a[target="_blank"]')

    for m in hrefList:

        if m.text == "个人中心":

            isLogin = True

            break#退出循环,之后不再循环,继续执行下面的return代码。(continue,当次循环continue下代码不执行,跳出当次循环,继续下一次循环)
return isLogin#不是每个函数都需要返回值

if __name__=="__main__":

    url = "http://demo.pingnanlearning.com/test/login/index.php"

    values = {"username": "sasa",

            "password": "",

            "phone2": ""

            }

    html = GetWebPageSource(url,values)

    #判断登陆成功与否

    if IsResSuccess(html):

        print("小sasa登陆成功!")

    else:

        print("小sasa登陆失败!")
【Python接口测试】简单系统登录接口测试实例的更多相关文章
- Appium+python 一个简单的登录测试实例
# coding=utf-8 from appium import webdriver import time import unittest import os import HTMLTestRun ...
- Python 实现简单的登录注册界面
Python 实现简单的登录注册界面 注意:编写代码之前需要导入很重要的包 import tkinter as tk import pickle from tkinter import message ...
- Python 做简单的登录系统
案例 之 登录系统原创作品1 该随笔 仅插入部分代码:全部py文件源代码请从百度网盘自行下载! 链接:https://pan.baidu.com/s/1_sTcDvs5XEGDcnpoQEIrMg 提 ...
- python+tkinter 简单的登录窗口demo
一个简单的登录窗口布局,可以用于日常快速搭建一个简单的窗口类. from tkinter import * import tkinter.messagebox class LoginUi: def _ ...
- python一个简单的登录
文件目录下有两个文件 user_name.txt lock_file.txt 实际中可以读数据库里的信息 代码如下 #encoding = utf-8 import sys user_file = ' ...
- python实现简单的登录管理
import json,timeusername=[]userpasswd=[]def login_success_file(name): try: f=open(r"F:/login_su ...
- PHP简单模拟登录功能实例分享
1.curl实现模拟登录的代码,(只是实现服务器与服务器建立会话,其实并没有在客户端与服务器之间建立会话) <?php $cookie_jar = tempnam('./tmp','cookie ...
- python+selenium简单实现拖动元素实例
from selenium import webdriver#引入ActionChains类from selenium.webdriver.common.action_chains impo ...
- python之unittest框架实现接口测试实例
python之unittest框架实现接口测试实例 接口测试的方法有很多种,具体到工具有postman,jmeter,fiddler等,但是工具的局限性是测试数据的组织较差,接口的返回工具的判断有限, ...
随机推荐
- AE插件开发的一些总结
首先会遇到第一个问题,为什么输出的aex文件不在bin目录下,而在别的目录下.其实问题出在链接器的设置里.把这个改成自己想要的目录就OK 然后一些object的报错,直接把警告等级改成0就可以了.属性 ...
- nodeJs学习过程之一个图片上传显示的例子
目标 1. 在浏览器地址栏输入“http://demos/start”,进入欢迎页面,页面有一个文件上传表单: 2. 选择一张图片并提交表单,文件被上传到"http://demos/uplo ...
- C# - 获取类中属性的名称
用反射控制的,不过获取属性名称的方法,用方法形式获取的,不知道消耗大不大 using System; using System.Collections.Generic; using System.Li ...
- sklearn提供的自带的数据集
sklearn 的数据集有好多个种 自带的小数据集(packaged dataset):sklearn.datasets.load_<name> 可在线下载的数据集(Downloaded ...
- <转>pandas学习
1.Pandas 基本介绍 Numpy 和 Pandas 有什么不同? 如果用 python 的列表和字典来作比较, 那么可以说 Numpy 是列表形式的,没有数值标签,而 Pandas 就是字典形式 ...
- 【EF框架异常】System.MissingMethodException:“找不到方法:“System.Data.Entity.ModelConfiguration.Configuration.PrimitivePropertyConfiguration
最近调试EF的时候遇到下面这个问题 System.MissingMethodException:“找不到方法:“System.Data.Entity.ModelConfiguration.Config ...
- 【vue学习】vue中怎么引用laydate.js日期插件
此贴意在解决一个妹子的问题 https://q.cnblogs.com/q/101462 下载js包 http://www.layui.com/laydate/ 将laydate下载的包解压放入sta ...
- kubernetes 测试 Mariadb gtid 主从复制.
k8s 为 1个master 3个node 下载镜像 : mariadb 镜像版本是10.2.13 (此时10.3还没发布正式版) docker pull mariadb push到私有仓库 dock ...
- html2canvas - 项目中遇到的那些坑点汇总(更新中...)
截图模糊 原理就是讲canvas画布的width和height放大两倍. 后来学习canvas的时候,才了解到这种写法不同于css的宽高设置, 因为css里的只是展示画布显示的大小,不像这样是c ...
- Elasticsearch学习之深入搜索五 --- phrase matching搜索技术
1. 近似匹配 什么是近似匹配,两个句子 java is my favourite programming language, and I also think spark is a very goo ...