
一个豆瓣电影Top250爬虫
一个爬虫
这是我第一次接触爬虫,写的第一个爬虫实例。
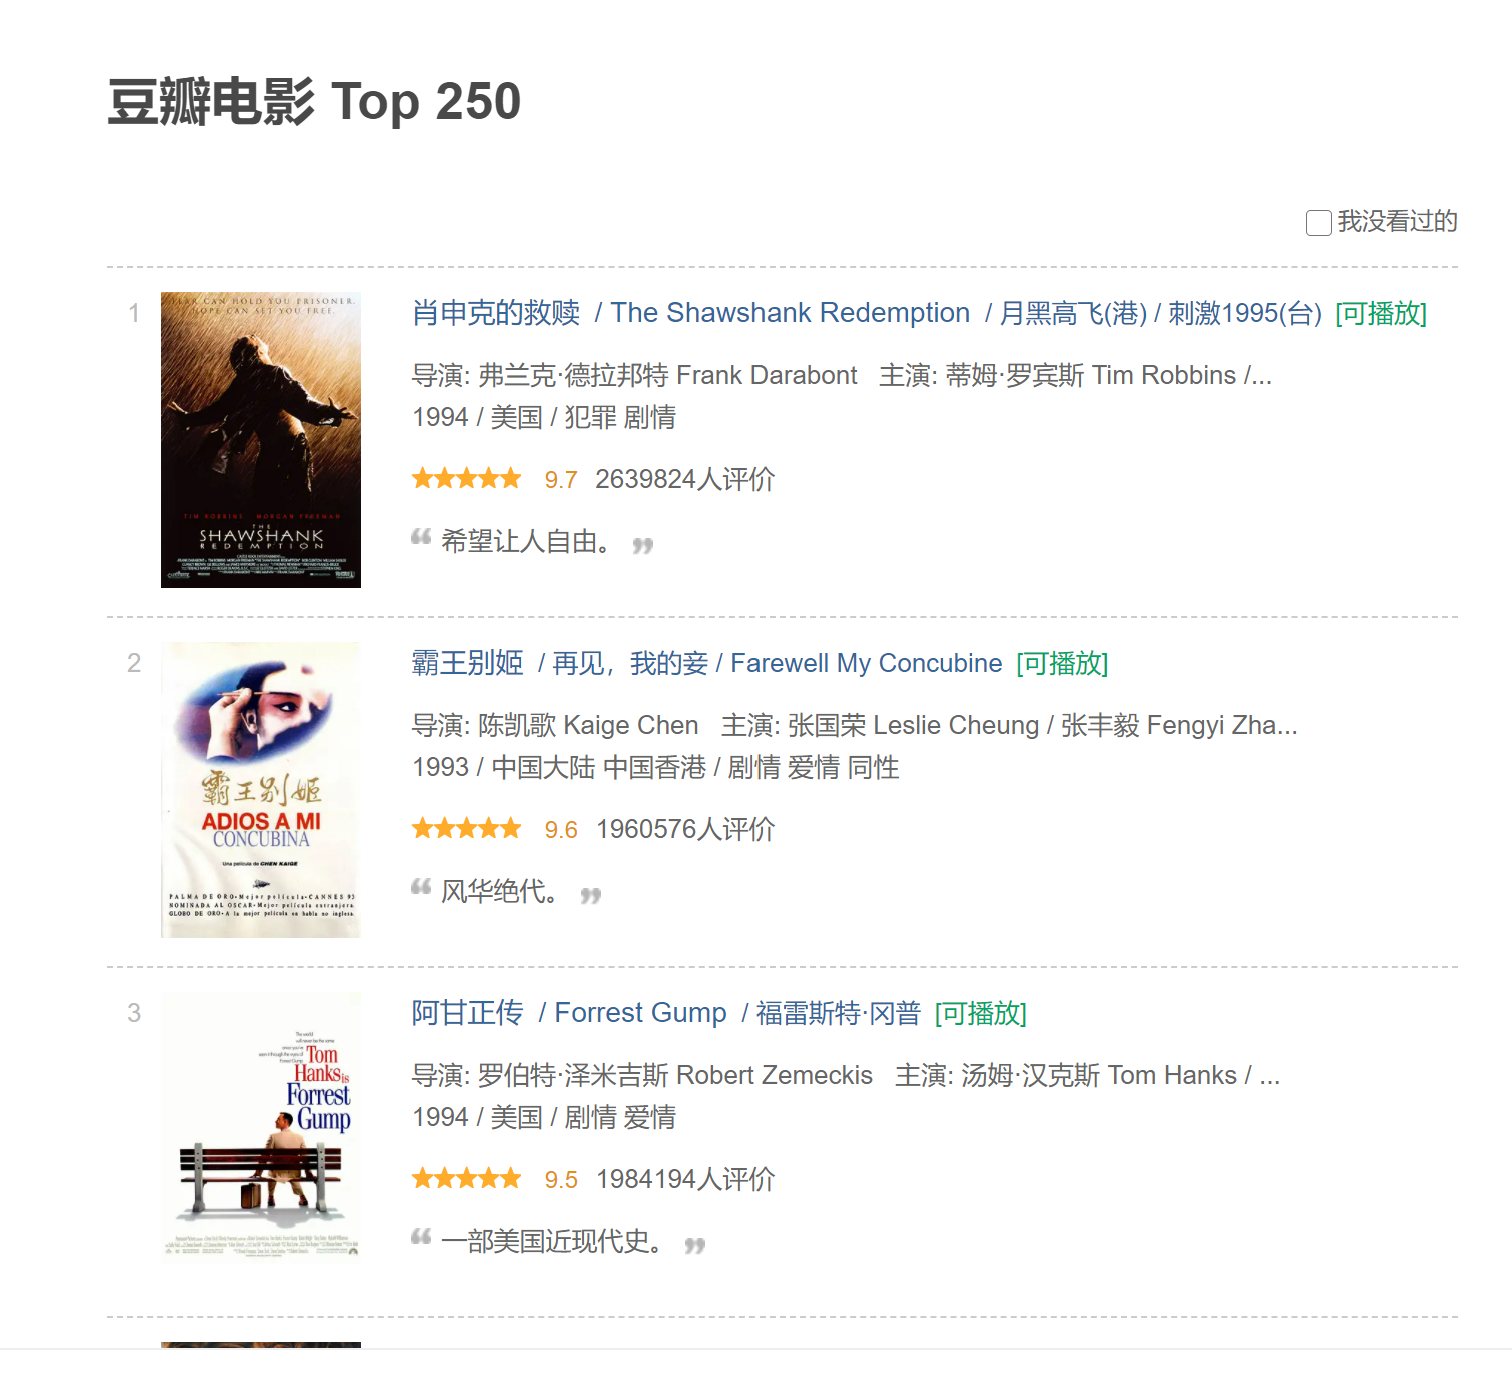
https://movie.douban.com/top250
模块
import requests #用于发送请求

import re #使用正则表达式,用于匹配处理文本

import os #用于创建文件夹

from lxml import etree #这里我使用了Xpath表达式用于数据解析,我觉得这个模块比BeautifulSoup好用,强烈推荐

from fake_useragent import UserAgent #反爬虫,随机获取浏览器 UA 信息
代码
import requests

import re

import os

from lxml import etree

from fake_useragent import UserAgent

class doubanSpider(object):

    def __init__(self):

        if not os.path.exists('db/douban'):

            os.makedirs('db/douban')

        else:

            pass

        self.f = open('./db/douban/douban.txt', 'a', encoding='utf-8')

    def start(self):

        for i in range(46):

            headers = {

                'User-Agent': UserAgent().random

            }

            url = 'https://movie.douban.com/top250?start=' + str(i * 25)

            r = requests.get(url, headers=headers)

            html = etree.HTML(r.text)

            li_list = html.xpath('//*[@id="content"]/div/div[1]/ol/li')

            movies = []

            for each in li_list:

                movie = {}

                order = each.xpath('.//div/div[1]/em/text()')[0]

                movie['id'] = order

                cover = each.xpath('.//div/div[1]/a/img/@src')[0]

                movie['cover'] = cover

                name = each.xpath('.//div/div[2]/div[1]/a/span/text()')

                flag = ''

                for mo in name:

                    flag += mo

                movie['name'] = flag

                info = each.xpath('.//div/div[2]/div[2]/p[1]/text()[1]')[0].strip()

                info = info.replace("\n", "")

                info = info.replace("\xa0", "")

                director = re.findall(r'[导演:].+[主演:]', info)[0]

                director = director[4:len(director) - 3]

                movie['director'] = director

                try:

                    role = re.findall(r'主.+', info)[0]

                    role = role[4:]

                except IndexError:

                    role = ''

                movie['role'] = role

                plot = each.xpath('.//div/div[2]/div[2]/p[1]/text()[2]')[0].strip()

                plot = plot.replace("\xa0", "")

                movie['plot'] = plot

                star = each.xpath('.//div/div[2]/div[2]/div/span[2]/text()')[0]

                movie['star'] = star

                try:

                    comment = each.xpath('.//div/div[2]/div[2]/p[2]/span/text()')[0]

                except IndexError:

                    comment = ''

                movie['comment'] = comment

                movies.append(movie)

                self.f.write(str(movie)+'\n')

                print(movie)

    def run(self):

        self.start()

        self.f.close()

if __name__ == '__main__':

    spider = doubanSpider()

    spider.run()
一个豆瓣电影Top250爬虫的更多相关文章
- [Python] 豆瓣电影top250爬虫
1.分析 <li><div class="item">电影信息</div></li> 每个电影信息都是同样的格式,毕竟在服务器端是用 ...
- 记一次python爬虫实战,豆瓣电影Top250爬虫
import requests from bs4 import BeautifulSoup import re import traceback def GetHtmlText(url): for i ...
- 练习:一只豆瓣电影TOP250的爬虫
练习:一只豆瓣电影TOP250爬虫 练习:一只豆瓣电影TOP250爬虫 ①创建project ②编辑items.py import scrapyclass DoubanmovieItem(scrapy ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- Scrapy爬虫(4)爬取豆瓣电影Top250图片
在用Python的urllib和BeautifulSoup写过了很多爬虫之后,本人决定尝试著名的Python爬虫框架--Scrapy. 本次分享将详细讲述如何利用Scrapy来下载豆瓣电影To ...
- python爬虫 Scrapy2-- 爬取豆瓣电影TOP250
sklearn实战-乳腺癌细胞数据挖掘(博主亲自录制视频) https://study.163.com/course/introduction.htm?courseId=1005269003& ...
- Python爬虫----抓取豆瓣电影Top250
有了上次利用python爬虫抓取糗事百科的经验,这次自己动手写了个爬虫抓取豆瓣电影Top250的简要信息. 1.观察url 首先观察一下网址的结构 http://movie.douban.com/to ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
随机推荐
- systemd进程管理工具实战教程
关注「开源Linux」,选择"设为星标" 回复「学习」,有我为您特别筛选的学习资料~ 1. systemd介绍 systemd是目前Linux系统上主要的系统守护进程管理工具,由于 ...
- 定时 ——setTimeout | setInterval
使用场景,setTimeout 只调用一次,setInterval 会重复调用,直到清除或重载. <div id="countDown"></div> &l ...
- DOM操作标签,事件绑定,jQuery框架
DOM操作标签 ''' 在起变量名的时候 如果该变量指向的是一个标签 那么建议使用 xxxEle eg:aEle\pEle\divEle\spanEle ''' 基本使用 动态创建一个标签 var 变 ...
- MySQL存储过程入门了解
0.环境说明: mysql版本:5.7 1.使用说明 存储过程是数据库的一个重要的对象,可以封装SQL语句集,可以用来完成一些较复杂的业务逻辑,并且可以入参出参(类似于java中的方法的书写). ...
- c++ web框架实现之静态反射实现
0 前言 最近在写web框架,框架写好后,需要根据网络发来的请求,选择用户定义的servlet来处理请求.一个问题就是,我们框架写好后,是不知道用户定义了哪些处理请求的类的,怎么办? 在java里有一 ...
- 『忘了再学』Shell基础 — 23、其他环境变量配置文件
目录 1.注销时生效的环境变量配置文件 2.其他配置文件 3.Shell登录信息相关文件 (1)/etc/issue文件说明 (2)/etc/issue.net文件说明 (3)/etc/motd文件说 ...
- redis-server.exe双击闪退
转自 https://blog.csdn.net/qq_40361770/article/details/80454248 解决方法: 1-win+R 打开命令行 2-cd至redis目录,例如 D: ...
- Java - 六原则一法则
Java - 六原则一法则 单一职责原则:一个类只做它该做的事情.(单一职责原则想表达的就是"高内聚",写代码最终极的原则只有六个字"高内聚.低耦合",所谓的高 ...
- AtCoder ABC 242 题解
AtCoder ABC 242 题解 A T-shirt 排名前 \(A\) 可得 T-shirt 排名 \([A+1,B]\) 中随机选 \(C\) 个得 T-shirt 给出排名 \(X\) ,求 ...
- 互联网公司实行目标管理(OKR)五点原则和基础
下面从公司文化.组织架构.管理者.落地执行和区别绩效考核五个方面,讲述了如何在公司落地目标管理(OKR),这些是实施OKR的基础,也是原则,虽然写得比较简单,其实是我过去两年多不断观察.实践和摸索的总 ...