
[Python] 豆瓣电影top250爬虫
1.分析
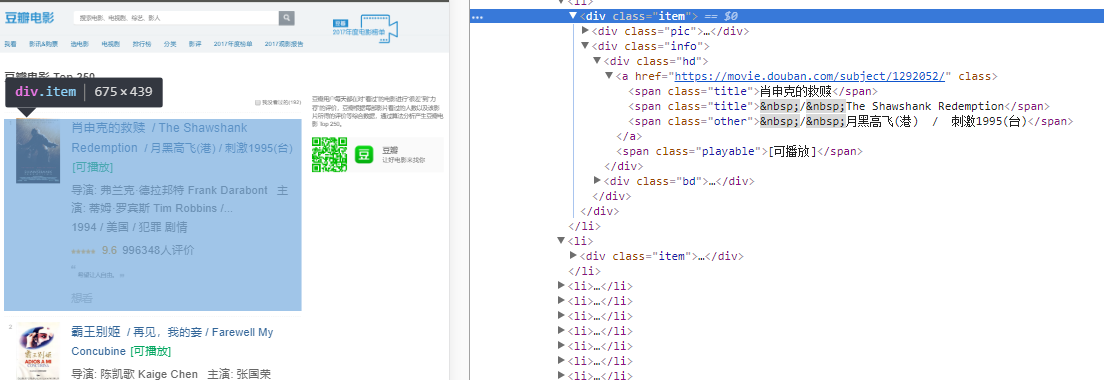
<li><div class="item">电影信息</div></li>
每个电影信息都是同样的格式,毕竟在服务器端是用循环生成的html,这样解析出电影的信息就很简单了
豆瓣电影top250的翻页也很简单,直接就在url上修改一个start就行了,start代表这一页从start+1开始
比如 https://movie.douban.com/top250?start=0&filter=, 就是top1到top25,每页25部电影,翻页把start+=25就行了,一直加到225
2.获取网页的html
使用python内置的urllib库
不过得到的网页中并没有中文,而是会出现这样的字符串
\xe8\xae\xa9\xe5\xa5\xbd\xe7\x94\xb5\xe5\xbd\xb1\xe6\x9d\xa5\xe6\x89\xbe\xe4\xbd\xa0
这是中文的utf-8编码的16进制版本
先将\x去除,变成
e8aea9e5a5bde794b5e5bdb1e69da5e689bee4bda0
然后每6位是一个中文字符
E8 AE A9 让
E5 A5 BD 好
E7 94 B5 电
。。。
全文是【让好电影来找你】
可以在这个网站上输入16进制的UTF-8编码来查找对应字符
def GetHtml(url):

    print('Url : '+url)

    f = request.urlopen(url.format(start))

    data = f.read()

    htmls.append(data.decode('utf-8'))
3.解析网页
简单提下XPath的语法
| nodename | 选取此节点的所有子节点。 |
| / | 从根节点选取。 |
| // | 从匹配选择的当前节点选择文档中的节点,而不考虑它们的位置。 |
| . | 选取当前节点。 |
| .. | 选取当前节点的父节点。 |
| @ | 选取属性。 |
先解析出<div class="item">,再对这个div中的内容进行第二次解析
这里值得注意的是打印一个element内的html要用etree.tostring()
tree = etree.HTML(str)

result = tree.xpath('//div[@class="item"]')  //获取所有<div class="item">元素

print(etree.tostring(result[0], encoding='unicode')) //随便打印一个
打印出来的就是这样的
<div class="item">

                <div class="pic">

                    <em class="">1</em>

                    <a href="https://movie.douban.com/subject/1292052/">

                        <img width="100" alt="肖申克的救赎" src="https://img3.doubanio.com/view/photo/s_ratio_poster/public/p480747492.jpg" class=""/>

                    </a>

                </div>

                <div class="info">

                    <div class="hd">

                        <a href="https://movie.douban.com/subject/1292052/" class="">

                            <span class="title">肖申克的救赎</span>

                                    <span class="title"> / The Shawshank Redemption</span>

                                <span class="other"> / 月黑高飞(港)  /  刺激1995(台)</span>

                        </a>

                            <span class="playable">[可播放]</span>

                    </div>

                    <div class="bd">

                        <p class="">

                            导演: 弗兰克·德拉邦特 Frank Darabont   主演: 蒂姆·罗宾斯 Tim Robbins /...<br/>

                            1994 / 美国 / 犯罪 剧情

                        </p>

                        <div class="star">

                                <span class="rating5-t"/>

                                <span class="rating_num" property="v:average">9.6</span>

                                <span property="v:best" content="10.0"/>

                                <span>996499人评价</span>

                        </div>

                            <p class="quote">

                                <span class="inq">希望让人自由。</span>

                            </p>

                    </div>

                </div>

            </div>
以上<div class="item">已经拿到了,开始进行第二次解析(可以先用个list把这些div存起来,然后再弄个线程做第二次的解析,那是以后的事了,这里先不管)
记录下这里踩的坑
print(result[0].xpath('//img/@src')) //会返回整个页面的img的src
这个奇怪的问题简直了,我甚至觉得是这个包的bug,我从result[0]那么一小段html用xpath查东西居然能查到整个html的,让我觉得我虽然是用result[0]调用的xpath,但内部没准根本不care谁调用的,一律使用最开始etree.HTML() 的到的这个对象调用xpath
我的解决办法是改下xpath,指定从div开始找,或者是用 “."表示从当前节点开始找
print(result[0].xpath('div//img/@src'))

print(result[0].xpath('.//img/@src'))
下面这段代码中的XPath可能不够简洁,但It's just works,毕竟这是第一个版本,随着我对python的熟练,还会继续改动
主要是将一个p标签下的字符串连接起来并去除空格,转换各种特殊字符
需要注意的是XPath返回的基本都是list类型的,很多博客里都直接调方法都没加下标取值,天知道是不是版本不一样
def ProcessHtml(html):

    tree = etree.HTML(html)

    items = tree.xpath('//div[@class="item"]')

    for item in items:

        index = item.xpath('div//em/text()')[0]

        src = item.xpath('div//img/@src')[0]

        info = item.xpath('.//div[@class="bd"]/p')[0].xpath('string(.)').strip().replace(' ','').replace('\xa0',' ').replace('\n',' ')

        title = item.xpath('.//div[@class="hd"]/a')[0].xpath('string(.)').strip().replace(' ','').replace('\xa0',' ').replace('\n',' ')

        star = item.xpath('.//span[@class="rating_num"]/text()')[0]

        print ('''%s

        %s

        %s

        %s

        %s

        ''' %  (index,title,info,star,src))
完整代码https://github.com/arcsinw/project_douban
参考链接
scrapy xpath 从response中获取li,然后再获取li中img的src
[Python] 豆瓣电影top250爬虫的更多相关文章
- 记一次python爬虫实战,豆瓣电影Top250爬虫
import requests from bs4 import BeautifulSoup import re import traceback def GetHtmlText(url): for i ...
- 一个豆瓣电影Top250爬虫
一个爬虫 这是我第一次接触爬虫,写的第一个爬虫实例. https://movie.douban.com/top250 模块 import requests #用于发送请求 import re #使用正 ...
- 练习:一只豆瓣电影TOP250的爬虫
练习:一只豆瓣电影TOP250爬虫 练习:一只豆瓣电影TOP250爬虫 ①创建project ②编辑items.py import scrapyclass DoubanmovieItem(scrapy ...
- python爬虫 Scrapy2-- 爬取豆瓣电影TOP250
sklearn实战-乳腺癌细胞数据挖掘(博主亲自录制视频) https://study.163.com/course/introduction.htm?courseId=1005269003& ...
- Python爬虫----抓取豆瓣电影Top250
有了上次利用python爬虫抓取糗事百科的经验,这次自己动手写了个爬虫抓取豆瓣电影Top250的简要信息. 1.观察url 首先观察一下网址的结构 http://movie.douban.com/to ...
- Python小爬虫——抓取豆瓣电影Top250数据
python抓取豆瓣电影Top250数据 1.豆瓣地址:https://movie.douban.com/top250?start=25&filter= 2.主要流程是抓取该网址下的Top25 ...
- Python爬虫入门:爬取豆瓣电影TOP250
一个很简单的爬虫. 从这里学习的,解释的挺好的:https://xlzd.me/2015/12/16/python-crawler-03 分享写这个代码用到了的学习的链接: BeautifulSoup ...
- 【Python爬虫】:使用高性能异步多进程爬虫获取豆瓣电影Top250
在本篇博文当中,将会教会大家如何使用高性能爬虫,快速爬取并解析页面当中的信息.一般情况下,如果我们请求网页的次数太多,每次都要发出一次请求,进行串行执行的话,那么请求将会占用我们大量的时间,这样得不偿 ...
- python 爬虫&爬取豆瓣电影top250
爬取豆瓣电影top250from urllib.request import * #导入所有的request,urllib相当于一个文件夹,用到它里面的方法requestfrom lxml impor ...
随机推荐
- I-Just Jump_2019牛客暑期多校训练营(第八场)
题目链接 Just Jump 题意 有L+1个点,初始在第0个点上,要跳到第L个点,每次至少跳d格,也就是在点x至少要跳到x+d,且有m个限制 \((t_i, p_i)\)指跳第\(t_i\)次不能跳 ...
- [普及]NOIP 2015 推销员 贪心
NOIP 2015 推销员 题意: 有一个喜欢疲劳的推销员,告诉你在一个单口胡同(数轴)中的n户家庭的位置,和向他们推销可以获得的疲劳度.分别输出向(1,2,3,4...n)户人家推销可以得到的最大疲 ...
- 线段树离散化 unique + 二分查找 模板 (转载)
离散化,把无限空间中有限的个体映射到有限的空间中去,以此提高算法的时空效率. 通俗的说,离散化是在不改变数据相对大小的条件下,对数据进行相应的缩小.例如: 原数据:1,999,100000,15:处理 ...
- 2018中国大学生程序设计竞赛 - 网络选拔赛 hdu Tree and Permutation 找规律+求任意两点的最短路
Tree and Permutation Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/65536 K (Java/Oth ...
- CF1003D Coins and Queries 贪心
Coins and Queries time limit per test 2 seconds memory limit per test 256 megabytes input standard i ...
- framework7 picker 具体使用
官网地址:https://framework7.io/docs/picker.html#dom-events <meta charset="UTF-8"> <me ...
- 4、链栈的实现(java代码)
1.链节点 public class Node<T> { public T data; public Node next; } 2.实现代码 public class Stack<T ...
- Hive中的数据库(Database)和表(Table)
在前面的文章中,介绍了可以把Hive当成一个"数据库",它也具备传统数据库的数据单元,数据库(Database/Schema)和表(Table). 本文介绍一下Hive中的数据库( ...
- 激光三角测量(sheet of light)halcon示例详解 Reconstruct_Connection_Rod_Calib.hdev 三维重建
原文作者:aircraft 原文链接:https://www.cnblogs.com/DOMLX/p/11555100.html 前言:最近项目用到halcon的3d模板匹配,三维重建,相机标定,所以 ...
- Servlet控制台输出乱码问题
在如下图的配置页面: 在此行添加编码格式: