
pipeline和baseline是什么?
昨天和刚来项目的机器学习小白解释了一边什么baseline 和pipeline,今天在这里总结一下什么是baseline和pipeline。
1.pipeline
1.1 从管道符到pipeline
先从在linux的管道符讲起,
find ./ | grep wqbin | sort
inux体系下的各种命令工具的处理,可以使用管道符作为传递,这是一种良好的接口规范,工具的功能有公共的接口规范,就像流水线一样,一步接着一步。
而我们只需改动每个参数就可以获取我们想要的结果。该过程就被称之管道机制。
一个基础的 机器学习的Pipeline 主要包含了下述 5 个步骤:
- 数据读取

- 数据预处理

- 创建模型

- 评估模型结果

- 模型调参
上5个步骤可以抽象为一个包括多个步骤的流水线式工作,从数据收集开始至输出我们需要的最终结果。
因此,对以上多个步骤、进行抽象建模,简化为流水线式工作流程则存在着可行性,流水线式机器学习比单个步骤独立建模更加高效、易用。
管道机制在机器学习算法中得以应用的根源在于,参数集在新数据集(比如测试集)上的重复使用。
1.2sklearn中pipeline为例
sklearn也遵循pipeline机制,并封装到 sklearn.pipline命名空间下面
pipeline.FeatureUnion(transformer_list[, …])    Concatenates results of multiple transformer objects.

pipeline.Pipeline(steps[, memory])              Pipeline of transforms with a final estimator.

pipeline.make_pipeline(*steps, **kwargs)        Construct a Pipeline from the given estimators.

pipeline.make_union(*transformers, **kwargs)    Construct a FeatureUnion from the given trans
PIPELINE
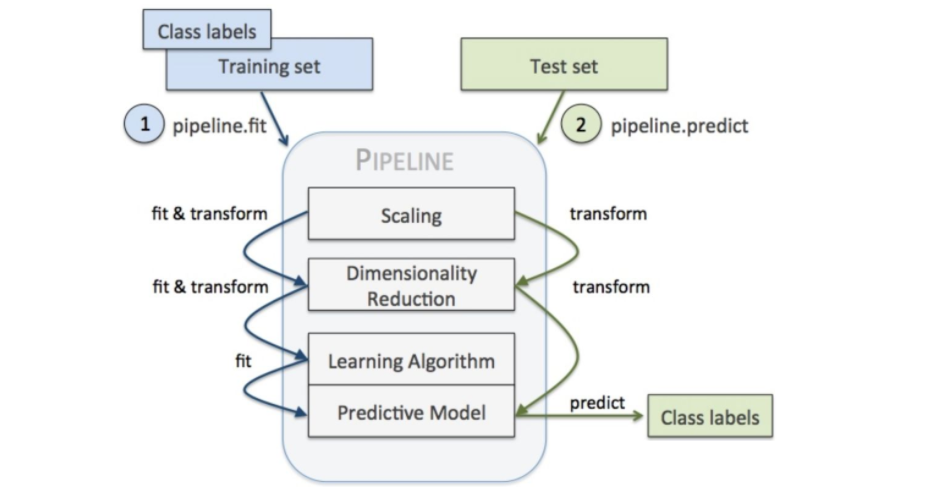
sklearn中把机器学习处理过程抽象为estimator,其中estimator都有fit方法,表示数据进行初始化or训练。estimator有2种:
1、特征变换(transformer)
可以理解为特征工程,即:特征标准化、特征正则化、特征离散化、特征平滑、onehot编码等。该类型统一由一个transform方法,用于fit数据之后,输入新的数据,进行特征变换。
2、预测器(predictor)
即各种模型,所有模型fit进行训练之后,都要经过测试集进行predict所有,有一个predict的公共方法。
上面的抽象的好处即可实现机器学习的pipeline,显然特征变换是可能并行的,通过FeatureUnion实现。特征变换在训练集、测试集之间都需要统一,所以pipeline可以达到模块化的目的。举个NLP处理的例子:
# 生成训练数据、测试数据

X_train, X_test, y_train, y_test = train_test_split(X, y)

# pipeline定义

pipeline = Pipeline([

        ('vect', CountVectorizer()),

        ('tfidf', TfidfTransformer()),

        ('clf', RandomForestClassifier())

])

# train classifier

pipeline.fit(X_train, y_train)

# predict on test data

y_pred = pipeline.predict(X_test)
FEATUREUNION
上面看到特征变换往往需要并行化处理,即FeatureUnion所实现的功能。
pipeline = Pipeline([

             ('features', FeatureUnion([

                  ('text_pipeline', Pipeline([

                        ('vect', CountVectorizer(tokenizer=tokenize)),

                        ('tfidf', TfidfTransformer())

                     ])),

                ('findName', FineNameExtractor())

              ]))

            ('clf', RandomForestClassifier())

       ])
pipeline还可以嵌套pipeline,整个机器学习处理流程就像流水工人一样。
上面自定义了一个pipeline处理对象FineNameExtractor,该对象是transformer,自定义一个transformer是很简单的,创建一个对象,继承自BaseEstimator, TransformerMixin即可,
代码如下:
from sklearn.base import BaseEstimator, TransformerMixin

class FineNameExtractor(BaseEstimator, TransformerMixin):

    def find_name(self, text):

        return True

    def fit(self, X, y=None):

        return self

    def transform(self, X):

        X_tagged = pd.Series(X).apply(self.find_name)

        return pd.DataFrame(X_tagged)
执行一个PIPELINE,加上自动调参就可以了,sklearn的调参通过GridSearchCV实现=》pipeline+gridsearch。
GridSearchCV实际上也有fit、predict方法,所以,训练与预测高效抽象的,代码很简洁。
2.baseline
pipeline和baseline是什么?的更多相关文章
- One EEG preprocessing pipeline - EEG-fMRI paradigm
The preprocessing pipeline of EEG data from EEG-fMRI paradigm differs from that of regular EEG data, ...
- [Feature] Final pipeline: custom transformers
有视频:https://www.youtube.com/watch?v=BFaadIqWlAg 有代码:https://github.com/jem1031/pandas-pipelines-cust ...
- 等待 Redis 应答 Redis pipeline It's not just a matter of RTT
小结: 1.When pipelining is used, many commands are usually read with a single read() system call, and ...
- redis大幅性能提升之使用管道(PipeLine)和批量(Batch)操作
前段时间在做用户画像的时候,遇到了这样的一个问题,记录某一个商品的用户购买群,刚好这种需求就可以用到Redis中的Set,key作为productID,value 就是具体的customerid集合, ...
- Building the Testing Pipeline
This essay is a part of my knowledge sharing session slides which are shared for development and qua ...
- Scrapy:为spider指定pipeline
当一个Scrapy项目中有多个spider去爬取多个网站时,往往需要多个pipeline,这时就需要为每个spider指定其对应的pipeline. [通过程序来运行spider],可以通过修改配置s ...
- [函数] Firemonkey Windows 重新计算 Font Baseline
计算字型 Baseline 是一个不常用的函数,但如果想要显示不同大小文字下方对齐,就得用它来计算字型的 Baseline 才行,如果计算不准,显示的文字就会高高低低不整齐. 在 Firemonkey ...
- 图解Netty之Pipeline、channel、Context之间的数据流向。
声明:本文为原创博文,禁止转载. 以下所绘制图形均基于Netty4.0.28版本. 一.connect(outbound类型事件) 当用户调用channel的connect时,会发起一个 ...
- 初识pipeline
1.pipeline的产生 从一个现象说起,有一家咖啡吧生意特别好,每天来的客人络绎不绝,客人A来到柜台,客人B紧随其后,客人C排在客人B后面,客人D排在客人C后面,客人E排在客人D后面,一直排到店面 ...
随机推荐
- 菜鸟系列docker——搭建私有仓库harbor(6)
docker 搭建私有仓库harbor 1. 准备条件 安装docker sudo yum update sudo yum install -y yum-utils device-mapper-per ...
- 第六周&java实验报告四
实验报告: 一.实验目的 (1)掌握类的继承 (2)变量的继承和覆盖,方法的继承,重载和覆盖的实现: 二.实验的内容 (1)根据下面的要求实现圆类Circle. 1.圆类Circle的成员变量:rad ...
- [转帖]使用Grafana和Telegraf监视VMware ESXi的方法
使用Grafana和Telegraf监视VMware ESXi的方法 2019-04-03 15:28:30作者:曾秀珠稿源:云网牛站 https://ywnz.com/linuxyffq/4660. ...
- shell中防止意外发生的两个实用的设置
set -o nounset set -o errexit set -o nounset 在默认情况下,遇到不存在的变量,会忽略并继续执行,而这往往不符合预期,加入该选项,可以避免恶果扩大,终止脚本的 ...
- 黑科技——树剖两次dfs转一次dfs!
黑科技--树剖两次\(dfs\)转一次\(dfs\)! 重所周知,树链剖分通常是要\(dfs\)两次的,就像这样: int Fa[N],dep[N],Sz[N],son[N]; void dfs1( ...
- tee、vi/vim命令
一.tee:多重定向 语法: tee [OPTION] ... [FILE] ... 参数: 将标准输入复制到每个FILE,也复制到标准输出. -a,--append ...
- T100 —— 凭证打印时排序
capr110_g01,按扣账日期打印排序: 在adzp188——“字段”中加入pmds001的话,产生的代码的变量是:pmds_t_pmds001 :当在“群组”—“印出排序” 再添加pmds001 ...
- k8s-高可用架构设计
docker的私有仓库harbor.容器化kubernetes部分组建.使用阿里云日志服务收集日志. 部署完成后,你将理解系统各组件的交互原理,进而能快速解决实际问题,所以本文档主要适合于那些有一定k ...
- 用winform实现一个B/S代码更新打包工具
一个.net程序员必须拥有的能力就是可以随时随地写出一个自己需要的小工具,于是记录一下我的个人工具吧. 新建一个窗体应用项目,代码如下: namespace 打包工具 { partial class ...
- (一)初识JavaFX
JavaFX是一个强大的图形和多媒体处理工具包集合,它允许开发者来设计.创建.测试.调试和部署富客户端程序,并且和Java一样跨平台. JavaFX应用程序 由于JavaFX库被写成了Java API ...