
SparkMLlib分类算法之支持向量机
SparkMLlib分类算法之支持向量机
(一),概念
支持向量机(support vector machine)是一种分类算法,通过寻求结构化风险最小来提高学习机泛化能力,实现经验风险和置信范围的最小化,从而达到在统计样本量较少的情况下,亦能获得良好统计规律的目的。通俗来讲,它是一种二类分类模型,其基本模型定义为特征空间上的间隔最大的线性分类器,即支持向量机的学习策略便是间隔最大化,最终可转化为一个凸二次规划问题的求解。参考网址:http://www.cnblogs.com/end/p/3848740.html
(二),SparkMLlib中SVM回归应用
1,数据集:参考这篇SparkMLlib学习分类算法之逻辑回归算法
2,处理数据及获取训练集和测试集
val orig_file=sc.textFile("train_nohead.tsv")

    //println(orig_file.first())

    val data_file=orig_file.map(_.split("\t")).map{

      r =>

        val trimmed =r.map(_.replace("\"",""))

        val lable=trimmed(r.length-1).toDouble

        val feature=trimmed.slice(4,r.length-1).map(d => if(d=="?")0.0

        else d.toDouble)

        LabeledPoint(lable,Vectors.dense(feature))

    }

   /*特征标准化优化*/

    val vectors=data_file.map(x =>x.features)

    val rows=new RowMatrix(vectors)

    println(rows.computeColumnSummaryStatistics().variance)//每列的方差

    val scaler=new StandardScaler(withMean=true,withStd=true).fit(vectors)//标准化

    val scaled_data=data_file.map(point => LabeledPoint(point.label,scaler.transform(point.features)))

        .randomSplit(Array(0.7,0.3),11L)

    val data_train=scaled_data(0)

    val data_test=scaled_data(1)
2,建立支持向量机模型及模型评估
 /*训练 SVM 模型**/

    val model_Svm=SVMWithSGD.train(data_train,numIteration)

val correct_svm=data_test.map{

      point => if(model_Svm.predict(point.features)==point.label)

        1 else 0

    }.sum()/data_test.count()//精确度:0.6060885608856088

val metrics=Seq(model_Svm).map{

      model =>

        val socreAndLabels=data_test.map {

          point => (model.predict(point.features), point.label)

        }

        val metrics=new BinaryClassificationMetrics(socreAndLabels)

        (model.getClass.getSimpleName,metrics.areaUnderPR(),metrics.areaUnderROC())

    }

val allMetrics = metrics

    allMetrics.foreach{ case (m, pr, roc) =>

      println(f"$m, Area under PR: ${pr * 100.0}%2.4f%%, Area under ROC: ${roc * 100.0}%2.4f%%")

    }

/*

SVMModel, Area under PR: 72.5527%, Area under ROC: 60.4180%*/
3,模型参数调优
逻辑回归(SGD)和 SVM 模型有相同的参数,原因是它们都使用随机梯度下降( SGD )作为基础优化技术。不同点在于二者采用的损失函数不同
3.1 定义调参函数及模型评估函数
/*调参函数*/

    def trainWithParams(input: RDD[LabeledPoint], regParam: Double,

                        numIterations: Int, updater: Updater, stepSize: Double) = {

      val svm = new SVMWithSGD

      svm.optimizer.setNumIterations(numIterations).

        setUpdater(updater).setRegParam(regParam).setStepSize(stepSize)

      svm.run(input)

    }

    /*评估函数*/

    def createMetrics(label: String, data: RDD[LabeledPoint], model:

    ClassificationModel) = {

      val scoreAndLabels = data.map { point =>

        (model.predict(point.features), point.label)

      }

      val metrics = new BinaryClassificationMetrics(scoreAndLabels)

      (label, metrics.areaUnderROC)

    }
3.2 改变迭代次数(发现一旦完成特定次数的迭代,再增大迭代次数对结果的影响较小)
val iterResults = Seq(1, 5, 10, 50).map { param =>

      val model = trainWithParams(data_train, 0.0, param, new

          SimpleUpdater, 1.0)

      createMetrics(s"$param iterations", data_test, model)

    }

    iterResults.foreach { case (param, auc) => println(f"$param, AUC = ${auc * 100}%2.2f%%") }

/*

1 iterations, AUC = 59.02%

5 iterations, AUC = 60.04%

10 iterations, AUC = 60.42%

50 iterations, AUC = 60.42%

*/
3.3 ,改变步长(以看出步长增长过大对性能有负面影响)
在 SGD 中,在训练每个样本并更新模型的权重向量时,步长用来控制算法在最陡的梯度方向上应该前进多远。较大的步长收敛较快,但是步长太大可能导致收敛到局部最优解。
val stepResults = Seq(0.001, 0.01, 0.1, 1.0, 10.0).map { param =>

      val model = trainWithParams(data_train, 0.0, numIteration, new

          SimpleUpdater, param)

      createMetrics(s"$param step size", data_test, model)

    }

    stepResults.foreach { case (param, auc) => println(f"$param, AUC = ${auc * 100}%2.2f%%") }

/*

0.001 step size, AUC = 59.02%

0.01 step size, AUC = 59.02%

0.1 step size, AUC = 59.01%

1.0 step size, AUC = 60.42%

10.0 step size, AUC = 56.09%

*/
3.4 正则化
val regResults = Seq(0.001, 0.01, 0.1, 1.0, 10.0).map { param =>

      val model = trainWithParams(data_train, param, numIteration,

        new SquaredL2Updater, 1.0)

      createMetrics(s"$param L2 regularization parameter",

        data_test, model)

    }

    regResults.foreach { case (param, auc) => println(f"$param, AUC = ${auc * 100}%2.2f%%") }

/*

0.001 L2 regularization parameter, AUC = 60.42%

0.01 L2 regularization parameter, AUC = 60.42%

0.1 L2 regularization parameter, AUC = 60.37%

1.0 L2 regularization parameter, AUC = 60.56%

10.0 L2 regularization parameter, AUC = 41.54%

*/
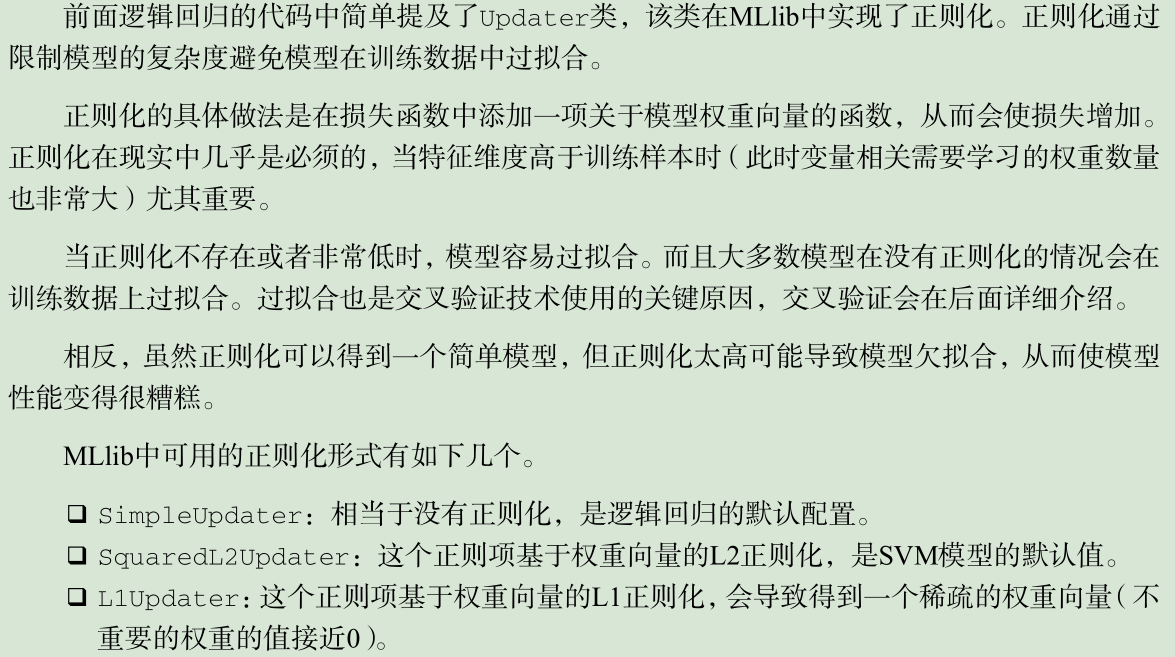
    可以看出,低等级的正则化对模型的性能影响不大。然而,增大正则化可以看到欠拟合会导致较低模型性能。
(三),总结
    1,提高精确度感觉蛮难的,前提还是要先分析数据,对不同特征加以处理吧。。。。。
    2,以后多学习。。。。
SparkMLlib分类算法之支持向量机的更多相关文章
- SparkMLlib分类算法之决策树学习
SparkMLlib分类算法之决策树学习 (一) 决策树的基本概念 决策树(Decision Tree)是在已知各种情况发生概率的基础上,通过构成决策树来求取净现值的期望值大于等于零的概率,评价项目风 ...
- SparkMLlib分类算法之逻辑回归算法
SparkMLlib分类算法之逻辑回归算法 (一),逻辑回归算法的概念(参考网址:http://blog.csdn.net/sinat_33761963/article/details/5169383 ...
- SparkMLlib学习分类算法之逻辑回归算法
SparkMLlib学习分类算法之逻辑回归算法 (一),逻辑回归算法的概念(参考网址:http://blog.csdn.net/sinat_33761963/article/details/51693 ...
- [分类算法] :SVM支持向量机
Support vector machines 支持向量机,简称SVM 分类算法的目的是学会一个分类函数或者分类模型(分类器),能够把数据库中的数据项映射给定类别中的某一个,从而可以预测未知类别. S ...
- Spark-Mllib中各分类算法的java实现(简易教程)
一.简述 Spark是当下非常流行的数据分析框架,而其中的机器学习包Mllib也是其诸多亮点之一,相信很多人也像我那样想要快些上手spark.下面我将列出实现mllib分类的简明代码,代码中将简述训练 ...
- 分类算法SVM(支持向量机)
支持向量机(Support Vector Machine ,SVM)的主要思想是:建立一个最优决策超平面,使得该平面两侧距离该平面最近的两类样本之间的距离最大化,从而对分类问题提供良好的泛化能力.对于 ...
- Netflix工程总监眼中的分类算法:深度学习优先级最低
Netflix工程总监眼中的分类算法:深度学习优先级最低 摘要:不同分类算法的优势是什么?Netflix公司工程总监Xavier Amatriain根据奥卡姆剃刀原理依次推荐了逻辑回归.SVM.决策树 ...
- SparkMLib分类算法之朴素贝叶斯分类
SparkMLib分类算法之朴素贝叶斯分类 (一)朴素贝叶斯分类理解 朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法.简单来说,朴素贝叶斯分类器假设样本每个特征与其他特征都不相关.举个例子, ...
- R语言与分类算法的绩效评估(转)
关于分类算法我们之前也讨论过了KNN.决策树.naivebayes.SVM.ANN.logistic回归.关于这么多的分类算法,我们自然需要考虑谁的表现更加的优秀. 既然要对分类算法进行评价,那么我们 ...
随机推荐
- 【Android】error opening trace file: No such file or directory (2)
1.问题描述: 运行报错: 12-25 13:35:32.286: E/Trace(1202): error opening trace file: No such file or directory ...
- 看Lucene源码必须知道的基本概念
终于有时间总结点Lucene,虽然是大周末的,已经感觉是对自己的奖励,毕竟只是喜欢,现在的工作中用不到的.自己看源码比较快,看英文原著的技术书也很快.都和语言有很大关系.虽然咱的技术不敢说是部门第一的 ...
- SpringMVC基础学习(一)—初识SpringMVC
一.HelloWorld 1.导入SpringMVC所需的jar包 2.配置web.xml 配置DispatcherServlet.DispatcherServlet默认加载/ ...
- MySQL一个简单的存储过程demo
使用的工具是Navicat for MySQL. 首先创建一个学生表 mysql) ) ) auto_increment,age ) ) not null,primary key(s_no)); Qu ...
- 浩哥解析MyBatis源码(十)——Type类型模块之类型处理器
原创作品,可以转载,但是请标注出处地址:http://www.cnblogs.com/V1haoge/p/6715063.html 1.回顾 之前的两篇分别解析了类型别名注册器和类型处理器注册器,此二 ...
- vue-router2 使用
VUE-ROUTER2 API http://router.vuejs.org/zh-cn/api/router-link.html 1,安装vue-router npm install vue ...
- node.js系列(模块):request模块实现与php的通讯
app.js: var express = require('express'); var request = require('request'); var app = express(); /*r ...
- javaweb项目中发布webservices服务
1.新建一个项目动态web项目Axis2Server. 2.解压缩下载的axis2-1.7.4-war.zip文件--〉axis2-1.7.4-war--〉axis2.war--〉axis2,找到WE ...
- python在接口测试的实际应用
今天看到@51Testing软件测试网 关于"关于接口测试的总结"的文章,进去浏览了一下,文章主要是针对接口测试的理论性的描述,而实战的内容没有涉及到.刚好今天我将我的系列文章的& ...
- 10个漂亮的jQuery日历插件下载【转载】
10个漂亮的jQuery日历插件下载 2013-08-07 标签:jQuery日历插件jQuery日历jQuery插件 日期是非常重要的,随时随地.微薄或网站的日期选取器日历必须在那里.您可以使用 ...