
SparkMLlib分类算法之决策树学习
SparkMLlib分类算法之决策树学习
(一) 决策树的基本概念
决策树(Decision Tree)是在已知各种情况发生概率的基础上,通过构成决策树来求取净现值的期望值大于等于零的概率,评价项目风险,判断其可行性的决策分析方法,是直观运用概率分析的一种图解法。由于这种决策分支画成图形很像一棵树的枝干,故称决策树。在机器学习中,决策树是一个预测模型,他代表的是对象属性与对象值之间的一种映射关系。Entropy = 系统的凌乱程度,使用算法ID3, C4.5和C5.0生成树算法使用熵。这一度量是基于信息学理论中熵的概念。通过信息增益来筛选出属性的优先性。

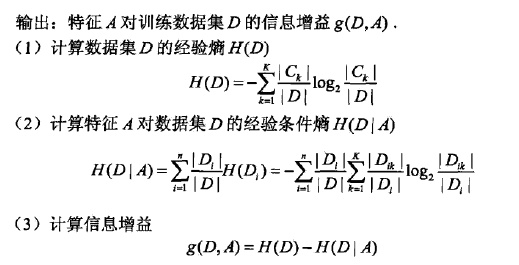
缺点:参考网址:http://www.ppvke.com/Blog/archives/25042
val orig_file=sc.textFile("train_nohead.tsv")

    //println(orig_file.first())

    val data_file=orig_file.map(_.split("\t")).map{

      r =>

        val trimmed =r.map(_.replace("\"",""))

        val lable=trimmed(r.length-1).toDouble

        val feature=trimmed.slice(4,r.length-1).map(d => if(d=="?")0.0

        else d.toDouble)

        LabeledPoint(lable,Vectors.dense(feature))

    }

   /*特征标准化优化,似乎对决策数没啥影响*/

    val vectors=data_file.map(x =>x.features)

    val rows=new RowMatrix(vectors)

    println(rows.computeColumnSummaryStatistics().variance)//每列的方差

    val scaler=new StandardScaler(withMean=true,withStd=true).fit(vectors)//标准化

    val scaled_data=data_file.map(point => LabeledPoint(point.label,scaler.transform(point.features)))

        .randomSplit(Array(0.7,0.3),11L)//固定seed为11L,确保每次每次实验能得到相同的结果

    val data_train=scaled_data(0)

    val data_test=scaled_data(1)
3,构建模型及模型评价
/*训练决策树模型*/

    val model_DT=DecisionTree.train(data_train,Algo.Classification,Entropy,maxTreeDepth)

 /*决策树的精确度*/

    val predectionAndLabeledDT=data_test.map { point =>

      val predectLabeled = if (model_DT.predict(point.features) > 0.5) 1.0 else 0.0

      (predectLabeled,point.label)

    }

    val metricsDT=new MulticlassMetrics(predectionAndLabeledDT)

    println(metricsDT.accuracy)//0.6273062730627307

/*决策树的PR曲线和AOC曲线*/

    val dtMetrics = Seq(model_DT).map{ model =>

      val scoreAndLabels = data_test.map { point =>

        val score = model.predict(point.features)

        (if (score > 0.5) 1.0 else 0.0, point.label)

      }

      val metrics = new BinaryClassificationMetrics(scoreAndLabels)

      (model.getClass.getSimpleName, metrics.areaUnderPR, metrics.areaUnderROC)

    }

    val allMetrics = dtMetrics

    allMetrics.foreach{ case (m, pr, roc) =>

      println(f"$m, Area under PR: ${pr * 100.0}%2.4f%%, Area under ROC: ${roc * 100.0}%2.4f%%")

    }

/*

DecisionTreeModel, Area under PR: 74.2335%, Area under ROC: 62.4326%

*/
4,模型参数调优(可以调解长度和纯度两方面考虑)
4.1 构建调参函数
/*调参函数*/

    def trainDTWithParams(input: RDD[LabeledPoint], maxDepth: Int,

                          impurity: Impurity) = {

      DecisionTree.train(input, Algo.Classification, impurity, maxDepth)

    }
4.2 调解树的深度评估函数 (提高树的深度可以得到更精确的模型(这和预期一致,因为模型在更大的树深度下会变得更加复杂)。然而树的深度越大,模型对训练数据过拟合程度越严重)
 /*改变深度*/

    val dtResultsEntropy = Seq(1, 2, 3, 4, 5, 10, 20).map { param =>

      val model = trainDTWithParams(data_train, param, Entropy)

      val scoreAndLabels = data_test.map { point =>

        val score = model.predict(point.features)

        (if (score > 0.5) 1.0 else 0.0, point.label)

      }

      val metrics = new BinaryClassificationMetrics(scoreAndLabels)

      (s"$param tree depth", metrics.areaUnderROC)

    }

    dtResultsEntropy.foreach { case (param, auc) => println(f"$param, " +

      f"AUC = ${auc * 100}%2.2f%%") }

/*

1 tree depth, AUC = 58.57%

2 tree depth, AUC = 60.69%

3 tree depth, AUC = 61.40%

4 tree depth, AUC = 61.30%

5 tree depth, AUC = 62.43%

10 tree depth, AUC = 62.26%

20 tree depth, AUC = 60.59%

*/
2,调解纯度参数 (差异不是很明显。。)
 /*改变纯度*/

    val dtResultsEntropy = Seq(Gini,Entropy).map { param =>

      val model = trainDTWithParams(data_train, 5, param)

      val scoreAndLabels = data_test.map { point =>

        val score = model.predict(point.features)

        (if (score > 0.5) 1.0 else 0.0, point.label)

      }

      val metrics = new BinaryClassificationMetrics(scoreAndLabels)

      (s"$param tree depth", metrics.areaUnderROC)

    }

    dtResultsEntropy.foreach { case (param, auc) => println(f"$param, " +

      f"AUC = ${auc * 100}%2.2f%%") }

/*

org.apache.spark.mllib.tree.impurity.Gini$@32d8e58d tree depth, AUC = 62.37%

org.apache.spark.mllib.tree.impurity.Entropy$@1ddba7a0 tree depth, AUC = 62.43%

*/
(三) 交叉验证
1,数据集分类
创建三个数据集:训练集
评估集(类似上述测试集用于模型参数的调优,比如 lambda 和步长)
测试集(不用于模型的训练和参数调优,只用于估计模型在新数据中性能)
2,交叉验证的常用方法
一个流行的方法是 K- 折叠交叉验证,其中数据集被分成 K 个不重叠的部分。用数据中的 K-1 份训练模型,剩下一部分测试模型。而只分训练集和测试集可以看做是 2- 折叠交叉验证。
还有“留一交叉验证”和“随机采样”。更多资料详见 http://en.wikipedia.org/wiki/Cross-validation_(statistics) 。
SparkMLlib分类算法之决策树学习的更多相关文章
- Netflix工程总监眼中的分类算法:深度学习优先级最低
Netflix工程总监眼中的分类算法:深度学习优先级最低 摘要:不同分类算法的优势是什么?Netflix公司工程总监Xavier Amatriain根据奥卡姆剃刀原理依次推荐了逻辑回归.SVM.决策树 ...
- SparkMLlib分类算法之支持向量机
SparkMLlib分类算法之支持向量机 (一),概念 支持向量机(support vector machine)是一种分类算法,通过寻求结构化风险最小来提高学习机泛化能力,实现经验风险和置信范围的最 ...
- SparkMLlib回归算法之决策树
SparkMLlib回归算法之决策树 (一),决策树概念 1,决策树算法(ID3,C4.5 ,CART)之间的比较: 1,ID3算法在选择根节点和各内部节点中的分支属性时,采用信息增益作为评价标准.信 ...
- SparkMLlib分类算法之逻辑回归算法
SparkMLlib分类算法之逻辑回归算法 (一),逻辑回归算法的概念(参考网址:http://blog.csdn.net/sinat_33761963/article/details/5169383 ...
- 【分类算法】决策树(Decision Tree)
(注:本篇博文是对<统计学习方法>中决策树一章的归纳总结,下列的一些文字和图例均引自此书~) 决策树(decision tree)属于分类/回归方法.其具有可读性.可解释性.分类速度快等优 ...
- (ZT)算法杂货铺——分类算法之决策树(Decision tree)
https://www.cnblogs.com/leoo2sk/archive/2010/09/19/decision-tree.html 3.1.摘要 在前面两篇文章中,分别介绍和讨论了朴素贝叶斯分 ...
- 数据挖掘分类算法之决策树(zz)
决策树(Decision tree) 决策树是以实例为基础的归纳学习算法. 它从一组无次序.无规则的元组中推理出决策树表示形式的分类规则.它采用自顶向下的递归方式,在决策树的内部结点进行属性值 ...
- 分类算法:决策树(C4.5)(转)
C4.5是机器学习算法中的另一个分类决策树算法,它是基于ID3算法进行改进后的一种重要算法,相比于ID3算法,改进有如下几个要点: 1)用信息增益率来选择属性.ID3选择属性用的是子树的信息增益,这里 ...
- SparkMLlib学习分类算法之逻辑回归算法
SparkMLlib学习分类算法之逻辑回归算法 (一),逻辑回归算法的概念(参考网址:http://blog.csdn.net/sinat_33761963/article/details/51693 ...
随机推荐
- Python实现QQ自动点赞
用Python做一个QQ自动点赞神器,上代码: 1 def QQZan(qq): 2 browser = webdriver.Chrome() 3 browser.maximize_window() ...
- POJ 2891 Strange Way to Express Integers 中国剩余定理 数论 exgcd
http://poj.org/problem?id=2891 题意就是孙子算经里那个定理的基础描述不过换了数字和约束条件的个数…… https://blog.csdn.net/HownoneHe/ar ...
- 慎用 new、delete
C++ STL 为我们提供了一套容器.在多数情况下,这套容器已足够让我们使用.所以,需要我们自己去用 new/new []/delete/delete [] 来管理内存的必要性并不是很大.此外,自己管 ...
- java知识点总结
一.java 1.容器 1)List Java中ArrayList和LinkedList区别 2)Set 理解HashSet及使用 HashMap和HashSet的区别 3Map HashMap的容量 ...
- Lunix/Mac下根据最后修改时间复制文件和文件夹,保持原有的目录结构
度娘知道:http://zhidao.baidu.com/link?url=DD47jm6qDgT7yxsnz9e-NC4Fqd33oRoiIwcGLkw5TL4cbf50VKY2IONbHKH0IE ...
- python开发_thread_线程_搜索本地文件
在之前的blog中,曾经写到过关于搜索本地文件的技术文章 如: java开发_快速搜索本地文件_小应用程序 python开发_搜索本地文件信息写入文件 下面说说python中关于线程来搜索本地文件 利 ...
- DEX 可视化查阅
参考: http://bbs.pediy.com/thread-208828.htm 010 Editor 下载地址: http://www.sweetscape.com/download/ //-- ...
- iOS 视频组件
公司最近要在项目里新增一个随手拍的功能,所以呢我在网上找了个比较不错的demo,顺便研究了下它的代码结构.感谢大神的分享,如有侵权,请告知哦!
- angularjs鼠标移入移出实现显示隐藏
<tr ng-repeat="item in items track by $index"> <td data-title="操作" alig ...
- MYSQL 源代码编绎脚本
http://blog.csdn.net/hopingwhite/article/details/5808101