
大数据系列之数据仓库Hive原理
Hive系列博文,持续更新~~~
大数据系列之数据仓库Hive原理
大数据系列之数据仓库Hive安装
大数据系列之数据仓库Hive中分区Partition如何使用
大数据系列之数据仓库Hive命令使用及JDBC连接
Hive的工作原理简单来说就是一个查询引擎
先来一张Hive的架构图:
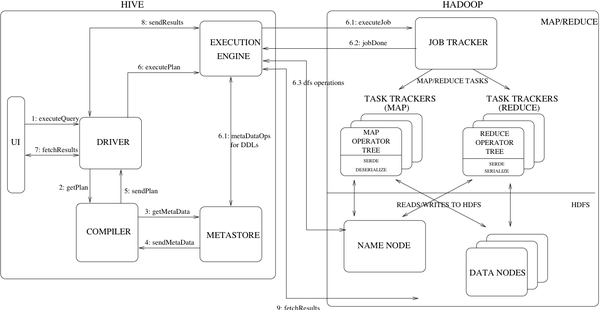
Hive的工作原理如下:
接收到一个sql,后面做的事情包括:
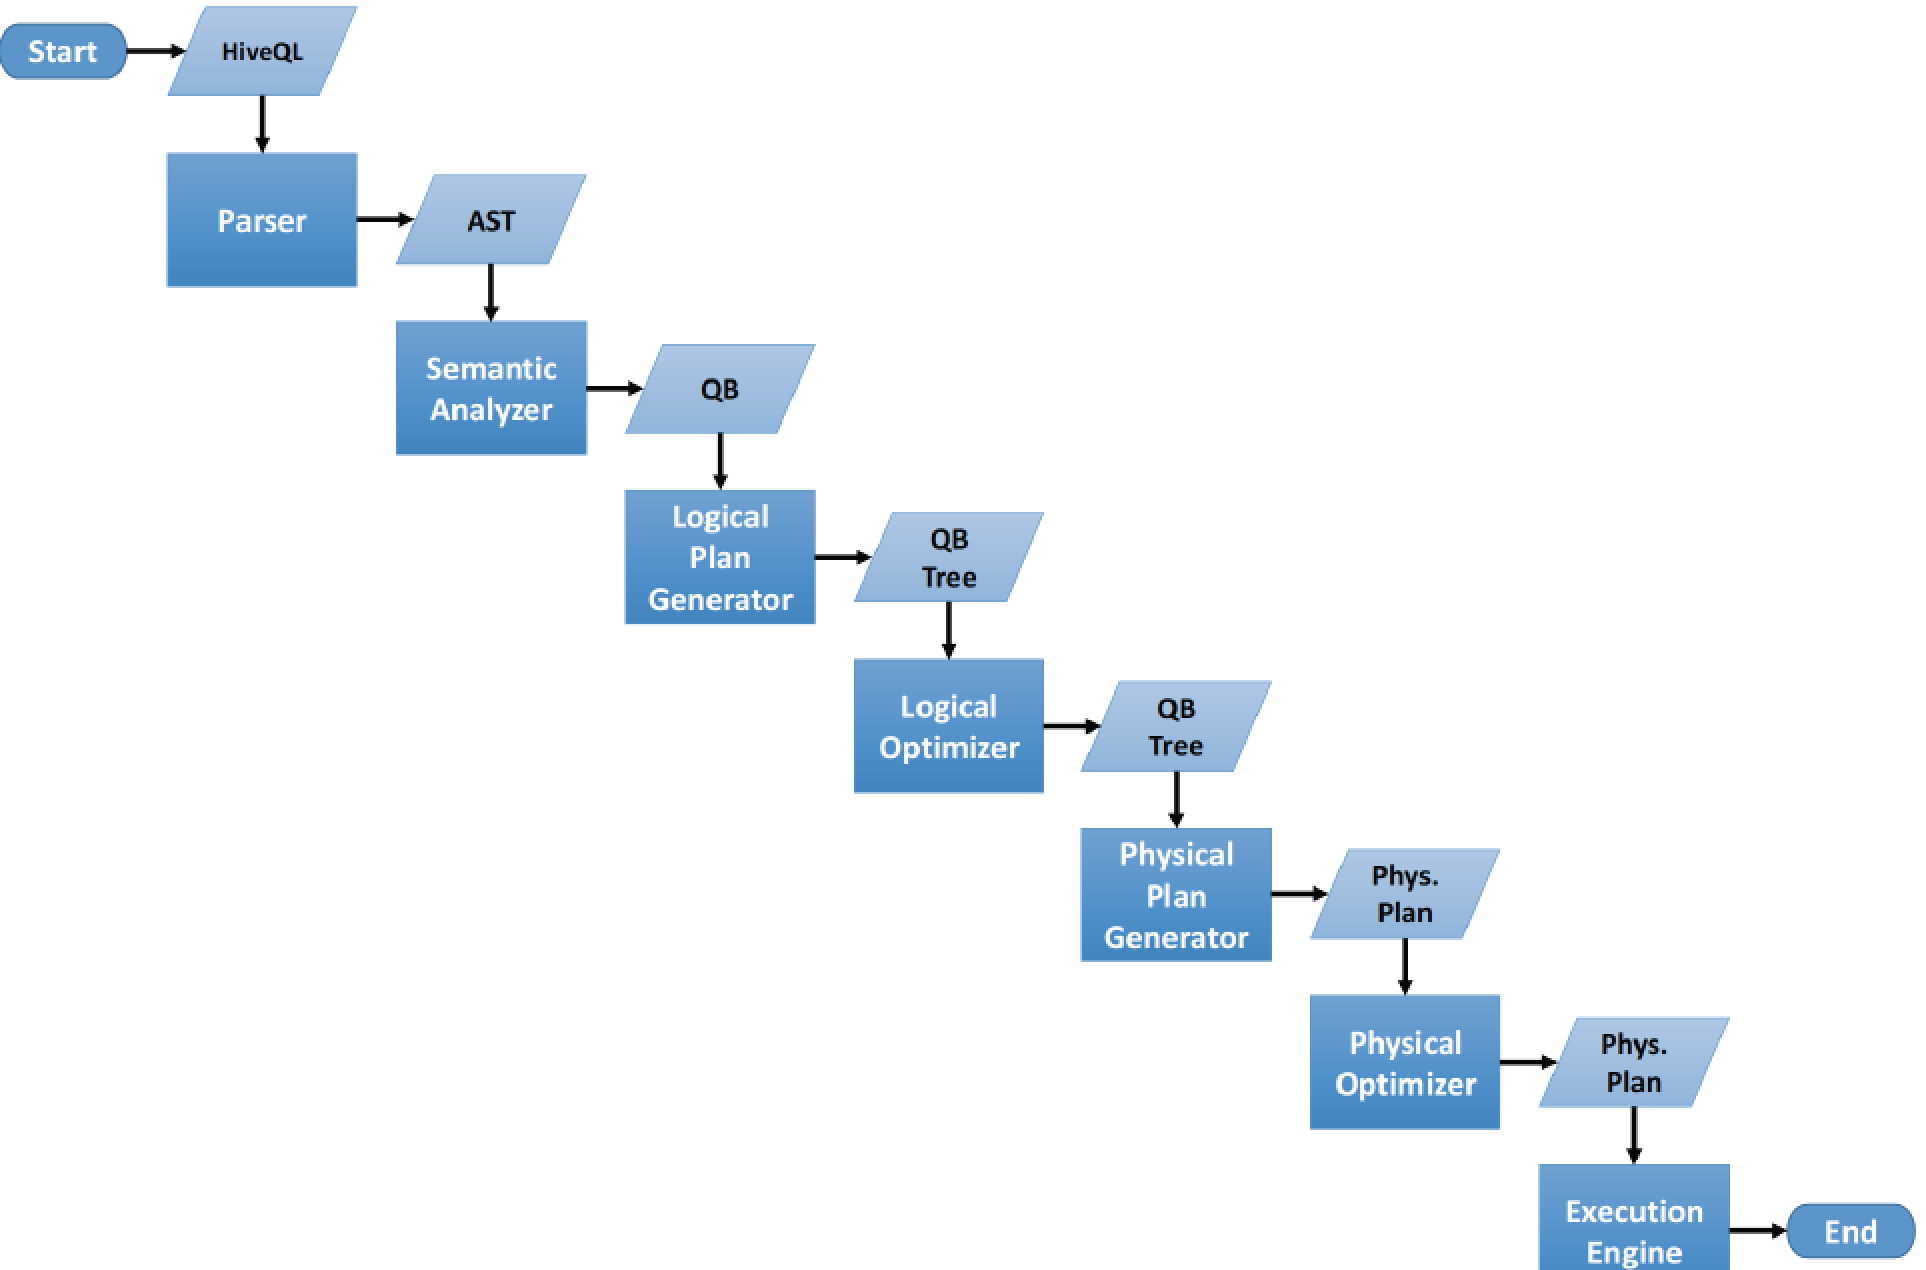
1.词法分析/语法分析
使用antlr将SQL语句解析成抽象语法树-AST
2.语义分析
从Megastore获取模式信息,验证SQL语句中队表名,列名,以及数据类型的检查和隐式转换,以及Hive提供的函数和用户自定义的函数(UDF/UAF)
3.逻辑计划生产
生成逻辑计划-算子树
4.逻辑计划优化
对算子树进行优化,包括列剪枝,分区剪枝,谓词下推等
5.物理计划生成
将逻辑计划生产包含由MapReduce任务组成的DAG的物理计划
6.物理计划执行
将DAG发送到Hadoop集群进行执行
7.将查询结果返回
流程如下图:
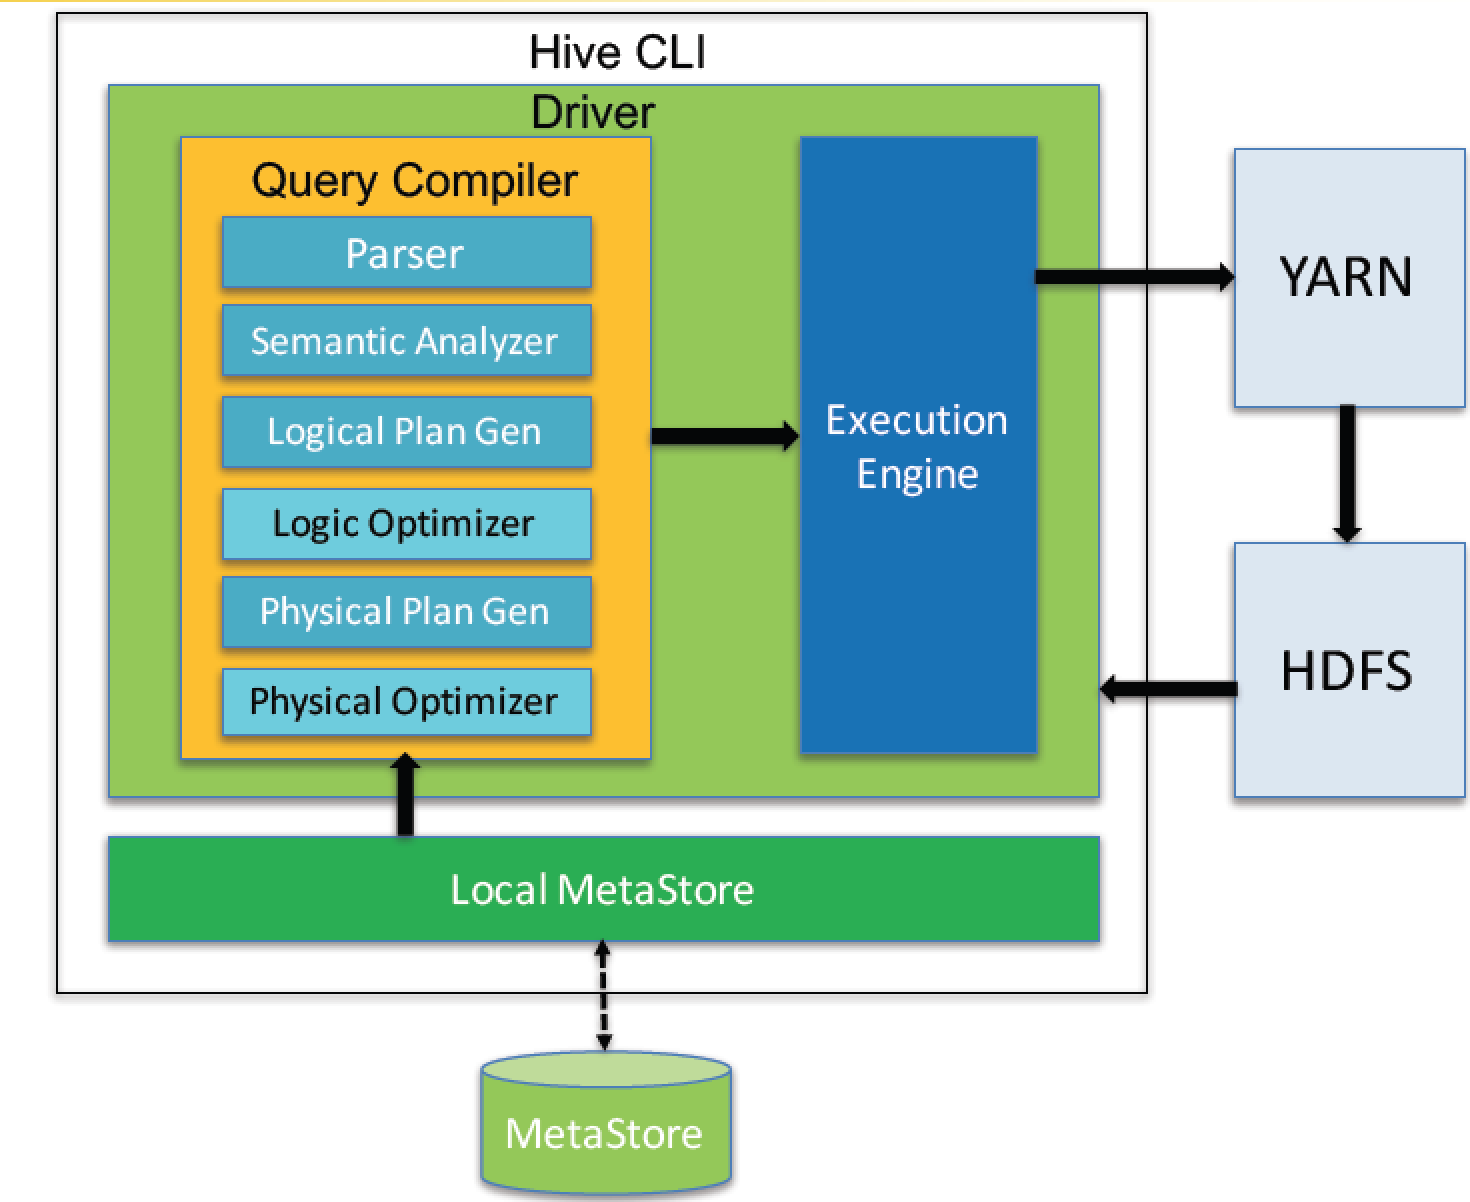
Query Compiler
新版本的Hive也支持使用Tez或Spark作为执行引擎。
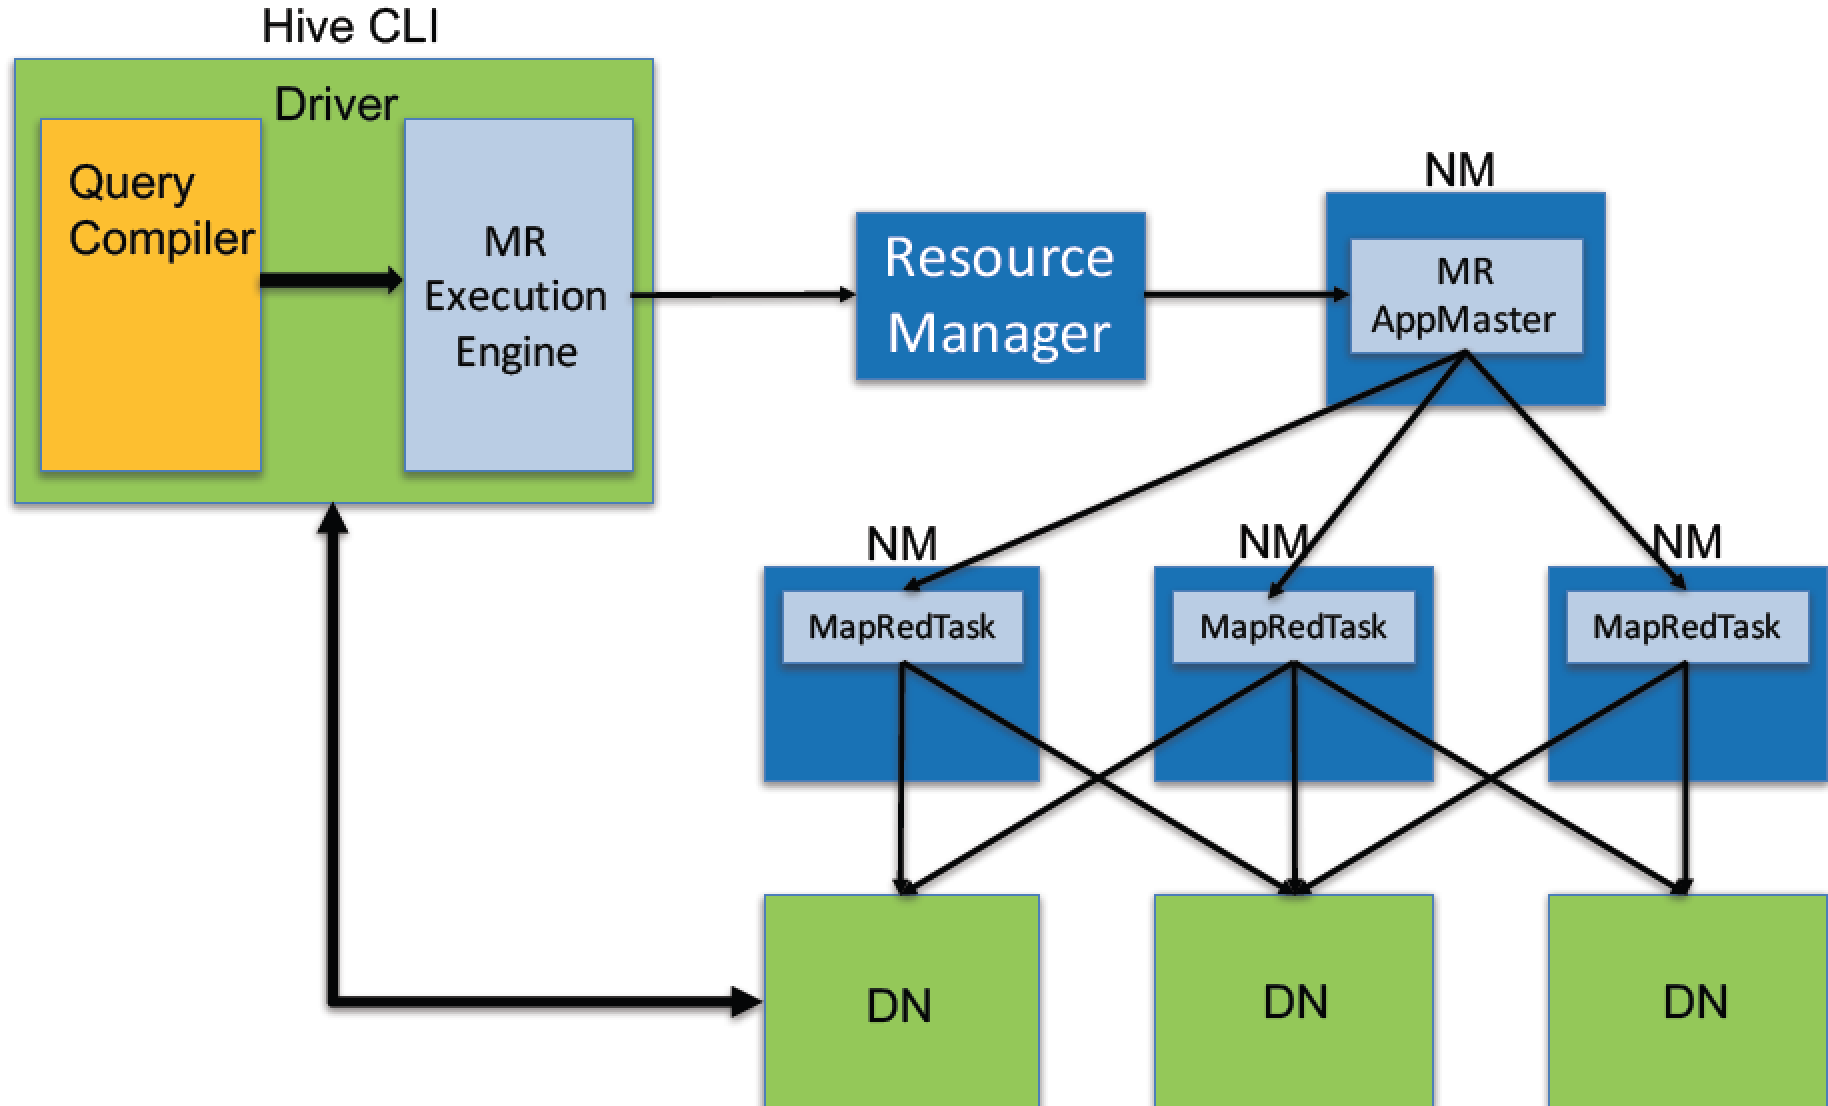

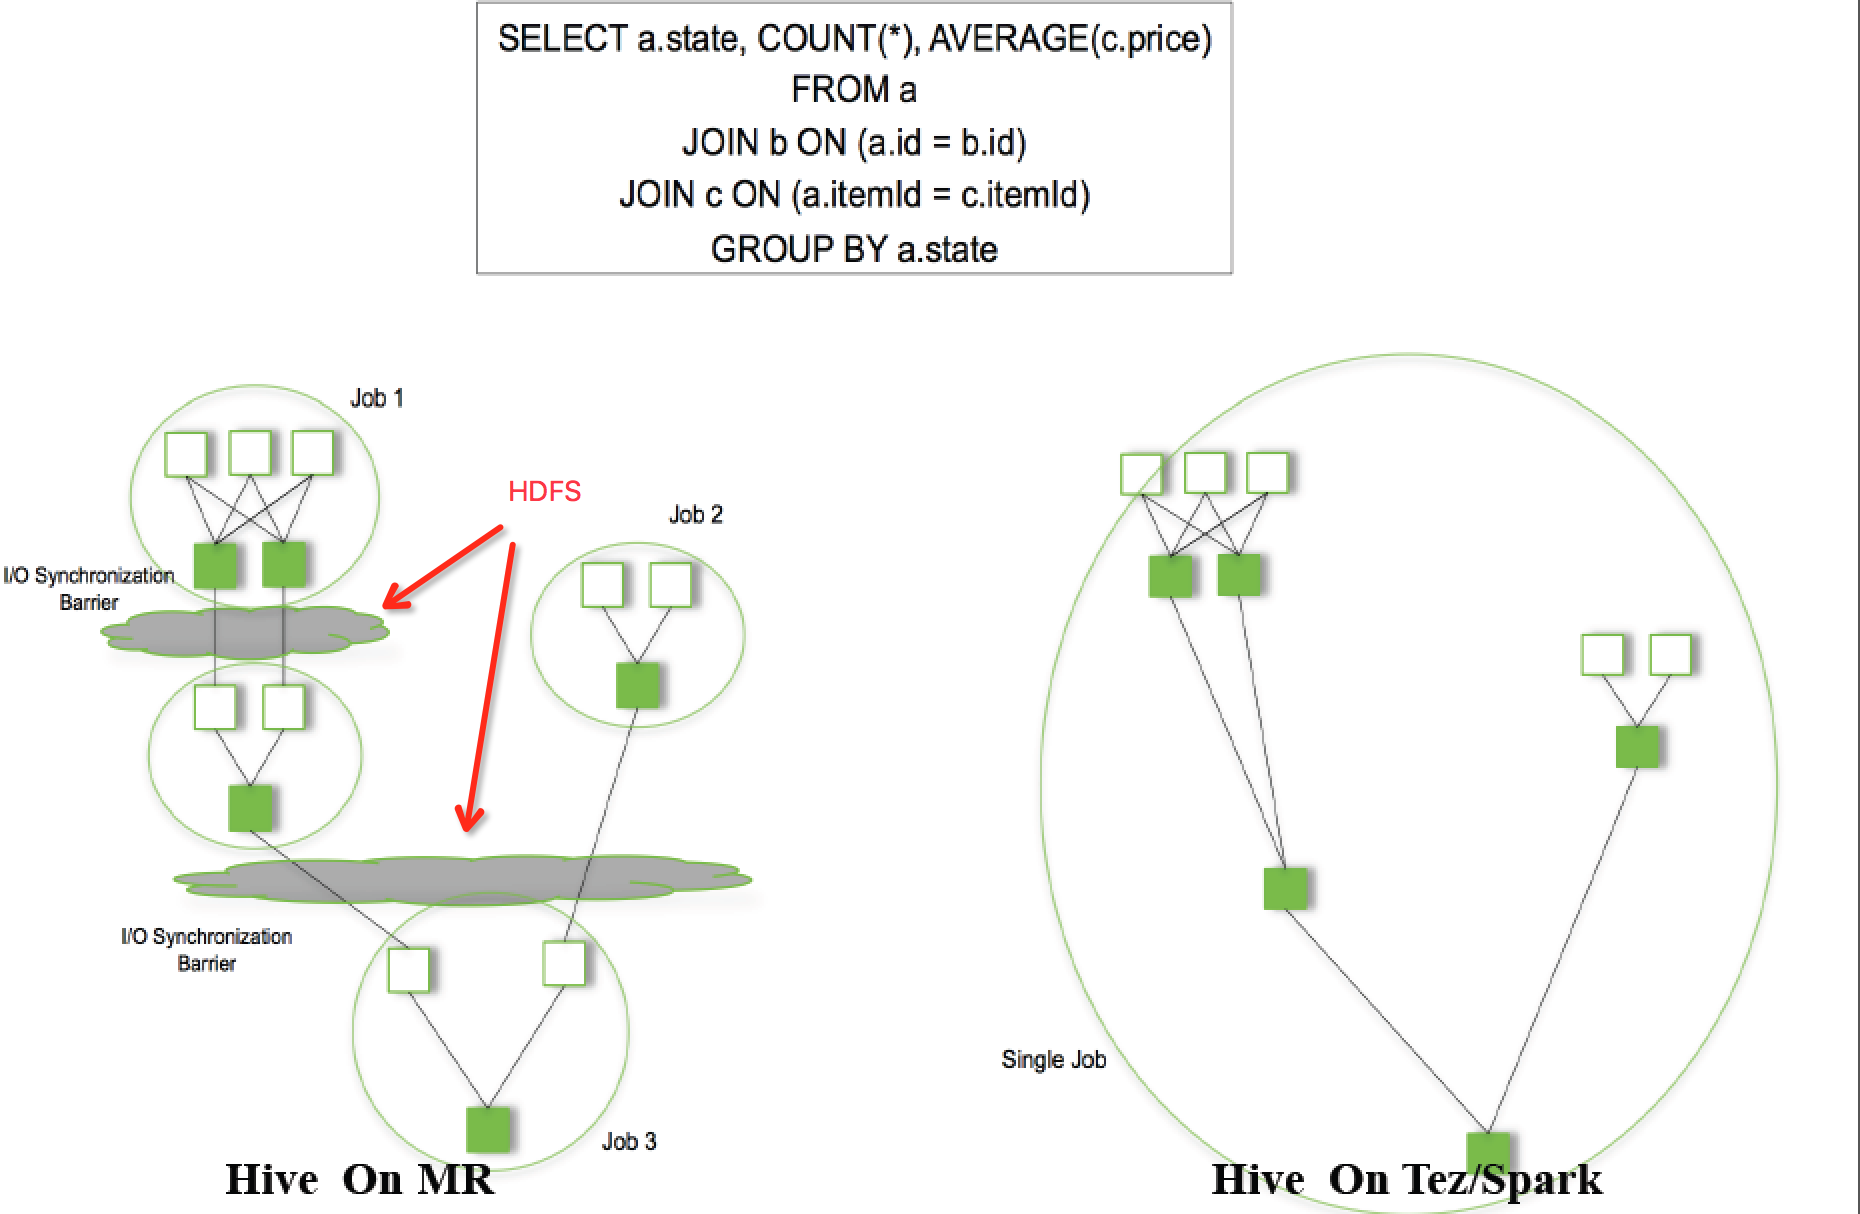
物理计划可以通过hive的Explain命令输出
例如:
: jdbc:hive2://master:10000/dbmfz> explain select count(*) from record_dimension;

+------------------------------------------------------------------------------------------------------+--+

|                                               Explain                                                |

+------------------------------------------------------------------------------------------------------+--+

| STAGE DEPENDENCIES:                                                                                  |

|   Stage- is a root stage                                                                            |

|   Stage- depends on stages: Stage-                                                                 |

|                                                                                                      |

| STAGE PLANS:                                                                                         |

|   Stage: Stage-                                                                                     |

|     Map Reduce                                                                                       |

|       Map Operator Tree:                                                                             |

|           TableScan                                                                                  |

|             alias: record_dimension                                                                  |

|             Statistics: Num rows:  Data size:  Basic stats: COMPLETE Column stats: COMPLETE      |

|             Select Operator                                                                          |

|               Statistics: Num rows:  Data size:  Basic stats: COMPLETE Column stats: COMPLETE    |

|               Group By Operator                                                                      |

|                 aggregations: count()                                                                |

|                 mode: hash                                                                           |

|                 outputColumnNames: _col0                                                             |

|                 Statistics: Num rows:  Data size:  Basic stats: COMPLETE Column stats: COMPLETE    |

|                 Reduce Output Operator                                                               |

|                   sort order:                                                                        |

|                   Statistics: Num rows:  Data size:  Basic stats: COMPLETE Column stats: COMPLETE  |

|                   value expressions: _col0 (type: bigint)                                            |

|       Reduce Operator Tree:                                                                          |

|         Group By Operator                                                                            |

|           aggregations: count(VALUE._col0)                                                           |

|           mode: mergepartial                                                                         |

|           outputColumnNames: _col0                                                                   |

|           Statistics: Num rows:  Data size:  Basic stats: COMPLETE Column stats: COMPLETE          |

|           File Output Operator                                                                       |

|             compressed: false                                                                        |

|             Statistics: Num rows:  Data size:  Basic stats: COMPLETE Column stats: COMPLETE        |

|             table:                                                                                   |

|                 input format: org.apache.hadoop.mapred.SequenceFileInputFormat                       |

|                 output format: org.apache.hadoop.hive.ql.io.HiveSequenceFileOutputFormat             |

|                 serde: org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe                            |

|                                                                                                      |

|   Stage: Stage-                                                                                     |

|     Fetch Operator                                                                                   |

|       limit: -                                                                                      |

|       Processor Tree:                                                                                |

|         ListSink                                                                                     |

|                                                                                                      |

+------------------------------------------------------------------------------------------------------+--+

 rows selected (0.844 seconds)
除了DML,Hive也提供DDL来创建表的schema。
Hive数据存储支持HDFS的一些文件格式,比如CSV,Sequence File,Avro,RC File,ORC,Parquet。也支持访问HBase。
Hive提供一个CLI工具,类似Oracle的sqlplus,可以交互式执行sql,提供JDBC驱动作为Java的API。
转载请注明出处:
作者:mengfanzhu
原文链接:http://www.cnblogs.com/cnmenglang/p/6684615.html
大数据系列之数据仓库Hive原理的更多相关文章
- 大数据系列之数据仓库Hive安装
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之数据仓库Hive命令使用及JDBC连接
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之数据仓库Hive中分区Partition如何使用
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 【大数据系列】apache hive 官方文档翻译
GettingStarted 开始 Created by Confluence Administrator, last modified by Lefty Leverenz on Jun 15, 20 ...
- 大数据系列(3)——Hadoop集群完全分布式坏境搭建
前言 上一篇我们讲解了Hadoop单节点的安装,并且已经通过VMware安装了一台CentOS 6.8的Linux系统,咱们本篇的目标就是要配置一个真正的完全分布式的Hadoop集群,闲言少叙,进入本 ...
- 大数据系列之并行计算引擎Spark介绍
相关博文:大数据系列之并行计算引擎Spark部署及应用 Spark: Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎. Spark是UC Berkeley AMP lab ( ...
- 大数据系列之分布式计算批处理引擎MapReduce实践
关于MR的工作原理不做过多叙述,本文将对MapReduce的实例WordCount(单词计数程序)做实践,从而理解MapReduce的工作机制. WordCount: 1.应用场景,在大量文件中存储了 ...
- 大数据系列(5)——Hadoop集群MYSQL的安装
前言 有一段时间没写文章了,最近事情挺多的,现在咱们回归正题,经过前面四篇文章的介绍,已经通过VMware安装了Hadoop的集群环境,相关的两款软件VSFTP和SecureCRT也已经正常安装了. ...
- 大数据系列(4)——Hadoop集群VSFTP和SecureCRT安装配置
前言 经过前三篇文章的介绍,已经通过VMware安装了Hadoop的集群环境,当然,我相信安装的过程肯定遇到或多或少的问题,这些都需要自己解决,解决的过程就是学习的过程,本篇的来介绍几个Hadoop环 ...
随机推荐
- MT【158】只在此山中,云深不知处
求证:方程$3ax^2+2bx-(a+b)=0(b\ne0)$在$(0,1)$内至少有一个实数根. 提示:$f(0)=-(a+b),f(\dfrac{2}{3})=\dfrac{1}{3}(a+b)$ ...
- hdu 3307 简单的指数循环节
#include<stdio.h>#include<string.h>#include<algorithm>#define LL __int64using name ...
- 【BZOJ1052】覆盖问题(贪心)
[BZOJ1052]覆盖问题(贪心) 题面 BZOJ 洛谷 题解 这题好神仙啊. 很明显可以看出来要二分一个边长. 那么如何\(check\)呢? 我们把所有点用一个最小矩形覆盖, 那么必定每个边界上 ...
- 【Cf #290 C】Fox And Dinner(最大流)
如果要相邻两个数(a[i] >= 2)相加为质数,显然它们的奇偶性不同,也就是说一个圆桌(环)必须是偶环. 也就是答案的若干个环组成了一张二分图,其中以奇偶分色. 考虑每个点的度数一定为2,用最 ...
- BZOJ2876 [Noi2012]骑行川藏 【拉格朗日乘数法】
题目链接 BZOJ 题解 拉格朗日乘数法 拉格朗日乘数法用以求多元函数在约束下的极值 我们设多元函数\(f(x_1,x_2,x_3,\dots,x_n)\) 以及限制\(g(x_1,x_2,x_3,\ ...
- 第五周linux学习笔记
第五章 系统调用 5.1 与内核通信 系统调用在用户空间进程和硬件设备之间添加了一个中间层.该层主要作用有三个. 它为用户空间提供了一种硬件的抽象接口. 系统调用保 证了系统的毡定和安全. 在第 3 ...
- JS的作用域和闭包
1.作用域 作用域是根据名称找变量的一套规则. 变量的赋值操作会执行两个动作,首先编译器会在当前作用域中声明一个变量(如果之前没有声明过),然后在运行时引擎会在作用域中查找该变量,如果能够找到就会对它 ...
- android app 的插件化、组件化、模块化开发
Android 插件化 ——指将一个程序划分为不同的部分,比如一般 App的皮肤样式就可以看成一个插件 Android 组件化 ——这个概念实际跟上面相差不那么明显,组件和插件较大的区别就是:组件是指 ...
- Android中EditText显示明文与密码的两种方式
效果图如下所述: <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:and ...
- codeforces div1 & div2 参与人员分数统计
Analysis helps to see the nature of things.