
网络爬虫BeautifulSoup库的使用
使用BeautifulSoup库提取HTML页面信息
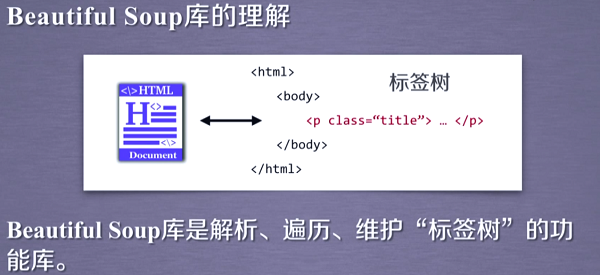
#!/usr/bin/python3

import requests

from bs4 import BeautifulSoup

url='http://python123.io/ws/demo.html'

r=requests.get(url)

if r.status_code==:

    print('网络请求成功')

demo=r.text

soup=BeautifulSoup(demo,'html.parser')

print(soup.prettify())
BeautifulSoup类的基本属性
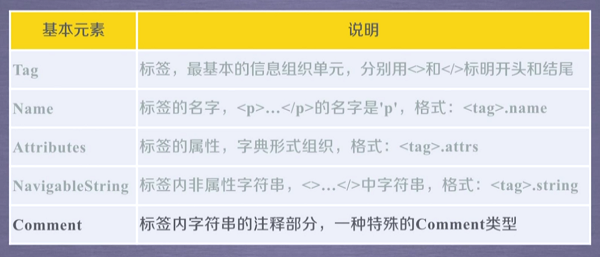
#!/usr/bin/python3

import requests

from bs4 import BeautifulSoup

url='http://python123.io/ws/demo.html'

r=requests.get(url)

if r.status_code==:

    print('网络请求成功')

demo=r.text

soup=BeautifulSoup(demo,'html.parser')

tag_title=soup.title

print(tag_title)

tag_a_attrs=soup.a.attrs

print(soup.p.string)
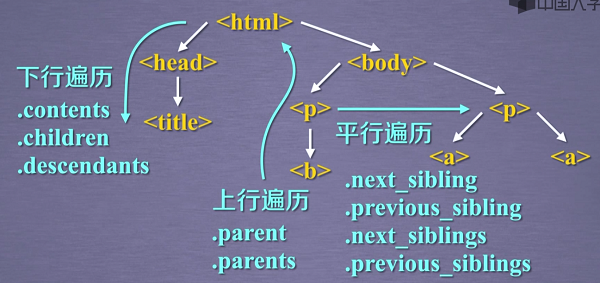
标签树的下行遍历
#!/usr/bin/python3

import requests

from bs4 import BeautifulSoup

url='http://python123.io/ws/demo.html'

r=requests.get(url)

if r.status_code==200:

    print('网络请求成功')

demo=r.text

soup=BeautifulSoup(demo,'html.parser')

print(soup.prettify())

print('我是分割线'.center(80,'-'))

#遍历子节点

for child in soup.body.children:

    print(child)

#遍历子孙节点

for descendant in soup.body.descendants:

    print(descendant)
标签树的上行遍历

遍历title标签的上一级标签
print(soup.title.parent)
#a标签的下一标签

print(soup.a.next_sibling)
遍历a标签的所有前序节点以及后续节点
#遍历a标签的前序节点

for sibling in soup.a.next_siblings:

    print(sibling)

#遍历a标签的前序节点

for sibling in soup.a.previous_siblings:

    print(sibling)
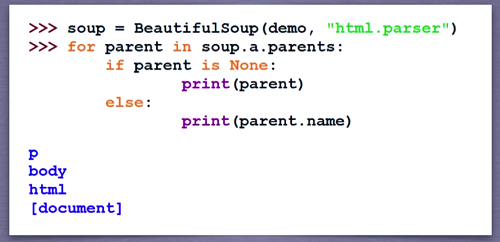
soup标签的上一级标签为空,所以要进行判断
网络爬虫BeautifulSoup库的使用的更多相关文章
- Python爬虫-- BeautifulSoup库
BeautifulSoup库 beautifulsoup就是一个非常强大的工具,爬虫利器.一个灵活又方便的网页解析库,处理高效,支持多种解析器.利用它就不用编写正则表达式也能方便的实现网页信息的抓取 ...
- 2.03_01_Python网络爬虫urllib2库
一:urllib2库的基本使用 所谓网页抓取,就是把URL地址中指定的网络资源从网络流中抓取出来.在Python中有很多库可以用来抓取网页,我们先学习urllib2. urllib2 是 Python ...
- Python网络爬虫——BeautifulSoup4库的使用
使用requests库获取html页面并将其转换成字符串之后,需要进一步解析html页面格式,提取有用信息. BeautifulSoup4库,也被成为bs4库(后皆采用简写)用于解析和处理html和x ...
- [爬虫] BeautifulSoup库
Beautiful Soup库基础知识 Beautiful Soup库是解析xml和html的功能库.html.xml大都是一对一对的标签构成,所以Beautiful Soup库是解析.遍历.维护“标 ...
- python爬虫BeautifulSoup库class_
因为class是python的关键字,所以在写过滤的时候,应该是这样写: r = requests.get(web_url, headers=headers) # 向目标url地址发送get请求,返回 ...
- 网络爬虫--requests库中两个重要的对象
当我们使用resquests.get()时,返回的时response的对象,他包含服务器返回的所有信息,也包含请求的request的信息. 首先: response对象的属性有以下几个, r.stat ...
- 网络爬虫必备知识之urllib库
就库的范围,个人认为网络爬虫必备库知识包括urllib.requests.re.BeautifulSoup.concurrent.futures,接下来将结合爬虫示例分别对urllib库的使用方法进行 ...
- 网络爬虫必备知识之requests库
就库的范围,个人认为网络爬虫必备库知识包括urllib.requests.re.BeautifulSoup.concurrent.futures,接下来将结对requests库的使用方法进行总结 1. ...
- 网络爬虫必备知识之concurrent.futures库
就库的范围,个人认为网络爬虫必备库知识包括urllib.requests.re.BeautifulSoup.concurrent.futures,接下来将结对concurrent.futures库的使 ...
随机推荐
- html5中的indexDB
1.关系型数据库和非关系型数据库 一致性: 事务完成时,必须让所有的数据具有一致的状态,例如要写入100个数据,前99个成功了,结果第100个不合法,此时事务会回滚到最初状态.这样保证事务结束和开始时 ...
- 腾讯视频国际版(Android)电量测试方法研究与总结
本文由云+社区发表 作者:腾讯移动品质中心TMQ 1.研究背景: 在2017年Google I/O大会上,Google发布了Google Play管理中心的新功能:Android vitals.当ap ...
- DSAPI 生成桌面图标(带数字)
功能:在桌面上创建一个带有指定数字的图标. 效果图: 生成的ICO图标 代码 Private Sub 生成桌面图标(消息数量 As Integer) Try Dim B As New Bitmap(M ...
- 抽象工厂模式(Abstract Factory Pattern)
抽象工厂模式概述 定义:提供一个创建一系列相关或相互依赖对象的接口,而无需指定他们具体的类 抽象工厂抽象工厂,顾名思义,就是比工厂模式更抽象的工厂模式.在工厂模式中,一个具体工厂只负责生产一个具体产品 ...
- GeoServer中sld文件的获取来源
众所周知,uDig是GeoServer的一个客户端,可以方便地可视化配置样式. QGIS行不行呢? 当然可以,双击图层名称,弹出图层属性对话框 在符号化(style)标签页选择样式导出即可. 参考博客 ...
- 如何给自己的app添加分享到有道云笔记这样的功能
文章同步自http://javaexception.com/archives/34 如何给自己的app添加分享到有道云笔记这样的功能 问题: 在之前的一个开源笔记类项目Leanote中,有个用户反馈想 ...
- Android app去掉https签名校验
本文同步至http://javaexception.com/archives/30 问题: 之前的一个开源项目碰到了一个问题,Fix CertPathValidatorException: Trust ...
- 安卓开发笔记(十八):实现button按钮事件的三种方法
Android开发中有三种主要的方式用于设置View的点击事件,1.创建内部类:2.主类中实现OnClickListener接口:3.使用匿名内部类.这三种方式都用到了OnClickListener接 ...
- 粮草先行——Android折叠屏开发技术点番外篇之运行时变更处理原则
上一篇文章中,我们有提到Activity在屏幕尺寸发生变更时的处理方式,总共有两种: 重启APP以适应屏幕改变: 手动处理数据,避免APP重启. 同样,这两种方式也同时适用于改变屏幕方向.更改系统语言 ...
- 你可能需要为你的 APP 适配 iOS 11
本文来自于腾讯Bugly公众号(weixinBugly),未经作者同意,请勿转载,原文地址:https://mp.weixin.qq.com/s/AZFrqL9dnlgA6Vt2sVhxIw 作者:s ...