
[离线计算-Spark|Hive] 大数据应用性能指标采集工具改造落地
背景
主要介绍针对平台的spark应用程序,在不修改用户程序的情况下 如何采集其资源和性能指标为后续分析使用,如性能优化,资源使用计价等.
分析挑战
在应用程序级别关联大量进程的指标
在分布式环境中,多个 Spark 应用程序运行在同一台服务器上,每个 Spark 应用程序都有大量的进程(例如数千个执行程序)在许多服务器上运行.
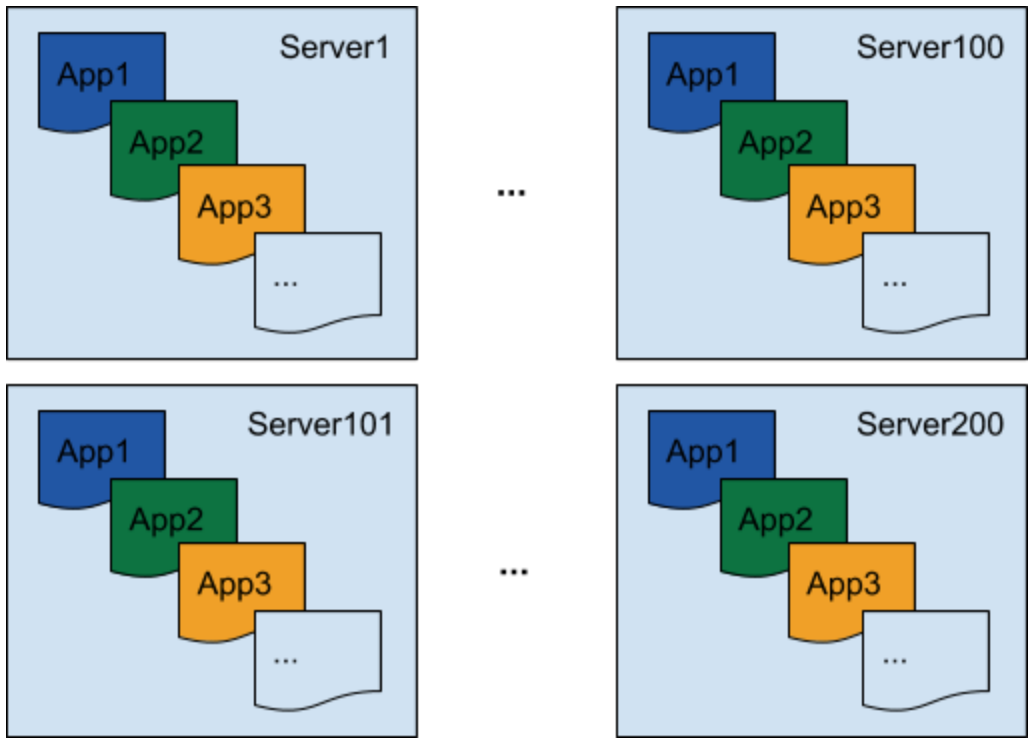
需要一个解决方案,该解决方案可以为每个进程收集指标,并将它们关联到每个应用程序的流程中
我们不知道这些流程何时启动以及需要多长时间。为了能够在这种环境中收集指标,分析器需要随每个进程自动启动。
使指标收集对任意用户代码无干扰
为了跟上数据基础设施的不断增长,我们需要能够随时测量任何应用程序,而无需更改代码。
例如,如果我们在 Hadoop 分布式文件系统 (HDFS) NameNode 上遇到高延迟,我们希望检查从每个 Spark 应用程序观察到的延迟,以确保这些问题没有被复制。由于 NameNode 客户端代码嵌入在我们的 Spark 库中,因此修改其源代码以添加此特定指标很麻烦。
JVM Profiler 引入
主要受 https://github.com/etsy/statsd-jvm-profiler 启发构建了更多功能的分析器
JVM Profiler 由三个关键功能组成,可以更轻松地收集性能和资源使用指标,然后将这些指标(例如 Apache Kafka)提供给其他系统进行进一步分析:
java agent: 通过将 Java agent 合并到我们的分析器中,用户可以以分布式方式收集 JVM 进程的各种指标(例如 CPU/内存使用情况)和堆栈跟踪
高级分析功能:JVM Profiler 允许我们跟踪用户代码中的任意 Java 方法和参数,而无需进行任何实际代码更改。此功能可用于跟踪 Spark 应用程序的 HDFS NameNode RPC 调用延迟并识别慢速方法调用。它还可以跟踪每个 Spark 应用程序读取或写入的 HDFS 文件路径,以识别热文件以进行进一步优化。
数据分析报告:在 Uber,我们使用分析器向 Kafka topic和 Apache Hive 表报告指标,使数据分析更快更容易。
JVM Profiler 使用场景
大小合适的 executor:使用 JVM Profiler 的内存指标来跟踪每个 executor 的实际内存使用情况,以便我们可以为 Spark“executor-memory”参数设置正确的值。
监控 HDFS NameNode RPC 延迟:我们分析Spark 应用程序中org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolTranslatorPB类上的方法,并识别 NameNode 调用的长时间延迟
监控驱动程序丢弃事件: 分析像org.apache.spark.scheduler.LiveListenerBus.onDropEvent这样的方法来跟踪 Spark 驱动程序事件队列变得太长并丢弃事件的情况。
跟踪数据:在org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolTranslatorPB.getBlockLocations和org.apache.hadoop.hdfs.protocolPB.ClientNamenodeProtocolTranslatorPB.addBlock方法上分析文件路径参数,以跟踪 Spark 读取和写入的文件应用
实现细节及可扩展性
为了使实现尽可能无缝,JVM Profiler 具有非常简单且可扩展的设计。人们可以轻松添加额外的分析器实现来收集更多指标,还可以部署自己的自定义报告器,将指标发送到不同的系统进行数据分析。
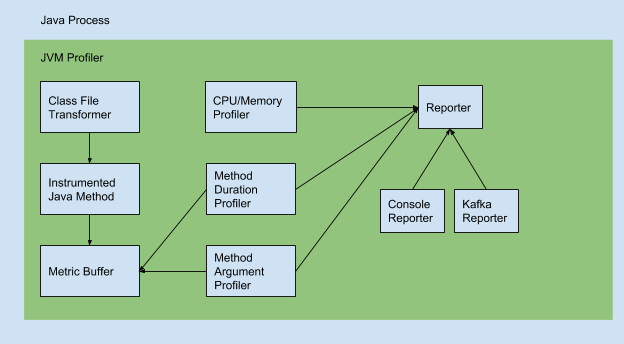
一旦进程启动,JVM Profiler 代码就会通过Java agent 参数加载到 Java 进程中。它由三个主要部分组成:
Class File Transformer:在进程内检测 Java 方法字节码以分析任意用户代码并将指标保存在内部指标缓冲区中。
Metric Profilers
- CPU/Memory Profiler:通过JMX收集 CPU/内存使用指标并将其发送给报告者。
- Method Duration Profiler:从指标缓冲区读取方法持续时间(延迟)指标并发送给报告者。
- Method Argument Profiler: 从指标缓冲区读取方法参数值并将其发送给报告者。
Reporters
- Console Reporter: 在控制台输出中写入指标
- Kafka Reporter :将指标发送到 Kafka topic中
如何自定义reporter发送指标
用户可以实现自己的报告器并使用 -javaagent 选项指定它:
-javaagent:jvm-profiler-0.0.5.jar= reporter=com.uber.profiling.reporters.CustomReporter
JVM Profiler 在Uber数据基础设施集成
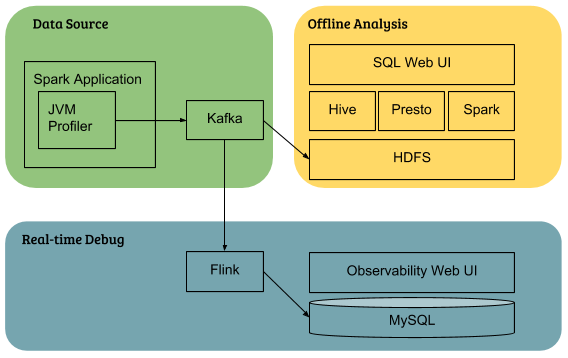
基础设施集成实现:
- 集群范围的数据分析:指标首先发送到 Kafka 并摄取到 HDFS,然后用户使用 Hive/Presto/Spark 进行查询。
- 实时 Spark 应用程序调试:使用 Flink 实时聚合单个应用程序的数据并写入MySQL 数据库,然后用户可以通过基于 Web 的界面查看指标。
如何落地的
扩展设计
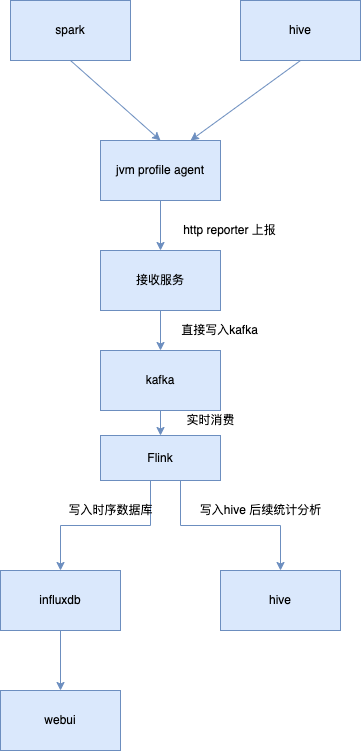
整体流程:
spark应用在启动的时候指定jvm-profiler jar, 运行时收集内存,cpu,gc.io等指标,定制实现的profile
使用自定的reproter,主要将指标通过http 发送到接收服务
接收服务负责将数据写入kafka
kafka经flink 消费清洗分别写入influxdb以及hive中,用于后续展示和分析
hive 一样执行时,指定相关参数
通过解析/.staging/下job.xml 获取queryId 及sql相关信息
后续流程一样
部署
spark: 上传jvm-profiler jar 包到 hdfs上,提交任务时参数指定
hive: 部署jar到 hiveserver2 节点对应libs下面
总结
本文主要介绍了下Uber的开源项目jvm-profiler的产生背景,设计原理以及架构, 后面也设计了一套落地方案,用于采集spark、hive任务的资源消耗相关指标,可用于后续分析以及资源调优.
参考
https://eng.uber.com/jvm-profiler/
https://github.com/uber-common/jvm-profiler
[离线计算-Spark|Hive] 大数据应用性能指标采集工具改造落地的更多相关文章
- 大数据实时处理-基于Spark的大数据实时处理及应用技术培训
随着互联网.移动互联网和物联网的发展,我们已经切实地迎来了一个大数据 的时代.大数据是指无法在一定时间内用常规软件工具对其内容进行抓取.管理和处理的数据集合,对大数据的分析已经成为一个非常重要且紧迫的 ...
- 给Clouderamanager集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
这个很简单,在集群机器里,选择就是了,本来自带就有Impala的. 扩展博客 给Ambari集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
- 给Ambari集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
不多说,直接上干货! Impala和Hive的关系(详解) 扩展博客 给Clouderamanager集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解) 参考 horton ...
- 大数据应用日志采集之Scribe演示实例完全解析
大数据应用日志采集之Scribe演示实例完全解析 引子: Scribe是Facebook开源的日志收集系统,在Facebook内部已经得到大量的应用.它能够从各种日志源上收集日志,存储到一个中央存储系 ...
- 大数据应用日志采集之Scribe 安装配置指南
大数据应用日志采集之Scribe 安装配置指南 大数据应用日志采集之Scribe 安装配置指南 1.概述 Scribe是Facebook开源的日志收集系统,在Facebook内部已经得到大量的应用.它 ...
- Java,面试题,简历,Linux,大数据,常用开发工具类,API文档,电子书,各种思维导图资源,百度网盘资源,BBS论坛系统 ERP管理系统 OA办公自动化管理系统 车辆管理系统 各种后台管理系统
Java,面试题,简历,Linux,大数据,常用开发工具类,API文档,电子书,各种思维导图资源,百度网盘资源BBS论坛系统 ERP管理系统 OA办公自动化管理系统 车辆管理系统 家庭理财系统 各种后 ...
- Spark记录-大数据简介
什么是大数据 大数据(big data),指无法在一定时间范围内用常规软件工具进行捕捉.管理和处理的数据集合,是需要新处理模式才能具有更强的决策力.洞察发现力和流程优化能力的海量.高增长率和多样化的信 ...
- Spark简介 --大数据
一.Spark是什么? 快速且通用的集群计算平台 二.Spark的特点: 快速:Spark扩充流行的Mapreduce计算模型,是基于内存的计算 通用:Spark的设计容纳了其它分布式系统拥有的功能, ...
- [转载] Spark:大数据的“电光石火”
转载自http://www.csdn.net/article/2013-07-08/2816149 Spark已正式申请加入Apache孵化器,从灵机一闪的实验室“电火花”成长为大数据技术平台中异军突 ...
- Spark:大数据的电花火石!
什么是Spark?可能你很多年前就使用过Spark,反正当年我四六级单词都是用的星火系列,没错,星火系列的洋名就是Spark. 当然这里说的Spark指的是Apache Spark,Apache Sp ...
随机推荐
- 15-canvas渐变色
1 <!DOCTYPE html> 2 <html lang="en"> 3 <head> 4 <meta charset="U ...
- 强!34.1K star! 再见Postman,新一代API测试利器,功能强大、颜值爆表!
1.引言 在当今的互联网时代,API(应用程序编程接口)已经成为连接不同软件系统的桥梁.作为一名开发者,掌握API测试技能至关重要.市面上的API测试工具琳琅满目,今天我们要介绍的是一款开源.跨平台的 ...
- centos上yum无法使用的问题以及无法用yum安装screen,iftop,nethogs等的解决办法
大家可能都发现了centos8已经不在更新了.当我们使用yum安装某些工具的时候,会提示安装源失败 解决方案:删除repo文件 然后重新下载即可修复yum安装报错问题1.进入/etc/yum.repo ...
- pyinstaller 打包 win32ctypes.pywin32.pywintypes.error: (225, '', '无法成功完成操作,因为文件包含病毒或潜在的垃圾软件。')
背景: 使用python 写了一个程序,使用pyinstaller打包, 不使用-w --noconsole的命令打包隐藏命令行窗口时,是正常的, 但是使用-w或者--noconsole就会报错win ...
- Html 使用scss爆红
使用 <style lang="less" scoped> </style> 即可
- MVCC能否解决幻读?
一.什么是MVCC 多版本控制: 指的是一种提高并发的技术.最早的数据库系统,只有读读之间可以并发,读写,写读,写写都要阻塞.引入多版本之后,只有写写之间相互阻塞,其他三种操作都可以并行,这样大幅度提 ...
- 17 Python异常处理(捕获异常、抛出异常、自定义异常)
本篇是 Python 系列教程第 17 篇,更多内容敬请访问我的 Python 合集 当我们编写代码时,可能会遇到各种各样的错误情况,比如除数为零.找不到文件.网络问题等等.为了优雅地处理这些问题,P ...
- canvas图片旋转扩展出原生JS实现移动端横竖屏手写签名示例
前提知识 canvas是提供了各种各样的接口去控制画布,比如旋转rotate方法. 这里的旋转并不是真的把这个画布旋转了,例如ctx.rotate(90 * Math.PI / 180)顺时针旋转90 ...
- docker启动问题: Job for docker.service failed because the control process exited with error code. See "systemctl status docker.service" and "journalctl -xe" for details.
系统环境:centos 7 docker版本:Docker version 26.1.4, build 5650f9b 问题:Job for docker.service failed because ...
- Angular 学习笔记 (Angular 12 get started)
Angular 12 视乎比以往更稳定了. 这里记入一般的 get started 结构和做法. 第 1 步, 创建项目. ng new project --create-application=fa ...