
scrapy微信爬虫使用总结
scrapy+selenium+Chrome+微信公众号爬虫
概述
1、微信公众号爬虫思路:
2、scrapy框架图
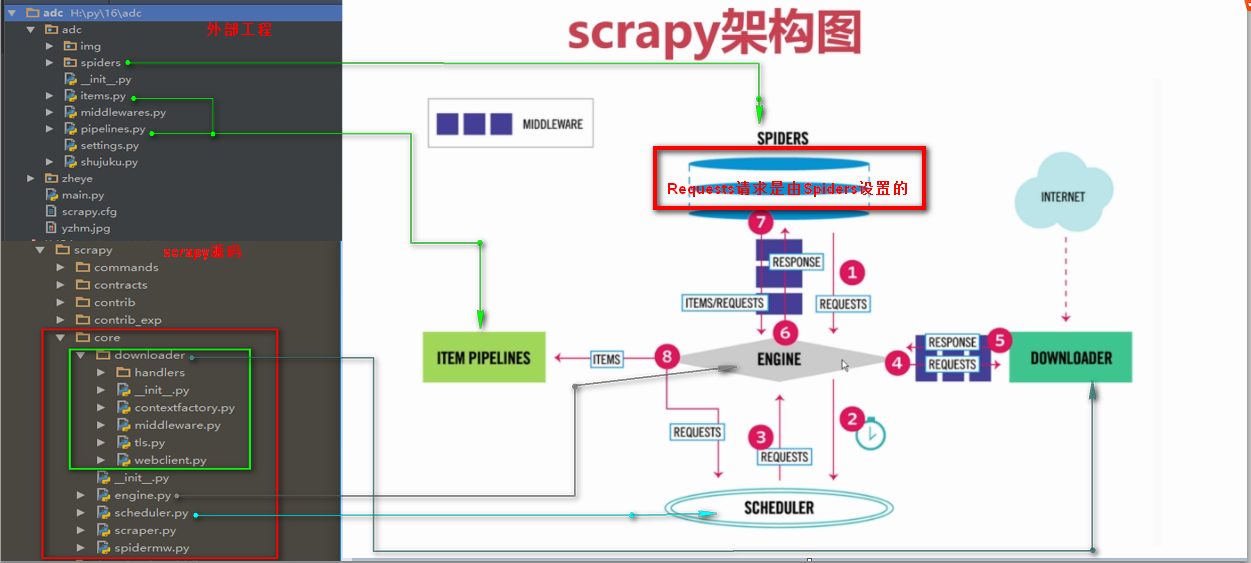
3、scrapy经典教程
参考:
4、其它
参考:
实践
1、环境的安装
- selenium安装(pip install selenium)
- chromedriver安装(注意与chrome版本兼容问题)
- beautifulsoup4
- scrapy
- MongoDB、pymongo
MongoDB:
具体命令如下:
python连接MongoDB,需安装pip install mongoengine
启动:
sudo ./mongod --port 27017 dbpath "/software/mongodb-4.0.0/data/db" --logpath "/software/mongodb-4.0.0/log/mongodb.log" --logappend --replSet rs0
Windows下MongoDB数据导出:
mongodump --port 27017 -d wechat -o D:\MongoDB
Linux下MongoDB数据导入:
./mongorestore -h 127.0.0.1 --port 27017 -d wechat --drop /software/mongodb-4.0.0/wechat
数据导入时注意:
Do you run mongo in replica set, i.e., mongod --replSet rs0?
If yes, please remember to run in your mongo shell the command: rs.initiate()
参考:
2、cookie获取
selenium进行登录验证,保存cookies,为scrapy做准备。
3、爬虫
- cookies:scrapy spider初始化函数调用Chromedriver,并获取cookies
- 定位:spider初始化函数利用Chromedriver定位到需要抓取的页面
- 解析:parse函数处理Chromedriver自动定scrapy爬虫利用selenium实现用户登录和cookie传递位的页面信息,以及下一页URL
- 保存:scrapy配置MongoDB保存数据
参考:
scrapy爬虫利用selenium实现用户登录和cookie传递
4、django调用爬虫
5、django构建搜索引擎,搜索爬过的信息
参考:
环境配置:
elasticsearch-rtf安装、pip install mongo-connector、pip install mongo-connector[elastic5]、pip install elastic2-doc-manager
MongoDB数据同步到elasticsearch:
mongo-connector -m localhost:27017 -t localhost:9200 -d elastic2_doc_manager
其它问题
1、selenium在新页面定位元素问题
参考:
解决Selenium弹出新页面无法定位元素问题(Unable to locate element)
3、在管道中关闭爬虫
spider.crawler.engine.close_spider(spider, 'bandwidth_exceeded')
scrapy微信爬虫使用总结的更多相关文章
- 爬虫学习之基于Scrapy的爬虫自动登录
###概述 在前面两篇(爬虫学习之基于Scrapy的网络爬虫和爬虫学习之简单的网络爬虫)文章中我们通过两个实际的案例,采用不同的方式进行了内容提取.我们对网络爬虫有了一个比较初级的认识,只要发起请求获 ...
- scrapy爬虫学习系列二:scrapy简单爬虫样例学习
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- Scrapy框架-----爬虫
说明:文章是本人读了崔庆才的Python3---网络爬虫开发实战,做的简单整理,希望能帮助正在学习的小伙伴~~ 1. 准备工作: 安装Scrapy框架.MongoDB和PyMongo库,如果没有安装, ...
- Scrapy创建爬虫项目
1.打开cmd命令行工具,输入scrapy startproject 项目名称 2.使用pycharm打开项目,查看项目目录 3.创建爬虫,打开CMD,cd命令进入到爬虫项目文件夹,输入scrapy ...
- Scrapy - CrawlSpider爬虫
crawlSpider 爬虫 思路: 从response中提取满足某个条件的url地址,发送给引擎,同时能够指定callback函数. 1. 创建项目 scrapy startproject mysp ...
- 【Python爬虫实战】微信爬虫
所谓微信爬虫,即自动获取微信的相关文章信息的一种爬虫.微信对我们的限制是很多的,所以我们需要采取一些手段解决这些限制主要包括伪装浏览器.使用代理IP等方式http://weixin.sogou.com ...
- 第三百五十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy分布式爬虫要点
第三百五十六节,Python分布式爬虫打造搜索引擎Scrapy精讲—scrapy分布式爬虫要点 1.分布式爬虫原理 2.分布式爬虫优点 3.分布式爬虫需要解决的问题
- 第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码
第三百三十五节,web爬虫讲解2—Scrapy框架爬虫—豆瓣登录与利用打码接口实现自动识别验证码 打码接口文件 # -*- coding: cp936 -*- import sys import os ...
- 第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息 crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多 ...
随机推荐
- Linux基础命令---gunzip
gunzip 解压缩被gzip压缩过的文件.此命令的适用范围:RedHat.RHEL.Ubuntu.CentOS.SUSE.openSUSE.Fedora. 1.语法 gunzip [-ac ...
- python构造栈结构
栈:是一种先进后出的数据结构:本片文章,我们用python的面向对象来构造这样的数据结构. 栈中的每一个数据除了存储当前的数值外,还存储着当前数值下一个数据的类型(注意不是下一个数据的数值). cla ...
- Python Web学习笔记之Python多线程和多进程、协程入门
进程和线程究竟是什么?如何使用进程和线程?什么场景下需要使用进程和线程?协程又是什么?协程和线程的关系和区别有哪些? 程序切换-CPU时间的分配 首先,我们的任何一个程序都需要运行在一个操作系统中,如 ...
- linux系统启动顺序及init模式
磁盘的第一个扇区(512bytes)主要记录了两个重要信息: 主引导分区MBR:master boot record,安装引导加载程序的地方,446bytes 分区表:partition table: ...
- bzoj1652 / P2858 [USACO06FEB]奶牛零食Treats for the Cows
P2858 [USACO06FEB]奶牛零食Treats for the Cows 区间dp 设$f[l][r]$为取区间$[l,r]$的最优解,蓝后倒着推 $f[l][r]=max(f[l+1][r ...
- WebService(JAX-WS、XFire、Axis三种)获取客户端ip
WebService(JAX-WS.XFire.Axis三种)获取客户端ip JAX-WS.XFire.Axis三种webservice的获取客户端IP的简单实现过程: 1,基于JDK6 jax-ws ...
- mariadb 10.1查看per connection内存消耗
在mariadb 10.1版本中,在information_schema.processlist表中,新增了几个字段,其中有一个memory_used,其记录的是连接的内存消耗. 同时新增了一个状态变 ...
- assert函数用法总结【转】
本文转载自:http://blog.csdn.net/u014082714/article/details/45190505 assert宏的原型定义在<assert.h>中,其作用是如果 ...
- 在ubuntu bionic下对基于qemu的arm64进行linux内核5.0.1版本的编译和运行
一.环境介绍 OS:ubuntu bionic 64bit 二.准备工作 2.1 安装必要的开发工具 sudo apt-get install git flex bison build-essenti ...
- Mysql相关问题收集
1.查询每个班级的前三名 DROP TABLE IF EXISTS `sc`; CREATE TABLE `sc` ( `id` ) NOT NULL AUTO_INCREMENT, `name` v ...