
Scrapy - CrawlSpider爬虫
crawlSpider 爬虫
思路:
从response中提取满足某个条件的url地址,发送给引擎,同时能够指定callback函数。
1. 创建项目
scrapy startproject myspiderproject
2. 创建crawlSpider 爬虫
scrapy genspider -t crawl 爬虫名 爬取网站域名
3. 启动爬虫
scrapy crawl  爬虫名     # 会打印日志

scrapy crawl  爬虫名   --nolog
crawlSpider 的参数解析:
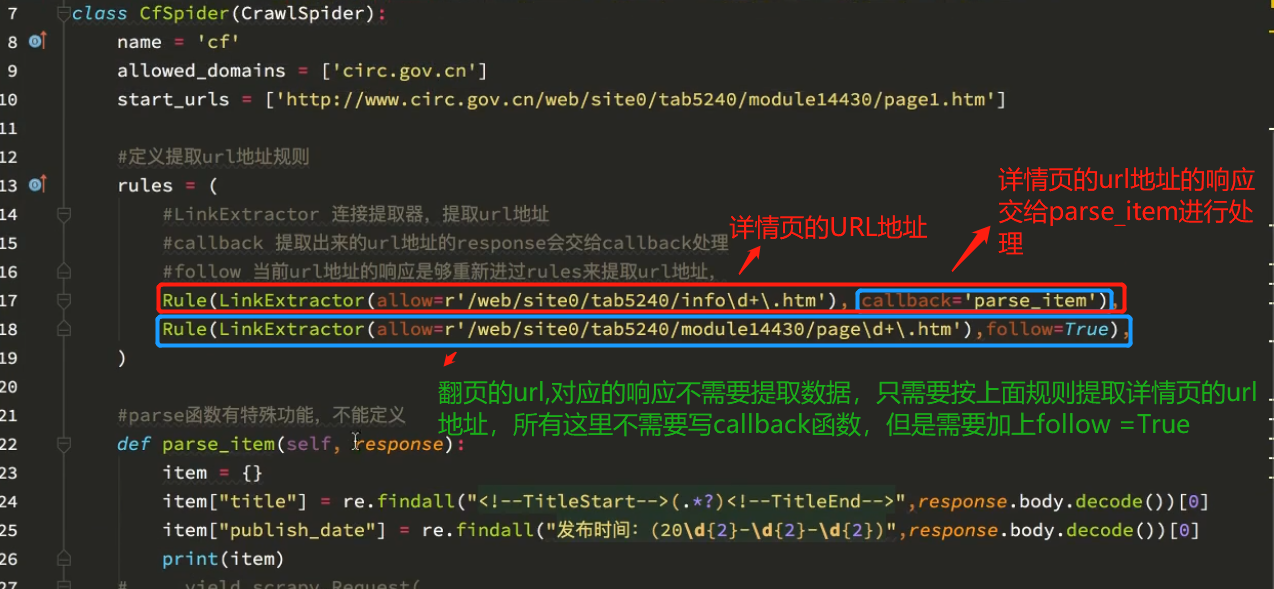
案例
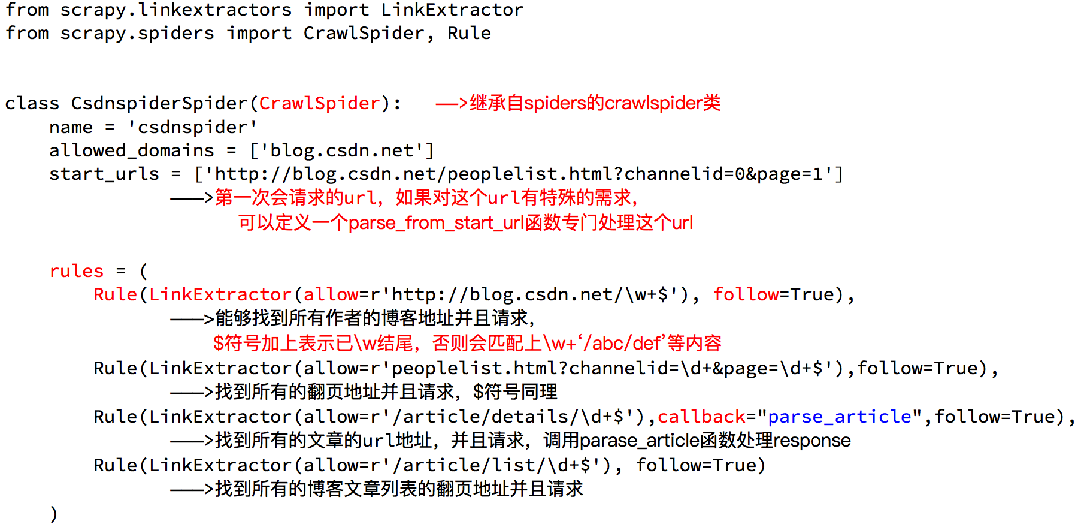
需求:爬取csdn上面所有的博客专家及其文章的文章 Url地址:http://blog.csdn.net/experts.html 。
分析:
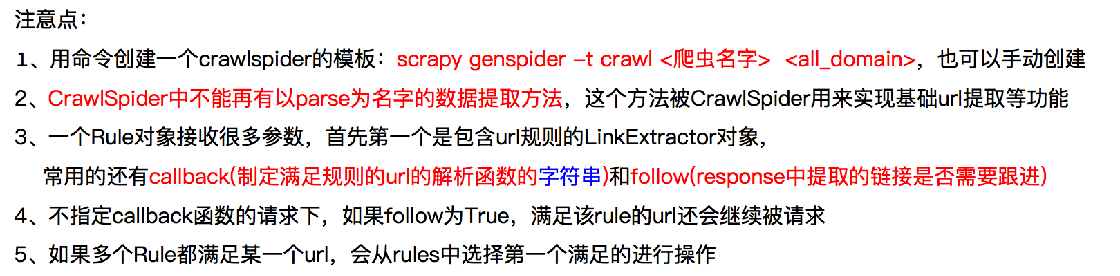
使用crawlSpider 的注意点:
补充知识点:

Scrapy - CrawlSpider爬虫的更多相关文章
- scrapy 中crawlspider 爬虫
爬取目标网站: http://www.chinanews.com/rss/rss_2.html 获取url后进入另一个页面进行数据提取 检查网页: 爬虫该页数据的逻辑: Crawlspider爬虫类: ...
- scrapy进阶(CrawlSpider爬虫__爬取整站小说)
# -*- coding: utf-8 -*- import scrapy,re from scrapy.linkextractors import LinkExtractor from scrapy ...
- scrapy -->CrawlSpider 介绍
scrapy -->CrawlSpider 介绍 1.首先,通过crawl 模板新建爬虫: scrapy genspider -t crawl lagou www.lagou.com 创建出来的 ...
- crawlspider爬虫:定义url规则
spider爬虫,适合meta传参的爬虫(列表页,详情页都有数据要爬取的时候) crawlspider爬虫,适合不用meta传参的爬虫 scrapy genspider -t crawl it it. ...
- 创建CrawlSpider爬虫简要步骤
创建CrawlSpider爬虫简要步骤: 1. 创建项目文件: e.g: scrapy startproject douyu (douyu为项目名自定义) 2. 进入项目文件: e.g: cd dou ...
- 爬虫(十八):Scrapy框架(五) Scrapy通用爬虫
1. Scrapy通用爬虫 通过Scrapy,我们可以轻松地完成一个站点爬虫的编写.但如果抓取的站点量非常大,比如爬取各大媒体的新闻信息,多个Spider则可能包含很多重复代码. 如果我们将各个站点的 ...
- 爬虫学习之基于Scrapy的爬虫自动登录
###概述 在前面两篇(爬虫学习之基于Scrapy的网络爬虫和爬虫学习之简单的网络爬虫)文章中我们通过两个实际的案例,采用不同的方式进行了内容提取.我们对网络爬虫有了一个比较初级的认识,只要发起请求获 ...
- scrapy爬虫学习系列二:scrapy简单爬虫样例学习
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- Scrapy框架-----爬虫
说明:文章是本人读了崔庆才的Python3---网络爬虫开发实战,做的简单整理,希望能帮助正在学习的小伙伴~~ 1. 准备工作: 安装Scrapy框架.MongoDB和PyMongo库,如果没有安装, ...
随机推荐
- Ubuntu18.04 安装搜狗输入法后无法启动的问题
ibus 改选成fcitx后搜狗输入法照样没出来. 这里需要im-config 没有的话需要安装: sudo apt install im-config 然后在Terminal中执行 im-confi ...
- 使用msi自动安装系统
在实际生活中, 还是要尽量使用 自动化 脚本 等来处理/执行问题, 那样更快更省力省时间 要多使用 网络工具, 网络工具在 管理/ 使用网络的过程 中还是很有用的. 要有这种 "多使用网络工 ...
- .net Core 依赖注入 Add********说明
AddTransient瞬时模式:每次请求,都获取一个新的实例.即使同一个请求获取多次也会是不同的实例 AddScoped:每次请求,都获取一个新的实例.同一个请求获取多次会得到相同的实例 AddSi ...
- vue中使用BetterScroll
BetterScroll可以通过给content加min-height实现永远滚动 content千万不可以删除,千万不要在 content上写v-if
- Spring Cloud各组件超时总结
Ribbon的超时 全局设置: ribbon: ReadTimeout: 60000 ConnectTimeout: 60000 1 2 3 局部设置: service-id: ribbon: Rea ...
- CAS 单点登录 移动端获取TGT、ST 已经移动端登录页面不进行跳转的设置
一.设置移动客户端验证ST通过后,页面不进行302重定向跳转 修改web.xml <!--**************************************************** ...
- 【译】第45节---EF6-索引属性
原文:http://www.entityframeworktutorial.net/entityframework6/index-attribute-in-code-first.aspx Entity ...
- 51nod 1689 逛街(优先队列)
http://www.51nod.com/onlineJudge/questionCode.html#!problemId=1689 题意: 题意: 枚举终点,这样就确定路上的花费,接下来只需要计算进 ...
- linux golang
wget -c http://www.golangtc.com/static/go/go1.3.linux-386.tar.gz #下载32位Linux的够源码包 tar -zxvf go1.1.li ...
- React native中的组建通知通信:
有这么一个需求,在B页面pop()回到A页面,需要A页面执行刷新,那么我们可以采用以下方法: 1:在A页面Push到B页面中,加上一个A页面中的刷新函数做为参数,然后在B页面中在pop()函数封装后通 ...