
Hadoop SequenceFile数据结构介绍及读写
在一些应用中,我们需要一种特殊的数据结构来存储数据,并进行读取,这里就分析下为什么用SequenceFile格式文件。
Hadoop SequenceFile
Hadoop提供的SequenceFile文件格式提供一对key,value形式的不可变的数据结构。同时,HDFS和MapReduce job使用SequenceFile文件可以使文件的读取更加效率。
SequenceFile的格式
SequenceFile的格式是由一个header 跟随一个或多个记录组成。前三个字节是一个Bytes SEQ代表着版本号,同时header也包括key的名称,value class , 压缩细节,metadata,以及Sync markers。Sync markers的作用在于可以读取任意位置的数据。
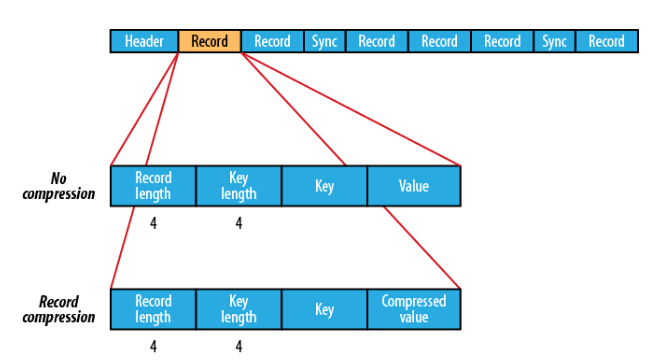
在recourds中,又分为是否压缩格式。当没有被压缩时,key与value使用Serialization序列化写入SequenceFile。当选择压缩格式时,record的压缩格式与没有压缩其实不尽相同,除了value的bytes被压缩,key是不被压缩的。
在Block中,它使所有的信息进行压缩,压缩的最小大小由配置文件中,io.seqfile.compress.blocksize配置项决定。
SequenceFile的MapFile
一个MapFile可以通过SequenceFile的地址,进行分类查找的格式。使用这个格式的优点在于,首先会将SequenceFile中的地址都加载入内存,并且进行了key值排序,从而提供更快的数据查找。
写SequenceFile文件:
将key按100-1以IntWritable object进行倒叙写入sequence file,value为Text objects格式。在将key和value写入Sequence File前,首先将每行所在的位置写入(writer.getLength())
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IOUtils;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.SequenceFile;
import org.apache.hadoop.io.Text;
import java.io.IOException;
import java.net.URI;
public class SequenceFileWriteDemo {

  private static final String[] DATA = {

    "One, two, buckle my shoe",

    "Three, four, shut the door",

    "Five, six, pick up sticks",

    "Seven, eight, lay them straight",

    "Nine, ten, a big fat hen"

  };

  public static void main(String[] args) throws IOException {

    String uri = args[0];

    Configuration conf = new Configuration();

    FileSystem fs = FileSystem.get(URI.create(uri), conf);

    Path path = new Path(uri);

    IntWritable key = new IntWritable();

    Text value = new Text();

    SequenceFile.Writer writer = null;

    try {

      writer = SequenceFile.createWriter(fs, conf, path,

          key.getClass(), value.getClass());

      for (int i = 0; i < 100; i++) {

        key.set(100 - i);

        value.set(DATA[i % DATA.length]);

        System.out.printf("[%s]\t%s\t%s\n", writer.getLength(), key, value);

        writer.append(key, value);

      }

    } finally {

      IOUtils.closeStream(writer);

    }

  }

}
读取SequenceFile文件:
首先需要创建SequenceFile.Reader实例,随后通过调用next()函数进行每行结果集的迭代(需要依赖序列化).
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.FileSystem;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IOUtils;
import org.apache.hadoop.io.SequenceFile;
import org.apache.hadoop.io.Writable;
import org.apache.hadoop.util.ReflectionUtils;
import java.io.IOException;
import java.net.URI;
public class SequenceFileReadDemo {

  public static void main(String[] args) throws IOException {

    String uri = args[0];

    Configuration conf = new Configuration();

    FileSystem fs = FileSystem.get(URI.create(uri), conf);

    Path path = new Path(uri);

    SequenceFile.Reader reader = null;

    try {

      reader = new SequenceFile.Reader(fs, path, conf);

      Writable key = (Writable)

        ReflectionUtils.newInstance(reader.getKeyClass(), conf);

      Writable value = (Writable)

        ReflectionUtils.newInstance(reader.getValueClass(), conf);

      long position = reader.getPosition();

      while (reader.next(key, value)) {
     //同步记录的边界

        String syncSeen = reader.syncSeen() ? "*" : "";

        System.out.printf("[%s%s]\t%s\t%s\n", position, syncSeen, key, value);

        position = reader.getPosition(); // beginning of next record

      }

    } finally {

      IOUtils.closeStream(reader);

    }

  }

}


参考文献: 《Hadoop:The Definitive Guide, 4th Edition》
Hadoop SequenceFile数据结构介绍及读写的更多相关文章
- Java基础-JAVA中常见的数据结构介绍
Java基础-JAVA中常见的数据结构介绍 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.什么是数据结构 答:数据结构是指数据存储的组织方式.大致上分为线性表.栈(Stack) ...
- Python pandas 0.19.1 Intro to Data Structures 数据结构介绍 文档翻译
官方文档链接http://pandas.pydata.org/pandas-docs/stable/dsintro.html 数据结构介绍 我们将以一个快速的.非全面的pandas的基础数据结构概述来 ...
- BCM芯片FP原理及相关SDK数据结构介绍
BCM芯片有几个大的模块: VLAN.L2.L3和FP等几个,其中FP的使用也最为灵活,能解析匹配数据包文的前128字节比特级的内容,动作包括转发.丢弃.结合qos修改相应字段.分配vid.流镜像.流 ...
- redis学习(二) redis数据结构介绍以及常用命令
redis数据结构介绍 我们已经知道redis是一个基于key-value数据存储的数据结构数据库,这里的key指的是string类型,而对应的value则可以是多样的数据结构.其中包括下面五种类型: ...
- Hadoop生态圈-hbase介绍-完全分布式搭建
Hadoop生态圈-hbase介绍-完全分布式搭建 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任.
- Hadoop生态圈-hbase介绍-伪分布式安装
Hadoop生态圈-hbase介绍-伪分布式安装 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HBase简介 HBase是一个分布式的,持久的,强一致性的存储系统,具有近似最 ...
- 大数据之路week06--day07(Hadoop生态圈的介绍)
Hadoop 基本概念 一.Hadoop出现的前提环境 随着数据量的增大带来了以下的问题 (1)如何存储大量的数据? (2)怎么处理这些数据? (3)怎样的高效的分析这些数据? (4)在数据增长的情况 ...
- 读书笔记一、pandas数据结构介绍
pandas数据结构介绍 主要两种数据结构:Series和DataFrame. Series Series是一种类似于一维数组的对象,由一组数据(各种NumPy数据类型)+数据标签(即索引)组 ...
- Hadoop以及组件介绍
一.背景介绍 在接触过大数据相关项目的时候常常都会听到Hadoop这个东西,简单来说,他是一个用分布式计算来处理大数据的开源软件,下面包含了许多的组件和子项目,这篇文章将会介绍Hadoop的原理以及一 ...
随机推荐
- warning MSB3391
1.用C#生成dll文件 提示 (warning MSB3391)"未包含任何可为 COM 互操作注销的类型"和 ( warning MSB3214)"不包含任何可为 C ...
- Java 并发和多线程(二) 多线程的优点 [转]
原文:http://tutorials.jenkov.com/java-concurrency/benefits.html 作者:Jakob Jenkov 翻译:古圣昌 ...
- Liquid基础语法
Output输出 简单输出示例: Hello {{name}} Hello {{user.name}} Hello {{ 'tobi' }} Advanced output: Filters 高级输出 ...
- 《算法竞赛入门经典》5.41数学基础-Cantor的数表
如下数列,第一项是1/1,第二项是1/2,第三项是2/1,第四项是3/1,第五项是2/2,…….输入n,输出第n项.1/1 1/2 1/3 1/4 1/52/1 2/2 2/3 ...
- 一个 11 行 Python 代码实现的神经网络
一个 11 行 Python 代码实现的神经网络 2015/12/02 · 实践项目 · 15 评论· 神经网络 分享到:18 本文由 伯乐在线 - 耶鲁怕冷 翻译,Namco 校稿.未经许可,禁止转 ...
- OC之0801
1,字符串 字符串的创建:两种常用初始化方式 NSString *str=[[NSString alloc]initWithFormat:@"i am a boy"]; NSStr ...
- response下载文件 (转载)
核心代码: ? DataSet ds = dBll.GetList("ID=" + ID); ? string docName = "a.doc";//文件名, ...
- vs2012 vs2010 opencv2.4.7配置
http://blog.csdn.net/xiaohanstu/article/details/45309149?utm_source=tuicool <pre name=.7配置 .配置 () ...
- RabbitMQ/JAVA 客户端连接测试
这里是一个简单的helloworld测试. 这里在eclipse平台中实现 细节不再赘述.重点是导入rabbitmq-java-client的jar包 下载地址:http://www.rabbitmq ...
- 球形环境映射之angular方式的两种形式
图形学中,某些物体带有反射属性,会反射周围的环境.一种做法是沿着反射方向发一条光线,与场景求交,获取到交点的颜色值,作为反射的颜色.显然这种方法比较低效,更高效的方法是将被渲染物体所处的环境保存到一张 ...