
整个ssd的网络和multibox_loss_layer
总结说来prior_box层只完成了一个提取anchor的过程,其他与gt的match,筛选正负样本比例都是在multibox_loss_layer完成的
http://www.360doc.com/content/17/0810/10/10408243_678091430.shtml
1.以mobileNet-ssd为例子:https://github.com/chuanqi305/MobileNet-SSD/blob/master/train.prototxt
ssd在6个层上进行了预测,从6个feature map分别做了confidence和location预测,这些预测都是从相应层的feature map做一个1*1卷积,w和h是不变的,但channel会做改变,confidence:prior_num*class_num, location:prior_num*4
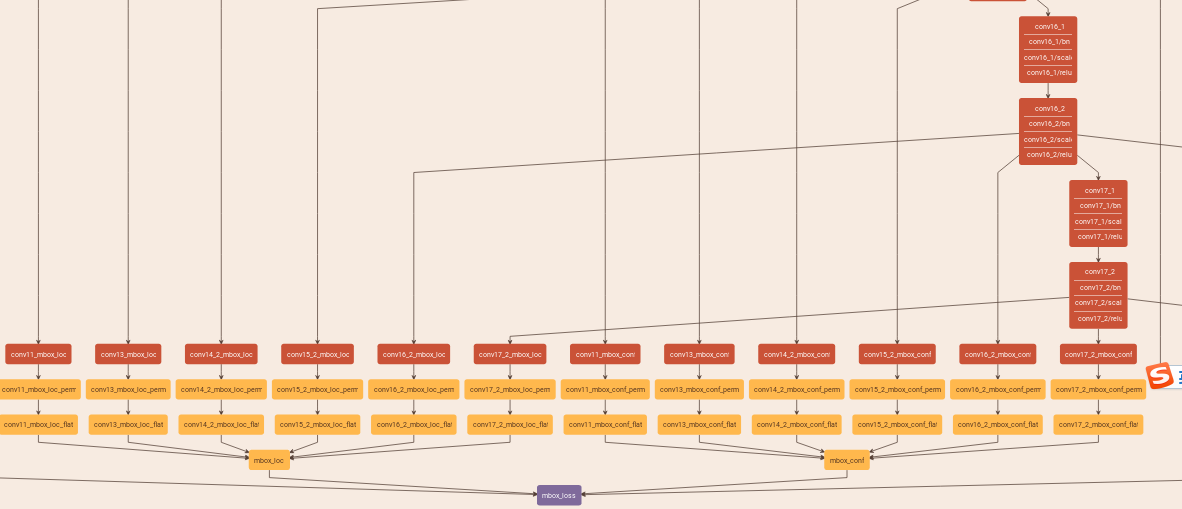
卷积都会经过一个permute层把原来的blob从nchw的顺序变成n,h,w,c,然后在flatten变成n,h*w*c,最后再通过concat把6个预测连接起来,最后就变成了一个一维的blob,比如mbox_conf前4个值代表的是4个prior为第0类的概率,shape的变化可以看下图:
为什么是conv4_3的channel是84,16;fc7的channel是126,24?
84 = 4*21,16 = 4*4
126 = 6*21,24 = 6*4
conv4_3的anchor是4个,fc7的anchor是6个,分类的channel是anchor数*分类数,bouding box的channel是anchor数*4个坐标

https://www.zhihu.com/question/269160464/answer/400342428,这个解释了为什么要进行permute,如果不进行permute直接进行flatten会让prior的值不在连续的存储空间
可以这样理解,flatten从axis=1开始摊开,先摊开的是第四维,摊完之后再是第三维,再是第二维.所以把84所代表的prior换到第四维,就先摊开类别和anchor个数
其实最终这个一维的blob都会对应某一个feature map中的某一个点的某一个anchor
2.https://blog.csdn.net/qianqing13579/article/details/80146425:
* Forward_cpu的主要流程: FindMatches:确定哪些priorbox是正样本,哪些是负样本,存放在all_match_indices_中
MineHardExamples:Minig出符合条件的负样本 计算正样本的定位
loss 计算所有正样本+Mining出来的负样本的分类loss
最后的loss为定位和分类loss的加权和
先GetGroundTruth、GetPriorBBoxes、GetLocPredictions分别得到gt,prior_box和预测的bounding box regression的值,然后FindMatches将prior的坐标和boudingbox坐标相加变成真正的预测框再和gt进行一个匹配.值得注意的是先是从groudtruth box出发给每个groudtruth box找到了最匹配的prior box放入候选正样本集,然后再从prior box出发为prior box集中寻找与groundtruth box满足IOU>0.5的一个IOU最大的prior box(如果有的话)放入候选正样本集,这样显然就增大了候选正样本集的数量.https://www.cnblogs.com/xuanyuyt/p/7447111.html
https://www.cnblogs.com/lillylin/p/6207292.html 然后MineHardExamples根据confidence loss排序,选取loss最大的前面一些并保证正负比1:3进行训练
https://www.sohu.com/a/168738025_717210,这个网页的ssd网络图比较完整,并且是以vgg为backbone,从conv6_1开始是ssd在vgg上添加的网络层,ssd是在6个层进行了预测

其他层都是直接从feature map上直接使用3*3,pad=1,stride=1的卷积生成分类和回归,但conv4_3的分类和回归是先norm了再用的卷积
整个ssd的网络和multibox_loss_layer的更多相关文章
- SSD训练网络参数计算
一个预测层的网络结构如下所示: 可以看到,是由三个分支组成的,分别是"PriorBox"层,以及conf.loc的预测层,其中,conf与loc的预测层的参数是由PriorBox的 ...
- SSD源码解读——网络搭建
之前,对SSD的论文进行了解读,可以回顾之前的博客:https://www.cnblogs.com/dengshunge/p/11665929.html. 为了加深对SSD的理解,因此对SSD的源码进 ...
- 『TensorFlow』SSD源码学习_其六:标签整理
Fork版本项目地址:SSD 一.输入标签生成 在数据预处理之后,图片.类别.真实框格式较为原始,不能够直接作为损失函数的输入标签(ssd向前网络只需要图像就行,这里的处理主要需要满足loss的计算) ...
- [目标检测]SSD原理
1 SSD基础原理 1.1 SSD网络结构 SSD使用VGG-16-Atrous作为基础网络,其中黄色部分为在VGG-16基础网络上填加的特征提取层.SSD与yolo不同之处是除了在最终特征图上做目标 ...
- 转:SSD详解
原文:http://blog.csdn.net/a8039974/article/details/77592395, http://blog.csdn.net/jesse_mx/article/det ...
- 【目标检测】SSD:
slides 讲得是相当清楚了: http://www.cs.unc.edu/~wliu/papers/ssd_eccv2016_slide.pdf 配合中文翻译来看: https://www.cnb ...
- SSD源码解读——网络测试
之前,对SSD的论文进行了解读,可以回顾之前的博客:https://www.cnblogs.com/dengshunge/p/11665929.html. 为了加深对SSD的理解,因此对SSD的源码进 ...
- SSD算法的实现
本文目的:介绍一个超赞的项目--用Keras来实现SSD算法. 本文目录: 0 前言 1 如何训练SSD模型 2 如何评估SSD模型 3 如何微调SSD模型 4 其他注意点 0 前言 我在学习完SSD ...
- 目标检测算法的总结(R-CNN、Fast R-CNN、Faster R-CNN、YOLO、SSD、FNP、ALEXnet、RetianNet、VGG Net-16)
目标检测解决的是计算机视觉任务的基本问题:即What objects are where?图像中有什么目标,在哪里?这意味着,我们不仅要用算法判断图片中是不是要检测的目标, 还要在图片中标记出它的位置 ...
随机推荐
- Oracle 角色及其权限
一.简介 Oracle权限分为系统权限和对象权限. 1.系统权限 注意:系统权限不支持级联回收,所以你需要使用sysdba一个个的回收. 2.对象权限 注:对象权限支持级联回收,系统权限不支持级联回收 ...
- spark on yarn模式里需要有时手工释放linux内存
为什么要提出这个问题? spark跑YARN模式或Client模式提交任务不成功(application state: ACCEPTED) 然后执行 [spark@master spark--bin- ...
- SVM之Python实现
SVM Python实现 Python实现SVM的理论知识 SVM原始最优化问题: \[ min_{w,b,\xi}{1\over{2}}{||w||}^2 + C\sum_{i=1}^m\xi^{( ...
- FZU 2213——Common Tangents——————【两个圆的切线个数】
Problem 2213 Common Tangents Accept: 7 Submit: 8Time Limit: 1000 mSec Memory Limit : 32768 KB ...
- WPF的依赖项属性
WPF的依赖项属性 属性与事件是.NET抽象模型的核心部分.WPF使用了更高级的依赖项属性(Dependency Property)功能来替换原来.NET的属性,实现了更高效率的保存机制,还添加了附加 ...
- 将代码托管到github,并生成链接访问
转眼间加入github的阵营已经两年多了,看到别人建立的个人博客挺好看的,因此,自己从此喜欢上了github,总结下自己的相关知识. 推荐学习Git的网址: 猴子都能懂的GIT入门 http://ba ...
- intellij idea里神坑的@autowire
当你写完项目的时侯serviceimpl层下的@autowire->对应的是dao层的注入,其下面会出现一条红线 在Intellij Idea开发工具在@Autowired或者@Resource ...
- Maven学习篇一:eclipse构建运行maven web项目
1.new->other->maven project->next 2.选择创建简单项目(或者直接去掉勾,在后面选择maven-archetype-webapp) 3.设置坐标,名称 ...
- mysql三:表操作
一.存储引擎介绍 存储引擎即表类型,mysql根据不同的表类型会有不同的处理机制. 详见:点击查看 二.表的介绍 表相当于文件,表中的一条记录就相当于文件的一行内容,不同的是,表中的一条记录有对应的标 ...
- stark——分页、search、actions
一.分页 1.引入自定义分页组件 在/stark目录下创建utils工具包目录,复制page.py到该目录下,文件中有之前自定义的分页组件. class Pagination(object): def ...