
关于java爬虫以及一些实例
首先是工具介绍
Jsoup
jsoup 是一款Java 的HTML解析器,可直接解析某个URL地址、HTML文本内容。它提供了一套非常省力的API,可通过DOM,CSS以及类似于jQuery的操作方法来取出和操作数据。
HttpClient
HTTP 协议可能是现在 Internet 上使用得最多、最重要的协议了,越来越多的 Java 应用程序需要直接通过 HTTP 协议来访问网络资源。虽然在 JDK 的 java net包中已经提供了访问 HTTP 协议的基本功能,但是对于大部分应用程序来说,JDK 库本身提供的功能还不够丰富和灵活。HttpClient 是 Apache Jakarta Common 下的子项目,用来提供高效的、最新的、功能丰富的支持 HTTP 协议的客户端编程工具包,并且它支持 HTTP 协议最新的版本和建议。
可能看的有点迷,直接上例子就好了
首先我们要确定一个要爬取的网站拿一个都快被爬破的经典教材起点中文网的完美世界吧
https://www.qidian.com/search?kw=%E5%AE%8C%E7%BE%8E%E4%B8%96%E7%95%8C
然后我们要对这个网页的结构进行分析,按F12
找到书的名字和作者名字的具体在哪个div里面,或者可以直接根据class名字找到要爬取的内容
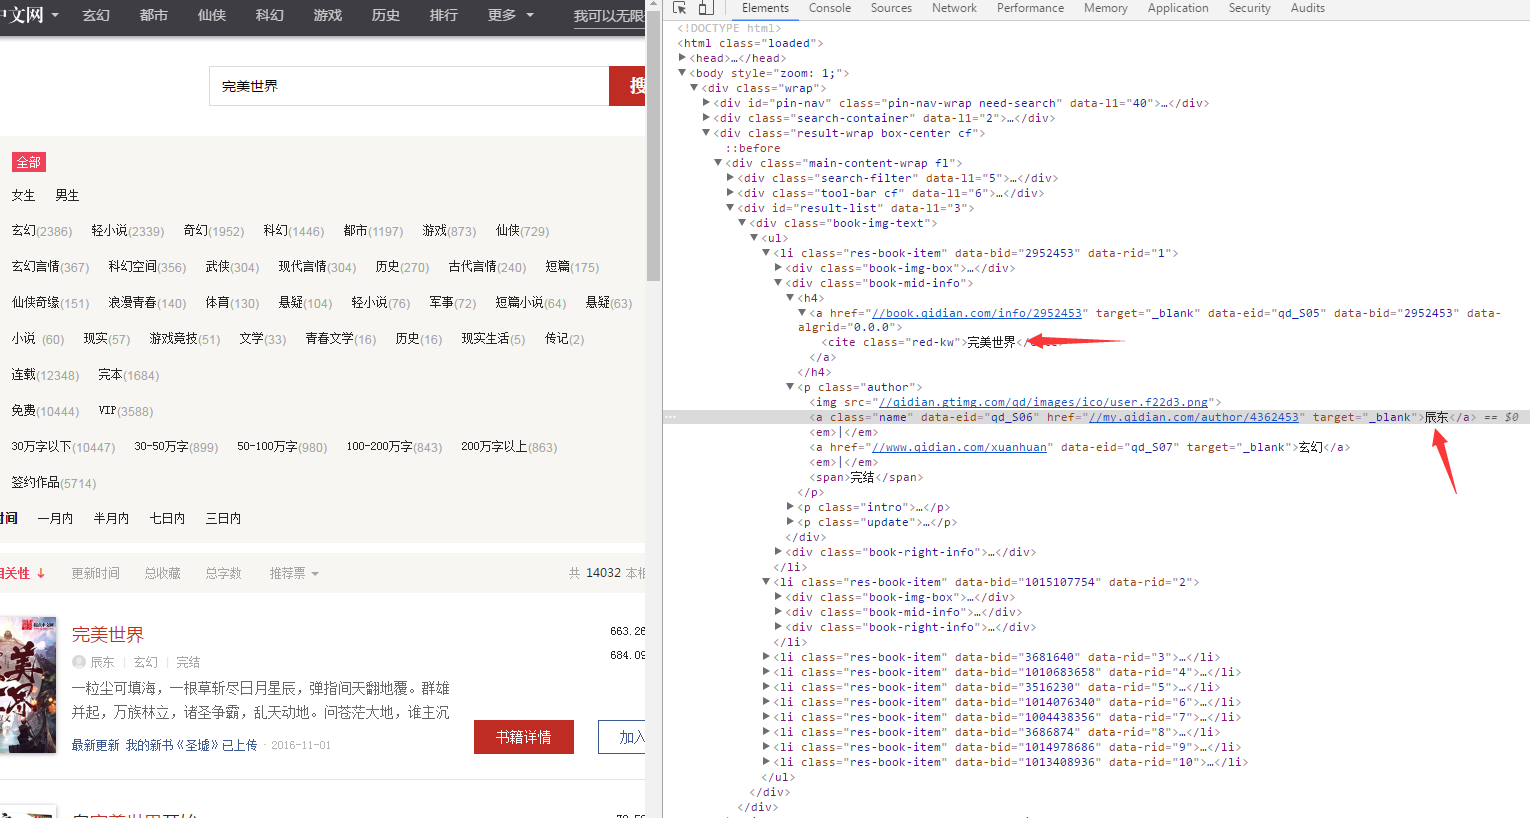
下面具体看代码解释
package com.wpb.dao;

import java.io.IOException;

import org.jsoup.Connection;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

import com.wpb.bean.Book;

public class test {

    public static void main(String[] args) throws IOException {

        //要爬取的网站

        String url = "https://www.qidian.com/search?kw=完美世界";

        //获得一个和网站的链接,注意是Jsoup的connect

        Connection connect = Jsoup.connect(url);

        //获得该网站的Document对象

        Document document = connect.get();

        int cnt = 1;

        //我们可以通过对Document对象的select方法获得具体的文本内容

        //下面的意思是获得.bool-img-text这个类下的 ul 下的 li

        Elements rootselect = document.select(".book-img-text ul li");

        for(Element ele : rootselect){

            //然后获得a标签里面具体的内容

            Elements novelname = ele.select(".book-mid-info h4 a");

            String name  = novelname.text();

            Elements author = ele.select(".book-mid-info p a");

            String authorname = author.first().text();

            Elements sumadvice = ele.select(".total p");

            String sum = sumadvice.last().text();

            System.out.println("书名:"+name+" 作者:"+authorname+" 推荐量:"+sum);

        }

    }

}
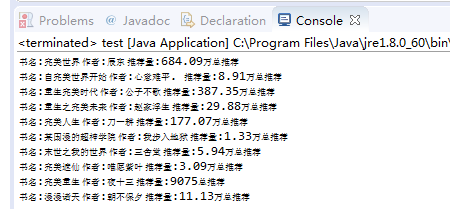
上面的一个例子差不多是Jsoup的一个简单应用
下面来个Httpclient的简单应用,我觉得这个就是简单地模拟一下浏览器访问这样的形式获取信息
网站是这个
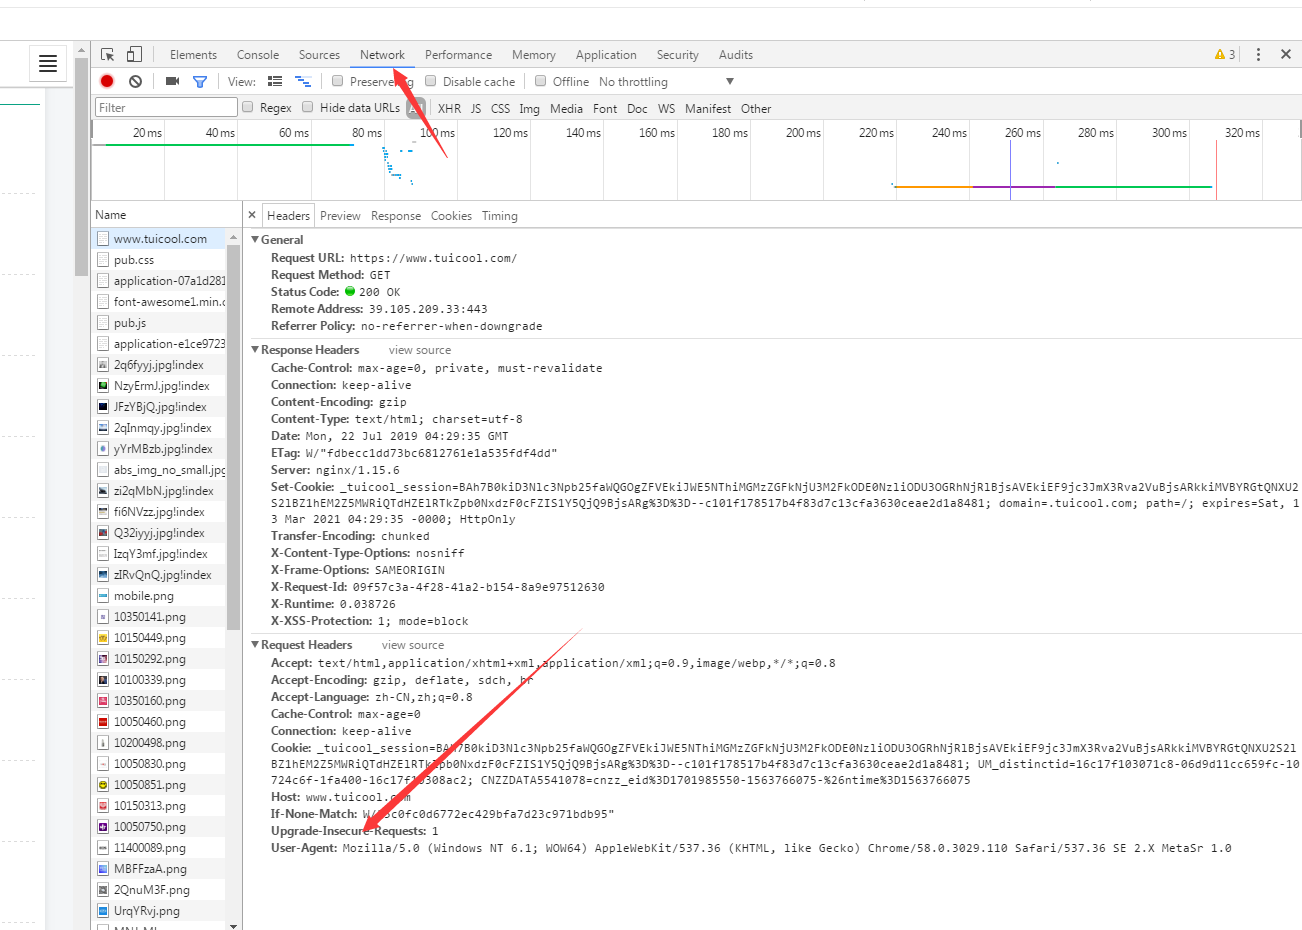
那么既然是模拟浏览器访问,就要设置Header来给人家网站说明一些信息
依然是F12然后点network,按F5找一个User-agent
package com.wpb.service;

import java.io.IOException;

import org.apache.http.HttpEntity;

import org.apache.http.client.ClientProtocolException;

import org.apache.http.client.methods.CloseableHttpResponse;

import org.apache.http.client.methods.HttpGet;

import org.apache.http.impl.client.CloseableHttpClient;

import org.apache.http.impl.client.HttpClients;

import org.apache.http.util.EntityUtils;

public class httpUtilUse {

    public static void main(String[] args) throws ClientProtocolException, IOException {

        String URL = "https://www.tuicool.com/";

        //创建模拟一个客户端

        CloseableHttpClient client = HttpClients.createDefault();

        //创建一个网站的连接对象

        HttpGet httpGet = new HttpGet(URL);

        //设置一些Header信息,说是从哪个浏览器访问的

        httpGet.setHeader("User-Agent",

                "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0");

        //让客户端开始访问这个网站

        CloseableHttpResponse response = client.execute(httpGet);

        //获取到了该网站页面的html

        HttpEntity entity = response.getEntity();

        //把html转化成String

        String html = EntityUtils.toString(entity);

        System.out.println(html);

        System.out.println("successful");

    }

}
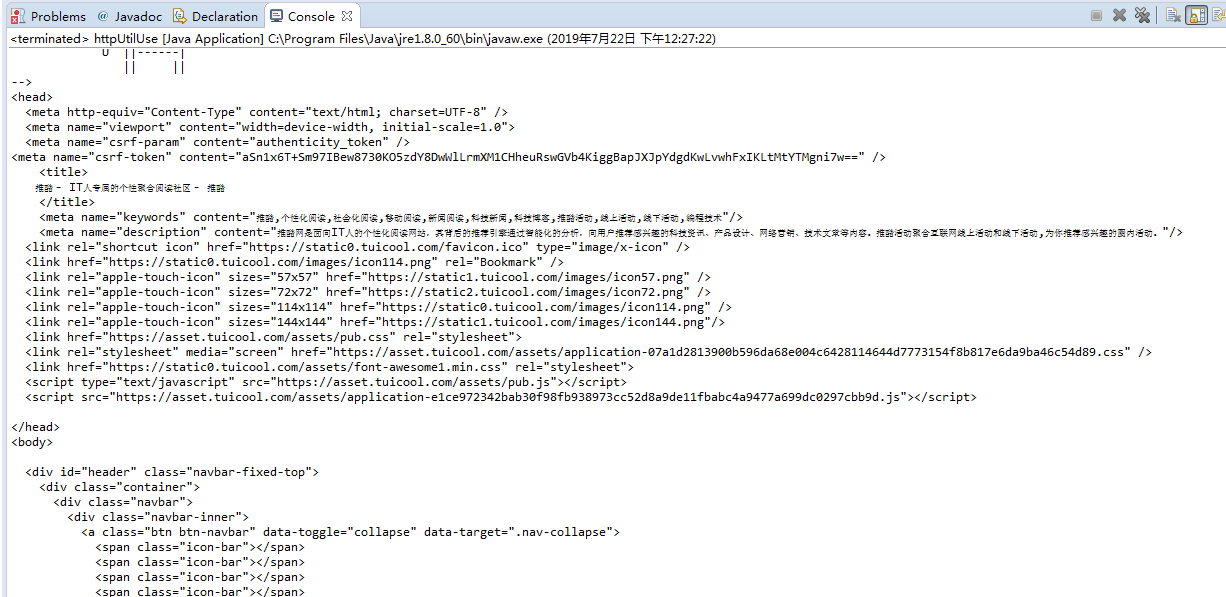
通过这个httpclient我们可以进行一些其他的骚操作
比如下载个图片啥的
package com.wpb.service;

import java.io.File;

import java.io.IOException;

import java.io.InputStream;

import org.apache.commons.io.FileUtils;

import org.apache.http.HttpEntity;

import org.apache.http.client.ClientProtocolException;

import org.apache.http.client.methods.CloseableHttpResponse;

import org.apache.http.client.methods.HttpGet;

import org.apache.http.impl.client.CloseableHttpClient;

import org.apache.http.impl.client.HttpClients;

public class getImage {

    public static void main(String[] args) throws ClientProtocolException, IOException {

        String imgUrl = "http://aimg0.tuicool.com/EzQVN3u.jpg";

        CloseableHttpClient client = HttpClients.createDefault();

        HttpGet httpGet = new HttpGet(imgUrl);

        httpGet.setHeader("User-Agent", "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0");

        CloseableHttpResponse response = client.execute(httpGet);

        HttpEntity entity = response.getEntity();

        //判断获取的信息的类型是什么样婶的

        String fileType = entity.getContentType().getValue();

        //如果这个是image型的

        if(fileType.contains("image")){

            //获取这个东西的字节流

            InputStream inputStream = entity.getContent();

            //直接把他输入到一个路径中

            FileUtils.copyInputStreamToFile(inputStream, new File("d://test.jpeg"));

        }

        response.close();

        client.close();

        System.out.println("successful");

    }

}
把Jsoup和javaIO流结合一下就可以爬取一些你想要的东西了
比如下载一些hdu的问题
package com.wpb.service;

import java.io.BufferedWriter;

import java.io.File;

import java.io.FileWriter;

import java.io.IOException;

import org.jsoup.Connection;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

public class downLoadText {

    public static void main(String[] args) throws IOException {

        String s1 = "http://acm.hdu.edu.cn/showproblem.php?pid=";

        BufferedWriter bw = new BufferedWriter(new FileWriter("C:"+File.separator+"hdu.txt"));

        //循环访问多个问题

        for(int i = 1000; i<= 1099; i++){

            String s2 = s1 + i;

            System.out.println(s2);

            Connection connection = Jsoup.connect(s2);

            Document document = connection.get();

            bw.write("Problem");

            bw.newLine();

            Elements problem = document.select(".panel_content");

            for(Element ele : problem){

                String p = ele.text();

                System.out.println(p);

                bw.write(p);

                bw.newLine();

            }

        }

        bw.flush();

        bw.close();

    }

}
还有还有 比如爬取我老婆照片
package com.wpb.service;

import java.io.File;

import java.io.IOException;

import java.io.InputStream;

import org.apache.commons.io.FileUtils;

import org.apache.http.HttpEntity;

import org.apache.http.client.HttpClient;

import org.apache.http.client.methods.CloseableHttpResponse;

import org.apache.http.client.methods.HttpGet;

import org.apache.http.impl.client.CloseableHttpClient;

import org.apache.http.impl.client.HttpClients;

import org.jsoup.Connection;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

public class getManyImag {

    public static int cnt = 1;

    public static void main(String[] args) throws IOException {

        //分析网页的变化,发现每变化一个网页,url里面就加30

        for (int i = 30; i <= 2010; i += 30) {

            add("http://movie.douban.com/celebrity/1018562/photos/?type=C&start=" + i

                    + "&sortby=like&size=a&subtype=a");

        }

    }

    public static void add(String url) throws IOException {

        //获取链接

        Connection conn = Jsoup.connect(url);

        //获取这个页面内容

        Document document = conn.get();

        //使用Jsoup获取具体内容

        Elements ele = document.select(".cover a img");

        //模拟一个浏览器用户

        CloseableHttpClient client = HttpClients.createDefault();

        for (Element e : ele) {

            //通过Jsoup获取图片的url,我们要获取这个图片的url才能再通过httpclient下载下来

            String imgurl = e.attr("src");

            //设置一个连接对象

            HttpGet httpGet = new HttpGet(imgurl);

            //设置header

            httpGet.setHeader("User-Agent",

                    "Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36");

            //httpclient进行连接

            CloseableHttpResponse response = client.execute(httpGet);

            //获取内容

            HttpEntity entity = response.getEntity();

            //将内容转化成IO流

            InputStream content = entity.getContent();

            //写入

            FileUtils.copyInputStreamToFile(content, new File("c://tu//wpb" + cnt + ".jpg"));

            cnt++;

        }

        System.out.println("successful");

    }

}
完
关于java爬虫以及一些实例的更多相关文章
- Java爬虫系列之实战:爬取酷狗音乐网 TOP500 的歌曲(附源码)
在前面分享的两篇随笔中分别介绍了HttpClient和Jsoup以及简单的代码案例: Java爬虫系列二:使用HttpClient抓取页面HTML Java爬虫系列三:使用Jsoup解析HTML 今天 ...
- Java爬虫系列二:使用HttpClient抓取页面HTML
爬虫要想爬取需要的信息,首先第一步就要抓取到页面html内容,然后对html进行分析,获取想要的内容.上一篇随笔<Java爬虫系列一:写在开始前>中提到了HttpClient可以抓取页面内 ...
- webmagic的设计机制及原理-如何开发一个Java爬虫
之前就有网友在博客里留言,觉得webmagic的实现比较有意思,想要借此研究一下爬虫.最近终于集中精力,花了三天时间,终于写完了这篇文章.之前垂直爬虫写了一年多,webmagic框架写了一个多月,这方 ...
- JAVA爬虫挖取CSDN博客文章
开门见山,看看这个教程的主要任务,就去csdn博客,挖取技术文章,我以<第一行代码–安卓>的作者为例,将他在csdn发表的额博客信息都挖取出来.因为郭神是我在大学期间比较崇拜的对象之一.他 ...
- 爬虫6:多页面增量Java爬虫-sina主页
之前写过很多单页面python爬虫,感觉python还是很好用的,这里用java总结一个多页面的爬虫,迭代爬取种子页面的所有链接的页面,全部保存在tmp路径下. 1 序言 实现这个爬虫需要两个数据结构 ...
- 推荐几个优秀的java爬虫项目
java爬虫项目 大型的: Nutch apache/nutch · GitHub 适合做搜索引擎,分布式爬虫是其中一个功能. Heritrix internetarchive/heritrix3 ...
- Java爬虫搜索原理实现
permike 原文 Java爬虫搜索原理实现 没事做,又研究了一下爬虫搜索,两三天时间总算是把原理闹的差不多了,基本实现了爬虫搜索的原理,本次实现还是俩程序,分别是按广度优先和深度优先完成的,广度优 ...
- Flex通信-与Java实现Socket通信实例
Flex通信-与Java实现Socket通信实例 转自:http://blessht.iteye.com/blog/1136888 博客分类: Flex 环境准备 [服务器端] JDK1.6,“ja ...
- Java的位运算符实例——与(&)、非(~)、或(|)、异或(^)
一.Java的位运算符实例——与(&).非(~).或(|).异或(^) 1.与(&) 0 & 2 = 0 0 0 0 0 1 0 0 1 0 2.非(~) ~0 = 7 0 0 ...
随机推荐
- mysql 的用户权限
查看MySQL的用户权限 show grants for "username"@'host'; 添加新用户 允许本地IP访问localhost:127.0.0.1 use mysq ...
- FastMM、FastCode、FastMove的使用(详细讲解了怎么安装与使用)good
http://blog.csdn.net/akof1314/article/details/6524767
- c# 叫号小程序
写个叫号的小demo 长相如下 代码如下 using System; using System.Collections.Generic; using System.ComponentModel; us ...
- uva10883_Supermean_数学
题目大意:给出n个数,每相邻两个数求平均数,得到n-1个数,再求平均数,得到n-2个数,......一直到最后一个数,输出这个数. 题目很简单,就是中间数据会比较大有点复杂,超过double的范围,而 ...
- asp.net mvc+jquery easyui开发实战教程之网站后台管理系统开发3-登录模块开发
进行本文之前需要在数据库用户表里面增加一条用户数据,直接手动添加即可,未安全考虑密码一定要使用Md5加密后的,这里提供666666的Md5密文为(c831b04de153469d),本文完成登录模块的 ...
- Spring5源码深度分析(二)之理解@Conditional,@Import注解
代码地址: 1.源码分析二主要分析的内容 1.使用@Condition多条件注册bean对象2.@Import注解快速注入第三方bean对象3.@EnableXXXX 开启原理4.基于ImportBe ...
- 升级vue全家桶过程记录
背景 如果你使用了element-ui的el-tabs组件,并且想要单独升级element-ui至2.10.0,你会发现,使用了el-tabs组件的页面只要打开就卡死.原因是element-ui~2. ...
- netty服务端启动--ServerBootstrap源码解析
netty服务端启动--ServerBootstrap源码解析 前面的第一篇文章中,我以spark中的netty客户端的创建为切入点,分析了netty的客户端引导类Bootstrap的参数设置以及启动 ...
- MySQL之SQL优化详解(二)
目录 MySQL之SQL优化详解(二) 1. SQL的执行顺序 1.1 手写顺序 1.2 机读顺序 2. 七种join 3. 索引 3.1 索引初探 3.2 索引分类 3.3 建与不建 4. 性能分析 ...
- C++标准库(体系结构与内核分析)(侯捷第一讲)
一.C++标准库介绍 C++标准库:C++ Standard Library C++标准库与STL有什么关系: STL:Standard Template Library STL包含6大部件,基本占标 ...