
Spark踩坑记:共享变量
收录待用,修改转载已取得腾讯云授权
前言
前面总结的几篇spark踩坑博文中,我总结了自己在使用spark过程当中踩过的一些坑和经验。我们知道Spark是多机器集群部署的,分为Driver/Master/Worker,Master负责资源调度,Worker是不同的运算节点,由Master统一调度。
而Driver是我们提交Spark程序的节点,并且所有的reduce类型的操作都会汇总到Driver节点进行整合。节点之间会将map/reduce等操作函数传递一个独立副本到每一个节点,这些变量也会复制到每台机器上,而节点之间的运算是相互独立的,变量的更新并不会传递回Driver程序。
那么有个问题,如果我们想在节点之间共享一份变量,比如一份公共的配置项,该怎么办呢?Spark为我们提供了两种特定的共享变量,来完成节点间变量的共享。 本文首先简单的介绍spark以及spark streaming中累加器和广播变量的使用方式,然后重点介绍一下如何更新广播变量。
累加器
顾名思义,累加器是一种只能通过关联操作进行“加”操作的变量,因此它能够高效的应用于并行操作中。它们能够用来实现counters和sums。Spark原生支持数值类型的累加器,开发者可以自己添加支持的类型,在2.0.0之前的版本中,通过继承AccumulatorParam来实现,而2.0.0之后的版本需要继承AccumulatorV2来实现自定义类型的累加器。
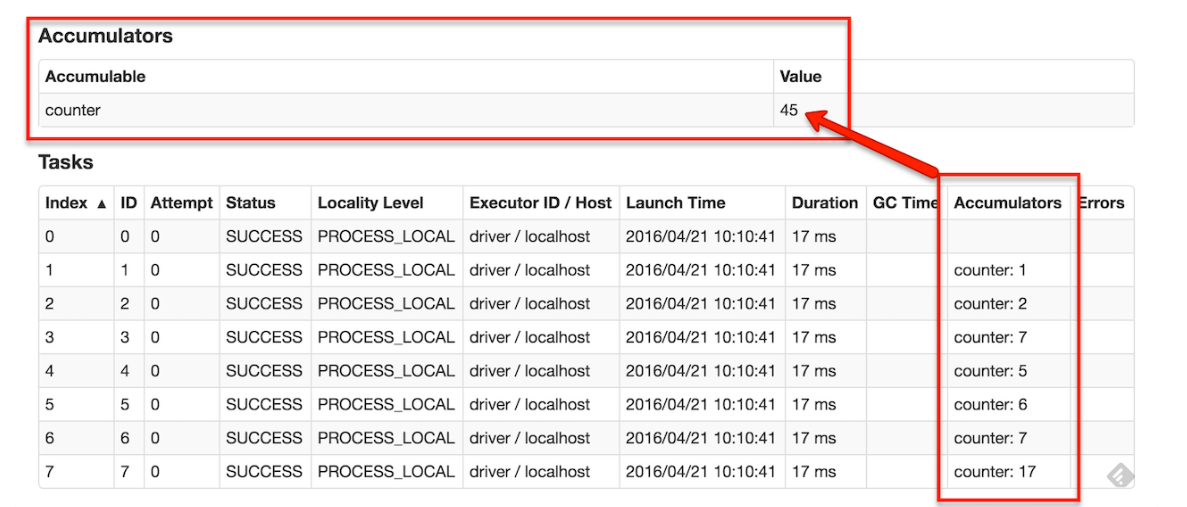
如果创建了一个具名的累加器,它可以在spark的UI中显示。这对于理解运行阶段(running stages)的过程有很重要的作用。如下图:
在2.0.0之前版本中,累加器的声明使用方式如下:
scala> val accum = sc.accumulator(0, "My Accumulator")

accum: spark.Accumulator[Int] = 0

scala> sc.parallelize(Array(1, 2, 3, 4)).foreach(x => accum += x)

...

10/09/29 18:41:08 INFO SparkContext: Tasks finished in 0.317106 s

scala> accum.value

res2: Int = 10
累加器的声明在2.0.0发生了变化,到2.1.0也有所变化,具体可以参考官方文档,我们这里以2.1.0为例将代码贴一下:
scala> val accum = sc.longAccumulator("My Accumulator")

accum: org.apache.spark.util.LongAccumulator = LongAccumulator(id: 0, name: Some(My Accumulator), value: 0)

scala> sc.parallelize(Array(1, 2, 3, 4)).foreach(x => accum.add(x))

10/09/29 18:41:08 INFO SparkContext: Tasks finished in 0.317106 s

scala> accum.value

res2: Long = 10
广播变量
累加器比较简单直观,如果我们需要在spark中进行一些全局统计就可以使用它。但是有时候仅仅一个累加器并不能满足我们的需求,比如数据库中一份公共配置表格,需要同步给各个节点进行查询。OK先来简单介绍下spark中的广播变量:
广播变量允许程序员缓存一个只读的变量在每台机器上面,而不是每个任务保存一份拷贝。例如,利用广播变量,我们能够以一种更有效率的方式将一个大数据量输入集合的副本分配给每个节点。Spark也尝试着利用有效的广播算法去分配广播变量,以减少通信的成本。
一个广播变量可以通过调用SparkContext.broadcast(v)方法从一个初始变量v中创建。广播变量是v的一个包装变量,它的值可以通过value方法访问,下面的代码说明了这个过程:
scala> val broadcastVar = sc.broadcast(Array(1, 2, 3))

broadcastVar: org.apache.spark.broadcast.Broadcast[Array[Int]] = Broadcast(0)

scala> broadcastVar.value

res0: Array[Int] = Array(1, 2, 3)
从上文我们可以看出广播变量的声明很简单,调用broadcast就能搞定,并且scala中一切可序列化的对象都是可以进行广播的,这就给了我们很大的想象空间,可以利用广播变量将一些经常访问的大变量进行广播,而不是每个任务保存一份,这样可以减少资源上的浪费。
更新广播变量(rebroadcast)
广播变量可以用来更新一些大的配置变量,比如数据库中的一张表格,那么有这样一个问题,如果数据库当中的配置表格进行了更新,我们需要重新广播变量该怎么做呢。上文对广播变量的说明中,我们知道广播变量是只读的,也就是说广播出去的变量没法再修改,那么我们应该怎么解决这个问题呢?
答案是利用spark中的unpersist函数
Spark automatically monitors cache usage on each node and drops out old data partitions in a least-recently-used (LRU) fashion. If you would like to manually remove an RDD instead of waiting for it to fall out of the cache, use the RDD.unpersist() method.
上文是从spark官方文档摘抄出来的,我们可以看出,正常来说每个节点的数据是不需要我们操心的,spark会自动按照LRU规则将老数据删除,如果需要手动删除可以调用unpersist函数。
那么更新广播变量的基本思路:将老的广播变量删除(unpersist),然后重新广播一遍新的广播变量,为此简单包装了一个用于广播和更新广播变量的wraper类,如下:
import java.io.{ ObjectInputStream, ObjectOutputStream }

import org.apache.spark.broadcast.Broadcast

import org.apache.spark.streaming.StreamingContext

import scala.reflect.ClassTag

// This wrapper lets us update brodcast variables within DStreams' foreachRDD

// without running into serialization issues

case class BroadcastWrapper[T: ClassTag](

    @transient private val ssc: StreamingContext,

    @transient private val _v: T) {

  @transient private var v = ssc.sparkContext.broadcast(_v)

  def update(newValue: T, blocking: Boolean = false): Unit = {

    // 删除RDD是否需要锁定

    v.unpersist(blocking)

    v = ssc.sparkContext.broadcast(newValue)

  }

  def value: T = v.value

  private def writeObject(out: ObjectOutputStream): Unit = {

    out.writeObject(v)

  }

  private def readObject(in: ObjectInputStream): Unit = {

    v = in.readObject().asInstanceOf[Broadcast[T]]

  }

}
利用该wrapper更新广播变量,大致的处理逻辑如下:
// 定义

val yourBroadcast = BroadcastWrapper[yourType](ssc, yourValue)

yourStream.transform(rdd => {

  //定期更新广播变量

  if (System.currentTimeMillis - someTime > Conf.updateFreq) {

    yourBroadcast.update(newValue, true)

  }

  // do something else

})
总结
spark中的共享变量是我们能够在全局做出一些操作,比如record总数的统计更新,一些大变量配置项的广播等等。而对于广播变量,我们也可以监控数据库中的变化,做到定时的重新广播新的数据表配置情况,另外我使用上述方式,在每天千万级的数据实时流统计中表现稳定,所以有相似问题的同学也可以进行尝试,有任何问题,欢迎随时骚扰沟通v
广告下我们项目:专注于游戏舆情的挖掘分析,欢迎大家来踩踩
参考文献
Spark Programming Guide2.1.0
Spark Programming Guide1.6.3
共享变量
How can I update a broadcast variable in spark streaming?
原文链接:https://www.qcloud.com/community/article/407582
Spark踩坑记:共享变量的更多相关文章
- Spark踩坑记——共享变量
[TOC] 前言 Spark踩坑记--初试 Spark踩坑记--数据库(Hbase+Mysql) Spark踩坑记--Spark Streaming+kafka应用及调优 在前面总结的几篇spark踩 ...
- Spark踩坑记——Spark Streaming+Kafka
[TOC] 前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark strea ...
- Spark踩坑记——数据库(Hbase+Mysql)
[TOC] 前言 在使用Spark Streaming的过程中对于计算产生结果的进行持久化时,我们往往需要操作数据库,去统计或者改变一些值.最近一个实时消费者处理任务,在使用spark streami ...
- Spark踩坑记——从RDD看集群调度
[TOC] 前言 在Spark的使用中,性能的调优配置过程中,查阅了很多资料,之前自己总结过两篇小博文Spark踩坑记--初试和Spark踩坑记--数据库(Hbase+Mysql),第一篇概况的归纳了 ...
- [转]Spark 踩坑记:数据库(Hbase+Mysql)
https://cloud.tencent.com/developer/article/1004820 Spark 踩坑记:数据库(Hbase+Mysql) 前言 在使用Spark Streaming ...
- Spark踩坑记——数据库(Hbase+Mysql)转
转自:http://www.cnblogs.com/xlturing/p/spark.html 前言 在使用Spark Streaming的过程中对于计算产生结果的进行持久化时,我们往往需要操作数据库 ...
- Spark踩坑记:Spark Streaming+kafka应用及调优
前言 在WeTest舆情项目中,需要对每天千万级的游戏评论信息进行词频统计,在生产者一端,我们将数据按照每天的拉取时间存入了Kafka当中,而在消费者一端,我们利用了spark streaming从k ...
- Spark踩坑记——初试
[TOC] Spark简介 整体认识 Apache Spark是一个围绕速度.易用性和复杂分析构建的大数据处理框架.最初在2009年由加州大学伯克利分校的AMPLab开发,并于2010年成为Apach ...
- 【踩坑记】从HybridApp到ReactNative
前言 随着移动互联网的兴起,Webapp开始大行其道.大概在15年下半年的时候我接触到了HybridApp.因为当时还没毕业嘛,所以并不清楚自己未来的方向,所以就投入了HybridApp的怀抱. Hy ...
随机推荐
- web服务端安全之文件上传漏洞
一.文件上传漏洞的原理 由于程序代码未对用户提交的文件进行严格的分析和检查,导致攻击者可以上传可执行的代码文件,从而获取web应用的控制权限. 常见于上传功能,富文本编辑器. 二.文件上传漏洞的防御 ...
- 【推导】【数学期望】【冒泡排序】Petrozavodsk Winter Training Camp 2018 Day 5: Grand Prix of Korea, Sunday, February 4, 2018 Problem C. Earthquake
题意:两地之间有n条不相交路径,第i条路径由a[i]座桥组成,每座桥有一个损坏概率,让你确定一个对所有桥的检测顺序,使得检测所需的总期望次数最小. 首先,显然检测的时候,是一条路径一条路径地检测,跳跃 ...
- zookeeper【3】服务发现
服务发现:指对集群中的服务上下线做统一管理,每个工作服务器都可以作为数据的发布方,向集群注册自己的基本信息,而让某些监控服务器作为订阅方,订阅工作服务器的基本信息.当工作服务器的基本信息改变时,如服务 ...
- bzoj1477 poj1061 青蛙的约会
Description 两只青蛙在网上相识了,它们聊得很开心,于是觉得很有必要见一面.它们很高兴地发现它们住在同一条纬度线上,于是它们约定各自朝西跳,直到碰面为止.可是它们出发之前忘记了一件很重要的事 ...
- FindWindow和FindWindowEx
函数原型:FindWindow(lpszClassName,lpszWindowName) 参数:lpszClassName--窗口类名;lpszWindowName--窗口标题 功能:查找窗口,未找 ...
- 通过IP获取所在城市
<script type="text/javascript"> var map = new BMap.Map("allmap"); var poin ...
- ROS知识(19)----写一个简单的pluginlib例子
参考资料: 官方教程:Writing and Using a Simple Plugin
- 电子数据识别软件ABBYY FineReader
ABBYY 是一家俄罗斯软件公司,在文档识别,数据捕获和语言技术的开发中居世界领先地位.其获奖产品 FineReader OCR 软件可以把静态纸文件和 PDF 文件转换成可管理的电子数据,可以大大节 ...
- Apache 如何反向代理tomcat并且实现Session保持
简介 LAMT=Linux+Apache+MySQL+Tomcat: Tomcat 服务器是一个免费的开放源代码的Web 应用服务器,属于轻量级应用服务器: 在中小型系统和并发访问用户不是很多的场合下 ...
- 【我所认知的BIOS】—> uEFI AHCI Driver(5) — 第一个protocol最终要開始安装了
[我所认知的BIOS]-> uEFI AHCI Driver(5) - 第一个protocol最终要開始安装了 LightSeed 4/28/2014 文章对EFI_DRIVER_BINDING ...